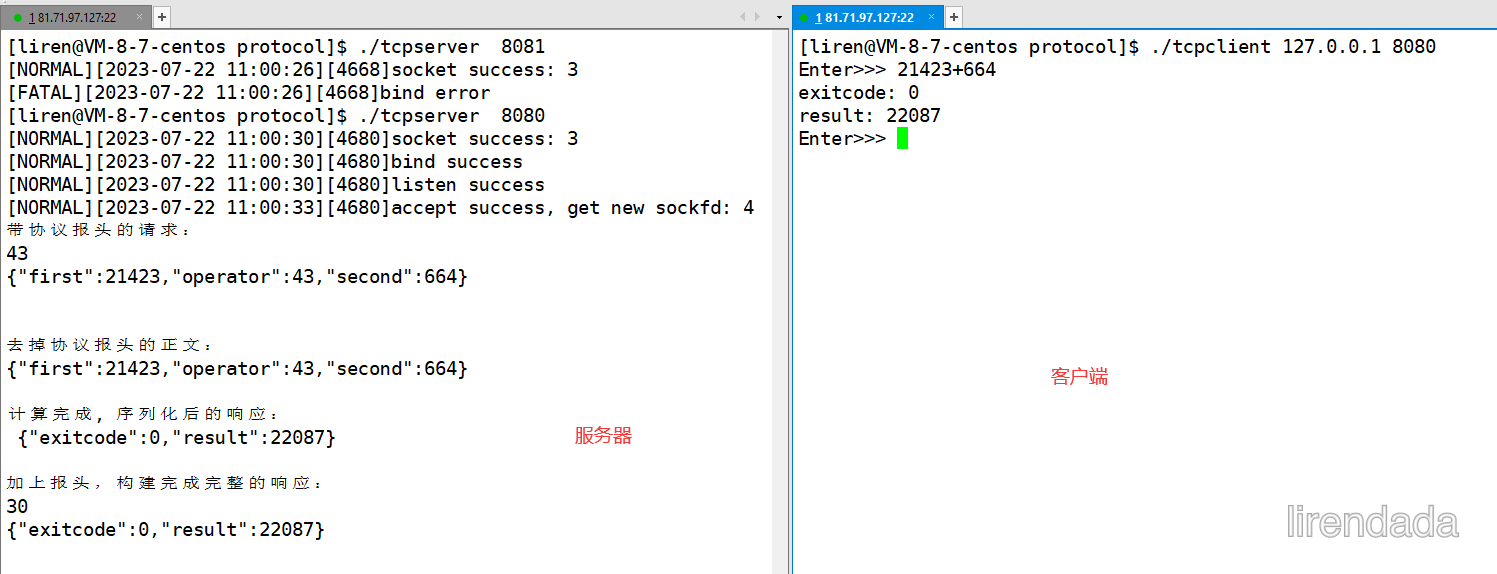
协议(protocol)是一种规范或约定,用于定义计算机系统或网络设备之间进行通信和交互的方式,确保数据的正确传输和处理。它定义了数据的格式、传输方式、错误处理、身份验证、安全性等方面的规范,以确保不同设备之间能够正确地交换信息。
协议可以被视为一种通信的语言,它使得不同的计算机系统、应用程序或网络设备能够相互理解和协同工作。通过遵循相同的协议,发送方和接收方能够按照预定的规则进行数据传输和交互,从而实现有效的通信。
计算机中的协议可以涵盖各种不同的领域,如网络通信协议(如TCP/IP、HTTP、FTP)、电子邮件协议(如SMTP、POP3、IMAP)、域名解析协议(如DNS)等。每个协议都有自己的规范和特定的功能,以满足特定的通信需求。
Ⅱ. 序列化和反序列化
序列化: 序列化是将对象转换为字节流的过程,以便可以在网络上传输或将其保存到文件中。在序列化过程中,对象的状态(即属性和数据)被转换为字节序列,可以按照一定的格式进行编码。
反序列化: 反序列化是将字节流转换回对象的过程,使其可以在程序中继续使用。在反序列化过程中,字节序列被解码,并根据序列化时的规则和格式重新构建为原始对象。
例如聊天软件发送一条消息,会将头像、昵称、消息内容、发送时间等“结构化”数据进行序列化,形成一个字节流报文,通过网络将该报文发送给接收方,接收方进行反序列化将报文重新拆解为头像、昵称、消息内容、发送时间等“结构化”数据。
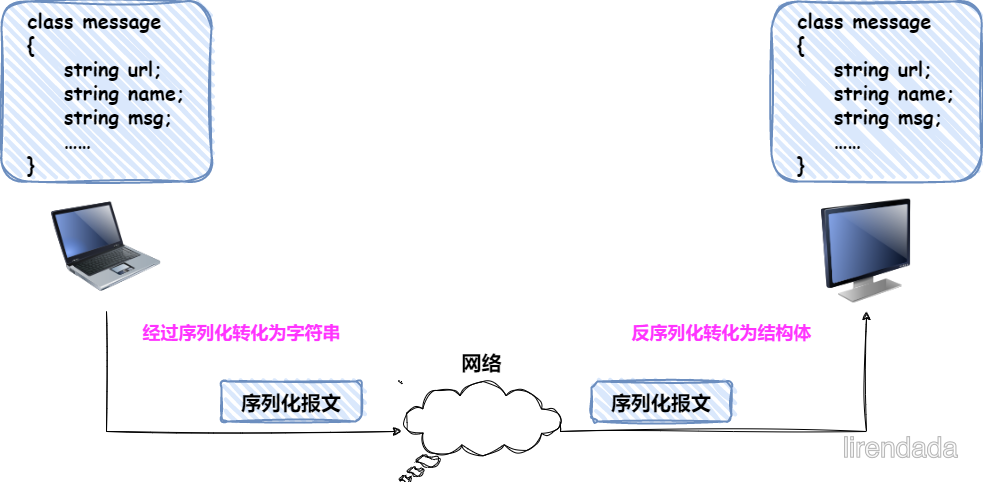
而 OSI 七层模型中表示层的作用就是:实现设备固有数据格式和网络标准数据格式的转换。其中设备固有的数据格式指的是数据在应用层上的格式,而网络标准数据格式则指的是序列化之后可以进行网络传输的数据格式。
并且序列化通常是将对象转换为二进制序列,而不是普通的文本内容。序列化的目的是将对象的状态以二进制形式进行编码,以便在存储或传输过程中能够保持数据的完整性和结构。因为二进制序列化可以更有效地表示对象的属性和数据,因为它可以直接映射到内存中的二进制表示形式。相比之下,将对象转换为普通文本内容可能需要更多的字符和格式化信息,从而增加了存储和传输的开销。
序列化和反序列化的应用如下所示:
- 数据存储和传输:通过序列化,可以将对象转换为字节流,然后将其保存到文件中或通过网络传输。反序列化可以将字节流转换回对象,以便在另一个系统或程序中使用。
- 远程过程调用(
RPC):在分布式系统中,可以使用序列化和反序列化来在客户端和服务器之间传递对象。客户端将对象序列化并发送到服务器,服务器将其反序列化并执行相应的操作,然后将结果序列化并返回给客户端。- 缓存和持久化:通过将对象序列化并保存到磁盘或缓存中,可以在需要时快速恢复对象,而无需重新计算或重新获取数据。
以下是一些常见的序列化工具:
- JSON(
JavaScript Object Notation):JSON是一种轻量级的数据交换格式,广泛用于Web应用程序中。许多编程语言都提供了JSON的序列化和反序列化支持,可以将对象转换为JSON字符串,并将其解析回对象。 - XML(
eXtensible Markup Language):XML是一种可扩展的标记语言,用于表示结构化数据。类似于JSON,许多编程语言提供了XML的序列化和反序列化支持,可以将对象转换为XML格式,并将其解析回对象。 - protobuf(
Protocol Buffers):protobuf是一种由Google开发的高效的二进制序列化格式。它使用简单的接口定义语言(IDL)来定义数据结构,并生成相应的代码用于序列化和反序列化。 - MessagePack:
MessagePack是一种高效的二进制序列化格式,可以在多种编程语言之间进行数据交换。它具有较小的序列化尺寸和较快的序列化/反序列化速度。 - BSON(
Binary JSON):BSON是一种二进制表示的JSON格式,用于在MongoDB数据库中存储和传输数据。它支持更多的数据类型和功能,比JSON更适合在数据库中进行序列化。
这只是一些常见的序列化工具和格式,每种工具都有其特定的用途和优势。选择适合您需求的序列化工具时,需要考虑数据大小、性能、跨平台兼容性以及易用性等因素。
Ⅲ. 自定义协议实现一个网络版计算器
1、目标
首先,这篇笔记的重点是掌握协议到底要我们干什么,本质上无非就是对报文添加一些规则,使其更方便接收和识别等。所以我们的重点是自定义一个协议来学习协议的大体实现流程,所以业务处理不是重点,那我们就要尽量的简单,减少学习成本,所以选择一个计算器!
此外,我们还会先自己手写请求和响应各自的序列化和反序列化接口,这是在我们设定传输数据的格式的基础之上,我们也不会搞的太复杂,只需要大体了解序列化和反序列的过程即可。而之后我们就会直接使用 jsoncpp 库中的接口实现序列化和反序列化操作,体现它们的便捷性!
2、搭建服务器
① 服务器调用逻辑
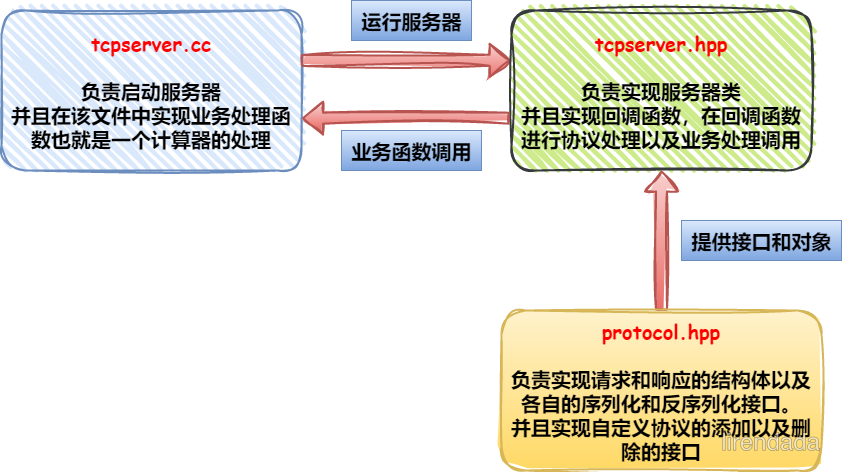
有些人可能问,为什么不直接将业务处理函数直接在所谓的回调函数中实现呢,因为一个项目,最重要的一点就是要解耦,回调函数中我们不仅仅要做业务处理,还要进行收发消息、自定义协议处理、序列化、反序列化等操作,那这样子如果业务处理都放在里面实现而不是单独作为一个接口出来,那么后面 debug 和维护的时候就会头疼了,总的来说,就是为了解耦!
② 服务器类实现 -- tcpserver.hpp
首先,我们直接拿之前写过的 tcp 服务器类的实现过来用,并且这里使用的是多进程版本,其实哪个版本都一样,这里的主要目的是为了学习自定义协议,所以我们的重点应该放在协议上面!
其次,handlerEntery() 函数就是服务器要调用的回调函数,这个函数负责收发消息、自定义协议处理、序列化、反序列化、业务逻辑处理!听起来要完成很多功能,实则这些功能其实我们是放在 protocol.hpp 中实现的,我们只需要在回调函数中进行接口的调用即可!
此外,为了回调函数和服务器类解耦,一般将其放在类外实现,或者单独为其创建一个头文件来实现,这里直接放在类外实现!
所以这里的重点就是实现 handlerEntery(),这个我们下面再讲!
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <cstring>
#include <unistd.h>
#include <arpa/inet.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <arpa/inet.h>
#include <netinet/in.h>
#include <sys/wait.h>
#include <signal.h>
#include "log.hpp"
#include "protocol.hpp"
using namespace std;

namespace Server
{
    enum {
        SOCKET_ERR = 1,
        BIND_ERR,
        LISTEN_ERR,
        ACCEPT_ERR,
        READ_ERR,
        WRITE_ERR,
    };
    const int gbacklog = 5;
    const uint16_t gport = 8080;

    // req:请求结构体,输入型参数
    // resp:响应结构体,输出型参数
    typedef function<bool(const Request& req, Response& resp)> func_t;

    // 处理函数在类外实现,保证与服务器解耦
    void handlerEntery(int sockfd, func_t func)
    {}

    class tcpServer
    {
    private:
        uint16_t _port;
        int _listenfd;

    public:
        tcpServer(const uint16_t& port = gport) : _port(port), _listenfd(0)
        {}

        void initServer()
        {
            // 1.创建套接字
            _listenfd = socket(AF_INET, SOCK_STREAM, 0);
            if(_listenfd == -1)
            {
                logMessage(Level::FATAL, "socket error");
                exit(SOCKET_ERR);
            }
            logMessage(Level::NORMAL, "socket success: %d", _listenfd);

            // 2.绑定信息
            struct sockaddr_in local;
            memset(&local, 0, sizeof local);
            local.sin_family = AF_INET;
            local.sin_port = htons(_port);
            local.sin_addr.s_addr = INADDR_ANY;

            if(bind(_listenfd, (struct sockaddr*)&local, sizeof local) == -1)
            {
                logMessage(Level::FATAL, "bind error");
                exit(BIND_ERR);
            }
            logMessage(Level::NORMAL, "bind success");

            // 3.设置listen监听状态
            if(listen(_listenfd, gbacklog) < 0)
            {
                logMessage(Level::FATAL, "listen error");
                exit(LISTEN_ERR);
            }
            logMessage(Level::NORMAL, "listen success");
        }

        void start(func_t func)
        {
            signal(SIGCHLD, SIG_IGN);
            while(true)
            {
                // 4.若监听到客户端的信息之后,进行accept
                struct sockaddr_in peer;
                socklen_t len = sizeof(peer);
                int server_sockfd = accept(_listenfd, (struct sockaddr*)&peer, &len);
                if(server_sockfd == -1)
                {
                    logMessage(Level::ERROR, "accept error");
                    continue;
                }
                logMessage(Level::NORMAL, "accept success, get new sockfd: %d", server_sockfd);

                // 多进程版本
                pid_t id= fork();
                if(id == 0)
                {
                    close(_listenfd); // 子进程关闭监听描述符
                    handlerEntery(server_sockfd, func); 	// 这步就是执行服务器的回调处理函数
                    close(server_sockfd); // 业务处理结束后关闭通信描述符
                    exit(0);
                }
                // 父进程关闭通信描述符
                close(server_sockfd);
            }
        }
    };
}
③ 服务器主函数实现 -- tcpserver.cc
这也没啥好说的,看上面的流程图就知道这里的 cal() 函数就是真正的业务处理函数,一般来说可以单独为其创建一个头文件来实现,但是这里直接将其放在主函数中实现了!
#include "tcpserver.hpp"
#include <memory>
using namespace Server;

// req:  里面一定是我们的处理好的一个完整的请求对象
// resp: 根据req中的数据,计算处理后填充resp进行返回
// 不用管理任何读取和写入、序列化和反序列化等任何细节,这只是业务处理函数!
bool cal(const Request &req, Response &resp)
{}

void Usage(string proc)
{
    cout << "Please follow the true usage:\n\t" << proc << " server_port\n";
}

int main(int argc, char* argv[])
{
    if(argc != 2)
    {
        Usage(argv[0]);
        exit(1);
    }
    uint16_t port = atoi(argv[1]);

    unique_ptr<tcpServer> tcpserver(new tcpServer(port));
    tcpserver->initServer();
    tcpserver->start(cal);
    return 0;
}
3、搭建客户端
① 客户端调用逻辑
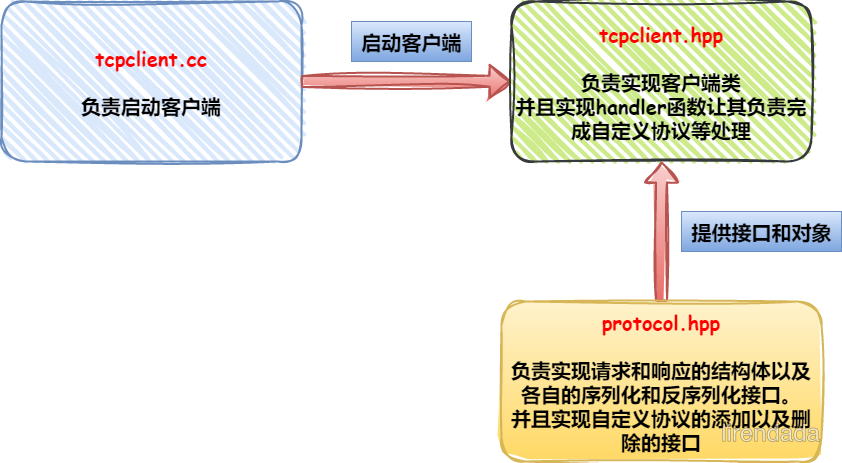
客户端的调用其实要比服务器简单,因为只需要完成自定义协议和序列化等操作即可!
② 客户端类实现 -- tcpclient.hpp
可以看到我们的重点放在 handler() 上,由它来实现客户端的收发数据、序列化、自定义协议等操作!并且把它放到类外来实现,达到解耦的目的!
#pragma once
#include <iostream>
#include <string>
#include <cstring>
#include <unistd.h>
#include <arpa/inet.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <arpa/inet.h>
#include <netinet/in.h>
#include "protocol.hpp"
#include "log.hpp"
using namespace std;

namespace Client
{
    const int NUM = 1024;

    // 处理函数在类外实现,保证与服务器解耦
    void handler(int sockfd)
    {}

    class tcpClient
    {
    private:
        int _socketfd;
        string _destip;
        uint16_t _destport;

    public:
        tcpClient(const string& ip, const uint16_t& port)
            :_destip(ip), _destport(port), _socketfd(0)
        {}

        void initClient()
        {
            // 1.创建套接字
            _socketfd = socket(AF_INET, SOCK_STREAM, 0);
            if(_socketfd < 0)
            {
                std::cerr << "socket create error" << std::endl;
                exit(2);
            }
            // 2. tcp客户端不需要手动bind
        }

        void run()
        {
            struct sockaddr_in server;
            memset(&server, 0, sizeof server);
            server.sin_family = AF_INET;
            server.sin_port = htons(_destport);
            server.sin_addr.s_addr = inet_addr(_destip.c_str());

            // 使用connect函数发送建立连接请求
            int n = connect(_socketfd, (struct sockaddr*)&server, sizeof server);
            if(n == -1)
                logMessage(Level::ERROR, "socket connect error!");
            else
                handler(_socketfd); // 直接调用处理函数
        }

        ~tcpClient()
        {
            if(_socketfd >= 0)
                close(_socketfd);
        }
    };
}
③ 客户端主函数实现 -- tcpclient.cc
#include "tcpclient.hpp"
#include <memory>
using namespace Client;

void Usage(string proc)
{
    cout << "Please follow the true usage:\n\t" << proc << " dest_ip dest_port\n\n";
}

int main(int argc, char* argv[])
{
    if(argc != 3)
    {
        Usage(argv[0]);
        exit(1);
    }
    string ip = argv[1];
    uint16_t port = atoi(argv[2]);

    unique_ptr<tcpClient> tcpclient(new tcpClient(ip, port));
    tcpclient->initClient();
    tcpclient->run();
    return 0;
}
4、自定义协议 -- protocol.hpp
以下类和函数的实现都在同一个头文件中!
① 请求类及其序列化、反序列化的实现
首先请求对象一般是由客户端发给服务端的,而发送的请求中,是根据我们实现的业务处理来的,我们这里的业务是一个简单计算器,所以需要两个操作数和一个操作符作为请求类的成员变量,而成员函数就是序列化和反序列化的接口!
下面的序列化和反序列化是我们自己实现的,其实很简单,序列化就是将类的成员变量组织成一个字符串进行发送(不过最好还是转化为二进制比较好),而反序列化就是将已经接收到的字符串,再拆分为我们的成员变量!
所以我们的协议就体现出来了,必须规定好序列化为字符串的格式是什么,这样子我们在反序列化的时候才知道要怎么去拆分!
我们这里序列化的格式就是 "x op y",比较简单!但是在反序列化的时候要注意,两个操作数得先用字符串接收比较好操作,因为有可能字符串是 "x op yyyy" 也就是这些操作数可能是多位数!
剩下的就是一些简单的字符串操作啦,具体参考下面的实现:
const char* SEP = " ";                 // 分隔符,用于区分开序列化之间的字符
const int SEP_LEN = strlen(SEP);	   // 不能使用sizeof

// 请求一般是客户端给服务端的
class Request
{
public:
    int _x;
    int _y;
    char _op; // 运算符
public:
    Request()
        :_x(0), _y(0), _op(0)
    {}
    Request(int x, int y, int op)
        :_x(x), _y(y), _op(op)
    {}

    // 序列化相当于:  结构体 -》 字符串(更正确的说法是字节流)
    // 反序列化相当于:字符串 -》 结构体
    // 有两种方式:
    // 		1. 自己实现功能
    // 		2. 用现成的库函数
    bool serialize(string* out) // out是输出型参数
    {
        // 结构体 -> "x op y"
        *out = ""; // 先清空一下out

        *out += to_string(_x);
        *out += SEP;
        *out += _op;
        *out += SEP;
        *out += to_string(_y);
        return true;
    }

    bool deserialize(const string& in) // in是输入型参数
    {
        // "x op yyyy" -> 结构体
        // 1. 首先找到两个分隔符的位置
        auto left = in.find(SEP);
        auto right = in.rfind(SEP);
        if(left == string::npos || right == string::npos || left == right) // 没有两个空格说明格式错了直接false
            return false;
        if(right - (left+SEP_LEN) != 1) // 规定分隔符必须是一个字符的长度
            return false;

        // 2. 获取x和y的字符串,并且判断是否为空
        string x_string = in.substr(0, left);
        string y_string = in.substr(right + SEP_LEN);
        if(x_string.empty() || y_string.empty())
            return false;

        // 3. 给结构体的成员变量赋值
        _x = stoi(x_string);
        _y = stoi(y_string);
        _op = in[left+SEP_LEN];
        return true;
    }
};
② 响应类及其序列化、反序列化的实现
既然有请求类,那么就得有响应类!响应一般是由服务端发给客户端的,所以我们就要返回客户端想要的结果,也就是业务处理之后的结果,对比到我们的业务处理,就是一个计算器的处理结果。
所以我们的成员变量要有一个计算结果,并且还得有一个退出码,规定退出码为 0 时才是计算成功,因为有可能遇到一些比较刁钻的计算式,比如除零或者模零的计算式,此时就要设置退出码了,非零即代表是计算失败,则此时计算结果是无效的!
另外就是序列化和反序列化的接口,其实和上面是差不多的,并且这里更简单,因为我们处理的只有两个变量,就是简单的字符串操作,具体参考下面的代码:
// 响应一般是服务端发给客户端的
class Response
{
public:
    int _exitcode; // 退出码,规定0表示计算成功,非0表示计算失败
    int _result;   // 计算结果
public:
    Response()
        :_exitcode(0), _result(0)
    {}
    Response(int exitcode, int result)
        :_exitcode(exitcode), _result(result)
    {}

    bool serialize(string* out) // 输出型参数
    {
        // 结构体 -》 "exitcode result"
        *out = ""; // 先清空一下字符串

        // 将类内成员转化为字符串
        *out += to_string(_exitcode);
        *out += SEP;
        *out += to_string(_result);
        return true;
    }
    bool deserialize(const string& in)
    {
        // "exitcode result" -》 结构体
        // 1. 首先找到分隔符
        auto pos = in.find(SEP);
        if(pos == string::npos)
            return false;

        // 2. 获取退出码和计算结果的字符串,并且判断是否为空
        string ec_string = in.substr(0, pos);
        string res_string = in.substr(pos + SEP_LEN);
        if(ec_string.empty() || res_string.empty())
            return false;

        // 3. 给成员变量赋值
        _exitcode = stoi(ec_string);
        _result = stoi(res_string);
        return true;
    }
};
③ 添加自定义协议函数 -- addRule()
终于到了定协议的时候啦,这个函数就是用来为已经序列化后的数据添加咱们的自定义协议的!下图是我们规定的协议格式:
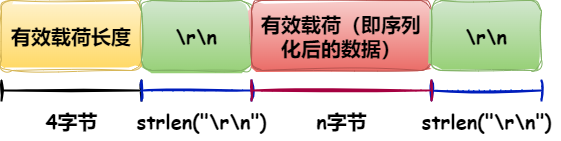
可以看到无非就是加上三个部分,有效载荷长度以及两个 \r\n,比如我们序列化之后的数据为 "x or yyyy",那么添上协议之后就变成 "有效载荷长度"\r\n"x or yyyy"\r\n。
只要协议一旦定好,那么其实添加协议和去除协议就很简单啦,只是字符串操作!
const char* SEP_LINE = "\r\n";         // 行分隔符,用于区分开各报文之间
const int SEP_LINE_LEN = strlen(SEP_LINE);

// 为报文添加自定义首部和尾部的函数
// 自定义首部规则:报文长度+行分隔符"\r\n",比如下面的:
// "x or yyyy"  -->  "有效载荷长度"\r\n"x or yyyy"\r\n
// "exitcode result"  -->  "有效载荷长度"\r\n"exitcode result"\r\n
// 其中有效载荷指的就是"x or yyyy"和"exitcode result"
string addRule(const string& body)
{
    string send_string = to_string(body.size()); // 有效载荷长度
    send_string += SEP_LINE; // 加上行分隔符
    send_string += body;     // 加上有效载荷
    send_string += SEP_LINE; // 加上行分隔符

    return send_string;
}
④ 去除自定义协议函数 -- delRule()
为什么要有取出协议的函数呢,原因很简单,因为我们数据发出去是想要添加协议,而另一方接收数据是需要将协议去掉,因为只需要有效载荷部分即可,所以要有一个取出协议的函数!
只要我们知道了协议的格式,那么去除操作其实就是字符串操作!
代码如下所示:
const char* SEP_LINE = "\r\n";         // 行分隔符,用于区分开各报文之间
const int SEP_LINE_LEN = strlen(SEP_LINE);

// 为报文去掉自定义首部和尾部的函数,比如:
// "有效载荷长度"\r\n"x or yyyy"\r\n  -->  "x or yyyy"
bool delRule(const string& package, string* body)
{
    // 找到第一个分隔符的位置
    auto pos = package.find(SEP_LINE);
    if(pos == string::npos)
        return false;

    // 然后通过前面有效载荷的长度可以直接截取后面有效载荷部分!
    int body_size = stoi(package.substr(0, pos));
    *body = package.substr(pos + SEP_LINE_LEN, body_size);
    return true;
}
💥5、接收完整报文函数 -- recvPackage()
之前有一个棘手的问题我们一直没解决,就是在写 TCP 代码的时候其实也留下了这个坑,就是因为 TCP 是 面向字节流 的,也就是说接收数据的时候,读到的其实都是二进制数据,那么我们怎么保证一次读取就能将一个完整的报文读取上来呢,会不会读取的是缺这缺那的报文呢,对不对!但是这种对于 UDP 来说却是不存在的,因为 UDP 是面向报文的,发的都是以报文为单位的。
不过不怕,现在有了自定义协议,我们就可以根据自定义协议来标识判断当前是否已经读取上来了一个完全的报文!
获取整个报文方法:我们在协议中规定了,首先是一个有效载荷的长度,之后就是一个 \r\n,那么我们可以根据是否出现 \r\n 来获取前面有效载荷长度这部分字段!然后因为有了这个字段,我们就能知道有效载荷的长度了,此时我们就知道了这个报文的总长度,接下来的任务就是读取总长度个字节单位即可获取到整个报文!
剩余的细节在代码中有注释,具体参考代码实现:
// 接收客户端或者服务端发来的报文,该函数的目的是拿到一个完整的报文
// 其中recv_string为输出型参数
bool recvPackage(int sockfd, string& recvbuffer, string* recv_string)
{
    // 为了让接收到的数据出了函数后不丢失,使用static来修饰缓冲区
    // 不过这里也可以选择让recvbuffer被外部所持有,读取时传进来即可,方便外部打印
    // static string recvbuffer;

    char tmpbuffer[1024]; // 应用层接收缓冲区
    while(true)
    {
        ssize_t n = recv(sockfd, tmpbuffer, sizeof(tmpbuffer) - 1, 0);
        if(n > 0)
        {
            tmpbuffer[n] = 0;
            recvbuffer += tmpbuffer; // 进行尾插到缓冲区

            // 根据是否读取到\r\n来进行处理
            auto pos = recvbuffer.find(SEP_LINE);
            if(pos == string::npos)
                continue; // 这步非常的关键,当没读到\r\n的时候说明读取的报文还不完整,则返回上面继续读而不是直接退出

            // 到了此处说明起码拿到了前面有效载荷长度字段了,所以直接将其获取
            int body_size = stoi(recvbuffer.substr(0, pos));

            // 此时有可能正文还没有接收完整,我们要另作判断
            // 如果此时 pos + SEP_LINE_LEN*2 + body_size <= recvbuffer.size() 的话
            // 说明已经至少我们接收到了一个完整的报文!
            // 如果没有的话,我们要继续循环去读取直到该不等式成立
            int package_size = pos + SEP_LINE_LEN*2 + body_size;

            if(package_size > recvbuffer.size())
            {
                cout << "你输入的消息,没有严格遵守我们的协议,正在等待后续的内容, continue" << endl;
                continue; // 继续返回上面进行接收,直到读到一个完整的报文为止
            }

            // 走到这说明起码读到一个完整的报文了
            // 那么就把它拿到,并且记得将其从缓冲区中删去
            *recv_string = recvbuffer.substr(0, package_size);
            recvbuffer.erase(0, package_size);
            break;
        }
        else
        {
            // 异常或者客户端不写了,则退出
            return false;
        }
    }
    return true;
}
6、服务器回调函数实现 -- handlerEntery()
有了上面这些协议的类和函数,我们就能完成前面服务器和客户端中处理函数的坑了!
具体的步骤,参考下面的代码:
void handlerEntery(int sockfd, func_t func)
{
    string recvbuffer; // 应用层的接收缓冲区
    while(true)
    {
        // 1. 读取客户端发来的数据
        //      1.1 你怎么保证你读到的消息是【一个】完整的请求???这由协议头文件中的recvPackage函数帮我们完成
        string recv_string;
        if(!recvPackage(sockfd, recvbuffer, &recv_string))
            return;
        std::cout << "带协议报头的请求:\n" << recv_string << std::endl;

        //      1.2 将接收到的请求去掉协议规则部分即去掉协议报头。这由协议头文件中的delRule函数帮我们完成
        string request_string;
        if(!delRule(recv_string, &request_string))
            return;
        std::cout << "去掉协议报头的正文:\n" << request_string << std::endl;

        // 2. 对请求request进行反序列化,得到一个结构化的请求对象
        Request req;
        if(!req.deserialize(request_string))
            return;

        // 3. 计算处理,通过对象获取对应的数据进行计算,得到一个结构化的响应 --- 业务逻辑
        Response resp;
        func(req, resp); // 通过回调函数实现

        // 4. 对响应response进行序列化,得到一个序列化的“字符串”
        string response_string;
        if(!resp.serialize(&response_string))
            return;
        std::cout << "计算完成, 序列化后的响应:\n " <<  response_string << std::endl;

        // 5. 然后再发送响应
        //      5.1 发送之前先加上自定义协议包头,这由协议头文件中的addRule函数帮我们完成
        string send_string = addRule(response_string);
        std::cout << "加上报头,构建完成完整的响应:\n" <<  send_string << std::endl;

        //      5.2 再将封装好的数据发送出去
        send(sockfd, send_string.c_str(), send_string.size(), 0); // 这里有问题,后面再说
    }
}
7、服务器主函数的业务处理函数实现 -- cal()
其实就是一个简单的计算器!其中我们只要计算出结果,然后填入到 resp 响应对象中即可!
// req: 里面一定是我们的处理好的一个完整的请求对象
// resp: 根据req,进行业务处理填充resp,不用管理任何读取和写入、序列化和反序列化等任何细节
bool cal(const Request &req, Response &resp)
{
    // req已经有结构化完成的数据了,可以直接使用
    resp._exitcode = OK;
    resp._result = OK;

    switch(req._op)
    {
    case '+':
        resp._result = req._x + req._y;
        break;
    case '-':
        resp._result = req._x - req._y;
        break;
    case '*':
        resp._result = req._x * req._y;
        break;
    case '/':
    {
        if(req._y == 0)
            resp._exitcode = DIV_ZERO;
        else
            resp._result = req._x / req._y;
    }
        break;
    case '%':
    {
        if(req._y == 0)
            resp._exitcode = MOD_ZERO;
        else
            resp._result = req._x % req._y;
    }
        break;
    default:
        resp._exitcode = OP_ERROR;
        break;
    }

    return true;
}
8、客户端处理函数实现 -- handler()
其实和服务器的处理函数是差不多的,区别在于客户端就不需要去做业务处理了!
void handler(int sockfd)
{
    string msg;      // 要发送的消息
    string inbuffer; // 接收缓冲区
    while(true)
    {
        cout << "Enter>>> ";
        getline(cin, msg); // 输入的消息形式如"1+1"、"212345*131"

        // 1. 首先客户端肯定是创建请求并且发送给服务端,发送之前要先序列化,
        Request req;
        if(!get_req_from_string(msg, req))
        {
            logMessage(Level::ERROR, "Your expression format input error!"); // 输入格式错误
            continue;
        }
        string send_body;
        if(!req.serialize(&send_body)) // 序列化
        {
            logMessage(Level::ERROR, "serialize error!");
            continue;
        }

        // 2. 然后加上自定义协议再发送
        string send_string = addRule(send_body);
        send(sockfd, send_string.c_str(), send_string.size(), 0); // 这里有问题,后面再说

        // 3. 接收来自服务端的响应,和服务端一样,使用协议头文件中的recvPackage函数来替我们完成即可
        string recv_string;
        if(!recvPackage(sockfd, inbuffer, &recv_string))
            continue;   // 没有读到完整的报文则继续读

        // 4. 读到响应之后进行去除协议
        string recv_body;
        if(!delRule(recv_string, &recv_body)) // 去除协议规则
        {
            logMessage(Level::ERROR, "delRule error!");
            continue;
        }

        // 5. 并且进行反序列化
        Response resp;
        if(!resp.deserialize(recv_body)) // 反序列化
        {
            logMessage(Level::ERROR, "deserialize error!");
            continue;
        }

        // 6. 打印响应报文的数据
        cout << "exitcode: " << resp._exitcode << endl;
        cout << "result: " << resp._result << endl;
    }
}
9、日志打印类实现 -- log.hpp
为了方便调试,这里我们引入了前面写 TCP 服务器时候写的日志打印函数,只不过我们直接向终端打印即可,而不是向文件中打印!
#pragma once
#include <iostream>
#include <string>
#include <cstdarg>
#include <ctime>
#include <unistd.h>
#include <sys/types.h>
using namespace std;
const int NUM = 1024;
enum Level{
DEBUG = 0,
NORMAL,
WARING,
ERROR,
FATAL
};
const char* to_levelstr(int level)
{
switch(level)
{
case DEBUG: return "DEBUG";
case NORMAL: return "NORMAL";
case WARING: return "WARING";
case ERROR: return "ERROR";
case FATAL: return "FATAL";
default: return nullptr;
}
}
// 格式:[日志等级][时间戳/时间][pid][message]
void logMessage(int level, const char* format, ...)
{
// 先将时间戳转化为本地时间然后格式化
char timebuffer[128];
time_t timestamp = time(nullptr); // 获取当前时间戳
struct tm* timeinfo = localtime(×tamp); // 转化为本地时间结构
strftime(timebuffer, sizeof(timebuffer), "%Y-%m-%d %H:%M:%S", timeinfo); // 格式化时间字符串
// 前缀部分,是固定的
char prefixbuffer[NUM];
snprintf(prefixbuffer, sizeof(prefixbuffer), "[%s][%s][%d]", to_levelstr(level), timebuffer, getpid());
// 信息部分,是可变参数的内容
char msgbuffer[NUM];
va_list start;
va_start(start, format);
vsnprintf(msgbuffer, sizeof(msgbuffer), format, start);
// 写到特定等级的文件中去
cout << prefixbuffer << msgbuffer << endl;
}10、makefile文件
cc=g++
.PHONY:all
all:tcpserver tcpclient

tcpclient:tcpclient.cc
	$(cc) -o $@ $^ -std=c++11

tcpserver:tcpserver.cc
	$(cc) -o $@ $^ -std=c++11

.PHONY:clean
clean:
	rm -f tcpserver tcpclient *.txt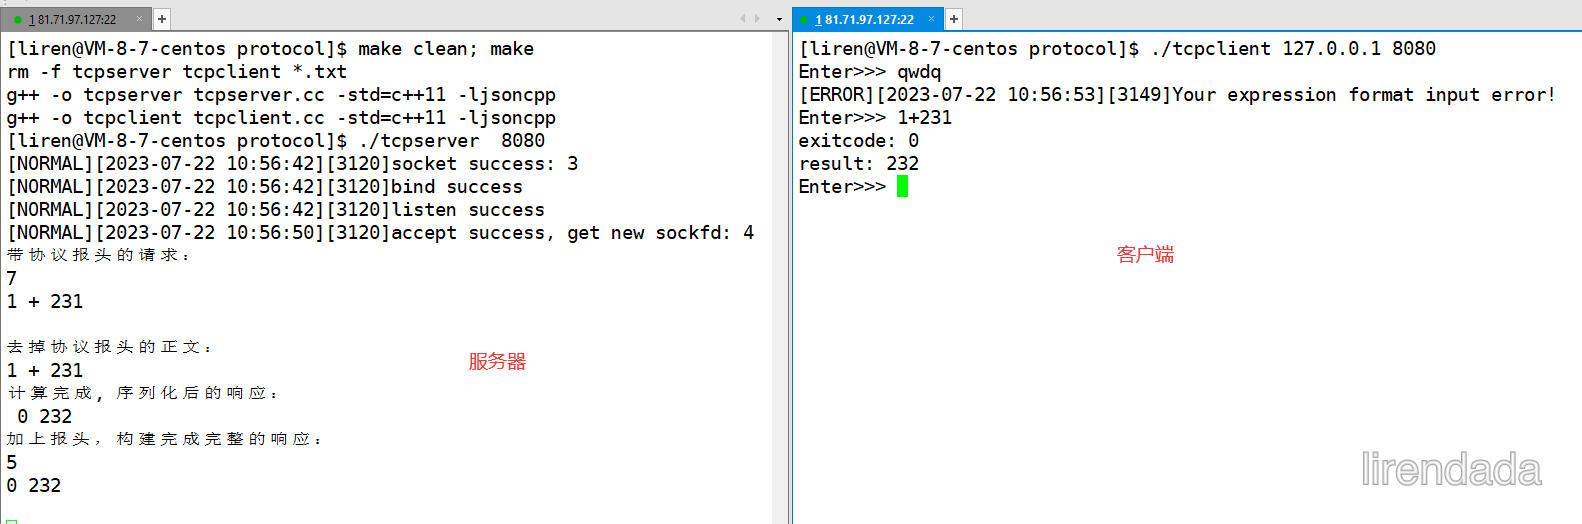
💥所以为什么要定协议呢❓❓❓
这是因为有一些情况,比如就是服务器一般发送消息非常的快,而客户端接收消息的速度其实是有限制的,此时一下子收到一大批字节流,要是没有定制协议的话,这些字节流都是粘在一起的,我们根本无法区分到底是哪个报文段中的数据,所以定制协议是非常重要的。一旦定制了协议,我们就可以在数据中添加一些字段,让上层能识别到当前字节流是哪个数据包等目的!
所以大部分我们使用的应用层协议比如说 http 协议它就定制好了一套协议,如果要使用它的话就得遵守它那一套来!而如果我们自己写一个软件的话,此时就需要我们自己定义一些协议了!
此外还需要强调的是,我们调用的所有发送/接收函数,并不是直接在网络中发送/接收数据,应用层调用的发送/接收函数,本质是一个拷贝函数。
例如客户端发送数据时,应用层调用发送函数将会把应用层的发送缓冲区数据拷贝至传输层的发送缓冲区,而传输层自主决定何时将发送缓冲区的数据发送至网络里,再通过网络发送至服务器的接收缓冲区中,所以 TCP 协议是一种传输控制协议,控制的就是这些缓冲区的收发等情况。
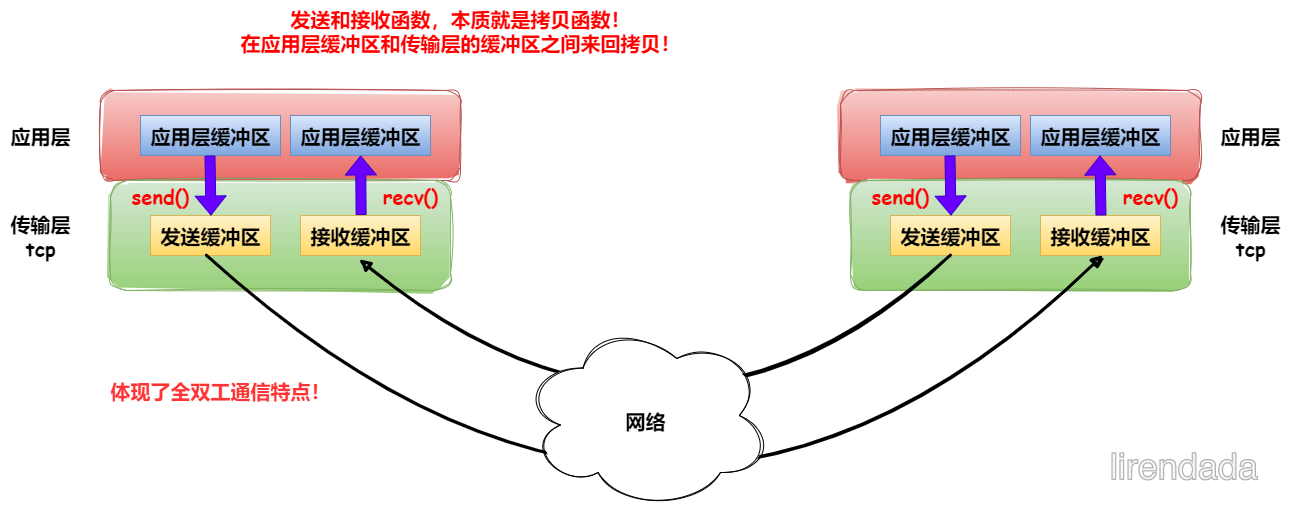
TCP 协议的通信双方的发送缓冲区和接收缓冲区互不干扰,可以双向同时进行通信,所以 TCP 是一种全双工的通信协议。
Ⅳ. 使用Json进行序列化和反序列化
1、jsoncpp库的安装
从上方代码可以看到,使用 string 对象手动进行序列化与反序列化非常麻烦。可以使用 Json 进行序列化与反序列化操作。
Json 是一种轻量级的数据交换格式,常用于 Web 应用程序中的数据传输。它是一种基于文本的格式,易于读写和解析。Json 格式的数据可以被多种编程语言支持,包括 JavaScript、Python、Java、C#、C++ 等。Json 数据由键值对组成,使用大括号表示对象,使用方括号表示数组。
C++ 使用 Json 需要包含 Jsoncpp 库,可以使用 yum 安装 Jsoncpp 库:
sudo yum install -y jsoncpp-devel 安装完之后我们可以到对应路径看看是否存在:
[liren@VM-8-7-centos protocol]$ ls /usr/include/jsoncpp/json/
assertions.h  config.h    forwards.h  reader.h  version.h
autolink.h    features.h  json.h      value.h   writer.h
[liren@VM-8-7-centos protocol]$ ls /lib64/libjsoncpp.so*
/lib64/libjsoncpp.so  /lib64/libjsoncpp.so.0  /lib64/libjsoncpp.so.0.10.5
2、改造自定义协议
具体的使用可以到网上自行查找,其实是比较简单的!注意使用 jsoncpp 库记得在编译时加上 -ljsoncpp。
cc=g++
LD=#-DMYSELF
.PHONY:all
all:tcpserver tcpclient

tcpclient:tcpclient.cc
	$(cc) -o $@ $^ -std=c++11 -ljsoncpp ${LD}

tcpserver:tcpserver.cc
	$(cc) -o $@ $^ -std=c++11 -ljsoncpp ${LD}

.PHONY:clean
clean:
rm -f tcpserver tcpclient *.txt 下面是改造之后的代码:
// 请求一般是客户端给服务端的
class Request
{
public:
    int _x;
    int _y;
    char _op; // 运算符
public:
    Request()
        :_x(0), _y(0), _op(0)
    {}
    Request(int x, int y, int op)
        :_x(x), _y(y), _op(op)
    {}

    // 序列化相当于:  结构体 -》 字符串(更正确的说法是字节流)
    // 反序列化相当于:字符串 -》 结构体
    // 1. 自己实现
    // 2. 用现成的库函数
    bool serialize(string* out) // 输出型参数
    {
#ifdef MYSELF
        // 结构体 -> "x op y"
        *out = ""; // 格式化一下out

        *out += to_string(_x);
        *out += SEP;
        *out += _op;
        *out += SEP;
        *out += to_string(_y);
#else
        // 填写键值对
        Json::Value root;
        root["first"] = _x;
        root["second"] = _y;
        root["operator"] = _op;

        // 选择方式进行序列化
        Json::FastWriter writer;
        // Json::StyledWriter writer;
        *out = writer.write(root);
#endif
        return true;
    }
    bool deserialize(const string& in)
    {
#ifdef MYSELF
        // "x op yyyy" -> 结构体
        // 1.首先找到两个分隔符的位置
        auto left = in.find(SEP);
        auto right = in.rfind(SEP);
        if(left == string::npos || right == string::npos || left == right) // 没有两个空格说明格式错了直接false
            return false;
        if(right - (left+SEP_LEN) != 1) // 规定分隔符必须是一个字符的长度
            return false;

        // 获取x和y的字符串,并且判断是否为空
        string x_string = in.substr(0, left);
        string y_string = in.substr(right + SEP_LEN);
        if(x_string.empty() || y_string.empty())
            return false;

        // 给结构体赋值
        _x = stoi(x_string);
        _y = stoi(y_string);
        _op = in[left+SEP_LEN];
#else
        Json::Reader reader;
        Json::Value root;
        reader.parse(in, root); // 将in中的字符流反序列化到root中

        _x = root["first"].asInt();
        _y = root["second"].asInt();
        _op = root["operator"].asInt(); // 注意这里因为字符也是ASCII码,所以直接转为int即可
#endif
        return true;
    }
};

// 响应一般是服务端发给客户端的
class Response
{
public:
    int _exitcode; // 退出码,规定0表示计算成功,非0表示计算失败
    int _result;   // 计算结果
public:
    Response()
        :_exitcode(0), _result(0)
    {}
    Response(int exitcode, int result)
        :_exitcode(exitcode), _result(result)
    {}

    // 1. 自己实现
    // 2. 用现成的库函数
    bool serialize(string* out) // 输出型参数
    {
#ifdef MYSELF
        // 结构体 -》 "exitcode result"
        *out = ""; // 格式化一下字符串
        // 将类内成员转化为字符串
        *out += to_string(_exitcode);
        *out += SEP;
        *out += to_string(_result);
#else
        Json::Value root;
        root["exitcode"] = _exitcode;
        root["result"] = _result;

        Json::FastWriter writer;
        *out = writer.write(root);
#endif
        return true;
    }
    bool deserialize(const string& in)
    {
#ifdef MYSELF
        // "exitcode result" -》 结构体
        auto pos = in.find(SEP);
        if(pos == string::npos)
            return false;
        string ec_string = in.substr(0, pos);
        string res_string = in.substr(pos + SEP_LEN);
        if(ec_string.empty() || res_string.empty())
            return false;

        _exitcode = stoi(ec_string);
        _result = stoi(res_string);
#else
        Json::Value root;
        Json::Reader reader;
        reader.parse(in, root);

        _exitcode = root["exitcode"].asInt();
        _result = root["result"].asInt();
#endif
        return true;
    }
};