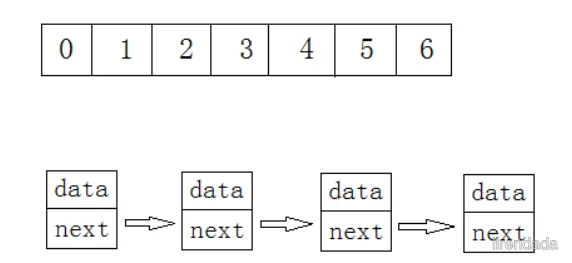
1、树的概念
树是一种非线性的数据结构,它是由n(n>=0)个有限结点组成一个具有层次关系的集合。把它叫做树是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的。
- 有一个特殊的结点,称为根结点,根节点没有前驱结点
- 除根节点外,其余结点被分成M(M>0)个互不相交的集合T1、T2、……、Tm,其中每一个集合Ti(1<= i <= m)又是一棵结构与树类似的子树。每棵子树的根结点有且只有一个前驱,可以有0个或多个后继
- 因此,树是递归定义的。
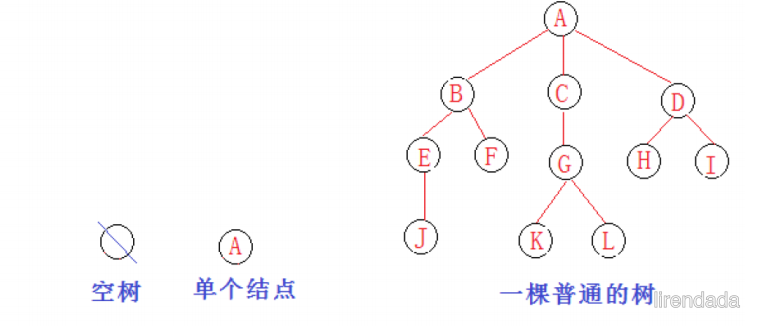
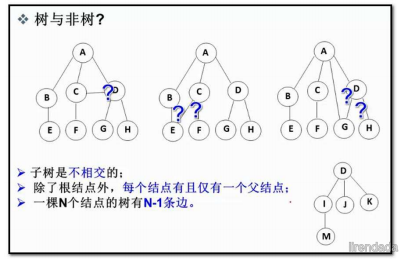
🗡 注意:树形结构中,子树之间不能有交集,否则就不是树形结构
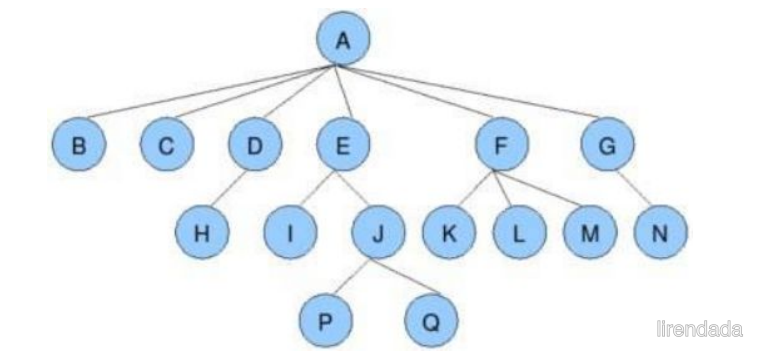
节点的度:一个节点含有的子树的个数称为该节点的度; 如上图:A的度为6
叶节点或终端节点:度为0的节点称为叶节点; 如上图:B、C、H、I...等节点为叶节点
非终端节点或分支节点:度不为0的节点; 如上图:D、E、F、G...等节点为分支节点
双亲节点或父节点:若一个节点含有子节点,则这个节点称为其子节点的父节点; 如上图:A是B的父节点
孩子节点或子节点:一个节点含有的子树的根节点称为该节点的子节点; 如上图:B是A的孩子节点
兄弟节点:具有相同父节点的节点互称为兄弟节点; 如上图:B、C是兄弟节点
树的度:一棵树中,最大的节点的度称为树的度; 如上图:树的度为6
节点的层次:从根开始定义起,根为第1层,根的子节点为第2层,以此类推;
树的高度或深度:树中节点的最大层次; 如上图:树的高度为4
堂兄弟节点:双亲在同一层的节点互为堂兄弟;如上图:H、I互为兄弟节点
节点的祖先:从根到该节点所经分支上的所有节点;如上图:A是所有节点的祖先
子孙:以某节点为根的子树中任一节点都称为该节点的子孙。如上图:所有节点都是A的子孙
森林:由m(m>0)棵互不相交的树的集合称为森林;
2、树的结构表示
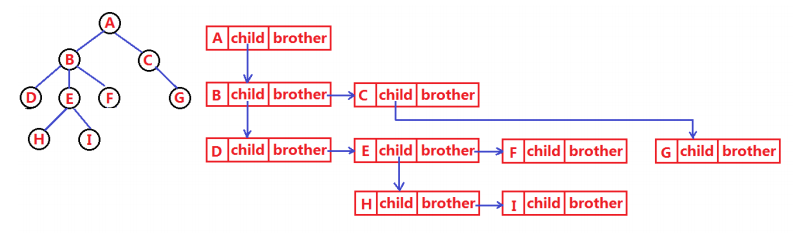
树结构相对线性表就比较复杂了,要存储表示起来就比较麻烦了,实际中树有很多种表示方式,如:双亲表示法,孩子表示法、孩子兄弟表示法等等。我们这里就简单的了解其中最常用的孩子兄弟表示法。
typedef int DataType;
struct Node
{
     struct Node* _firstChild1; // 第一个孩子结点
     struct Node* _pNextBrother; // 指向其下一个兄弟结点
     DataType _data; // 结点中的数据域
};
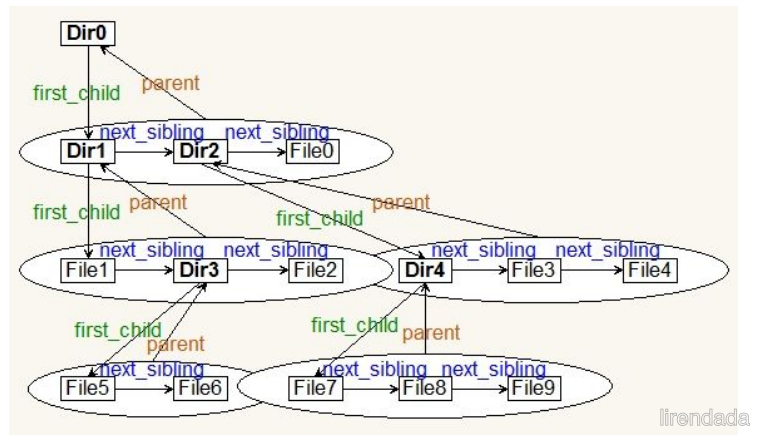
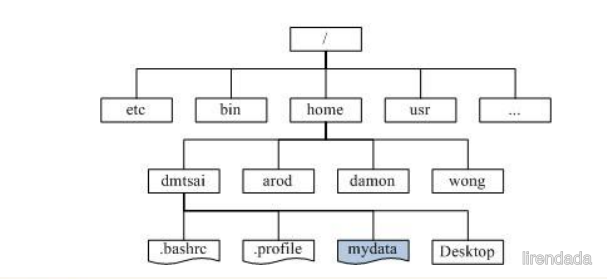
3、树在实际中的运用(表示文件系统的目录树结构)
比如 linux 下的目录结构:
Ⅱ. 二叉树概念及结构
1、概念
一棵二叉树是结点的一个有限集合,该集合或者为空,或者是由一个根节点加上两棵别称为左子树和右子树的二叉树组成。
特点:
-
每个结点最多有两棵子树,即二叉树不存在度大于2的结点。
-
二叉树的子树有左右之分,其子树的次序不能颠倒。
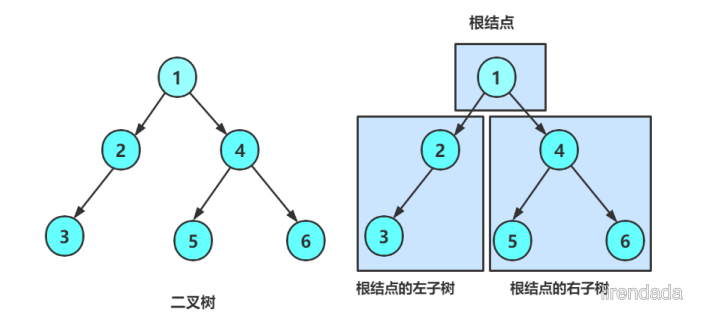
注意:对于任意的二叉树都是由以下几种情况复合而成的:
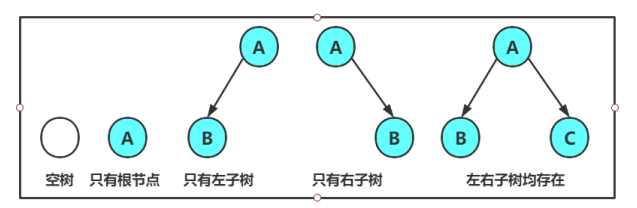
2、特殊的二叉树
-
满二叉树:一个二叉树,如果每一个层的结点数都达到最大值,则这个二叉树就是满二叉树。也就是说,如果一个二叉树的层数为K,且结点总数是(2^k) -1 ,则它就是满二叉树。
-
完全二叉树:完全二叉树是效率很高的数据结构,完全二叉树是由满二叉树而引出来的。对于深度为K的,有n个结点的二叉树,当且仅当其每一个结点都与深度为K的满二叉树中编号从1至n的结点一一对应时称之为完全二叉树。 要注意的是满二叉树是一种特殊的完全二叉树。
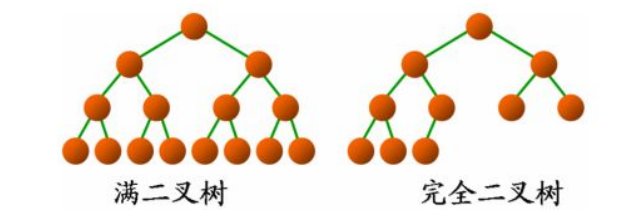
对于满二叉树:
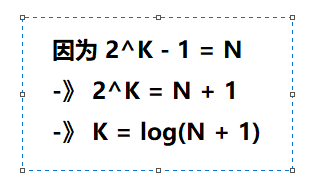
高度为 K 层的满二叉树,节点总数 N 为多少? 答: N = 2^K - 1
如果有 N 个节点,那么高度 K 为多少?
答: K = log(N + 1)
高度其实也就相当于满二叉树的向下调整的时间复杂度:O( log(N + 1) ),简化后为 O(logN)
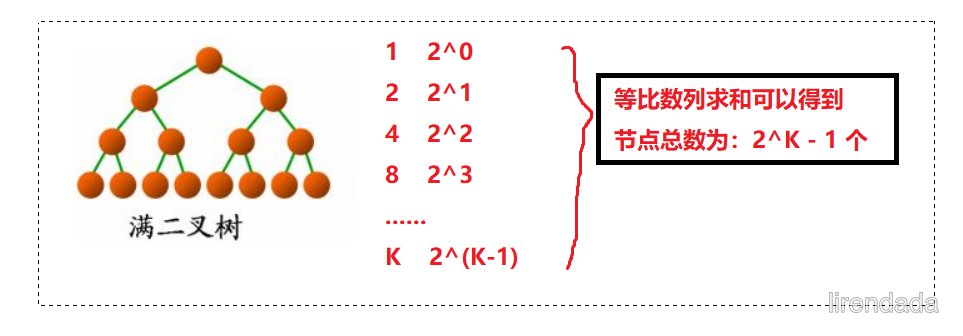
对于完全二叉树:
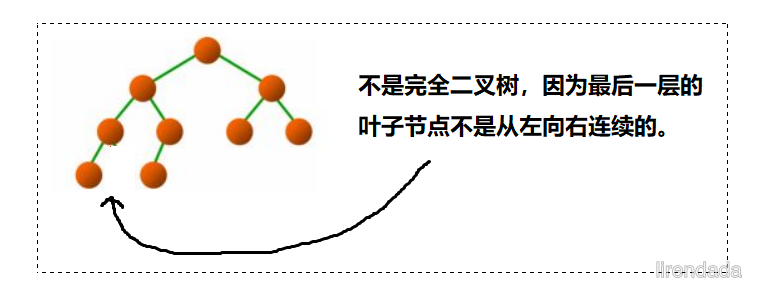
- 前 K - 1层都是满的,最后一层可以不满,但是最后一层必须从左到右连续,如果出现中断则不为完全二叉树。
- 由上面的性质可以得到一个重要的性质:度为 1 的节点最多只有一个。(做题常用)
- 假设有 N 个节点、最后一层叶子节点缺的个数为 x ,则向下调整的时间复杂度,也就是完全二叉树的深度:O( log(N + x + 1) ) 简化后也就是 O(logN)
3、二叉树的性质
-
若规定根节点的层数为1,则一棵非空二叉树的第** i 层上最多有 **2^(i-1) 个结点.
-
若规定根节点的层数为1,则深度为 h 的二叉树的最大结点数是 2^h- 1.
-
对任何一棵二叉树, 如果度为 0 其叶结点个数为 n0, 度为 2 的分支结点个数为 n2, 则有 n0 = n2** + **1
-
若规定根节点的层数为1,具有n 个结点的满二叉树的深度,h=Log2(n+1). (ps:Log2(n+1)是log以2为底,n+1为对数)
-
总边数与度的关系:n - 1 = 0*n0 + 1*n1 + 2*n2 + ....... (ps:n表示节点的个数,n0这些点表示度为0的点,后面以此类推)
-
对于具有n个结点的完全二叉树,如果按照从上至下从左至右的数组顺序对所有节点从0开始编号,则对于序号为i的结点有:
-
若 i>0 , i 位置节点的双亲序号: (i-1)/2;i=0,i为根节点编号,无双亲节点
-
若 2i+1<n ,左孩子序号: 2i+1 , 2i+1>=n 否则无左孩子
-
若 2i+2<n ,右孩子序号: 2i+2 , 2i+2>=n 否则无右孩子
-
4、二叉树的存储结构
① 顺序存储:
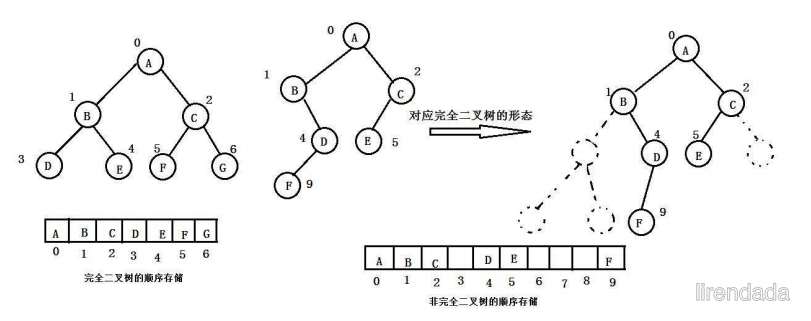
顺序结构存储就是使用数组来存储,一般使用数组只适合表示完全二叉树,因为不是完全二叉树会有空间的浪费。而现实中使用中只有堆才会使用数组来存储,关于堆我们后面的章节会专门讲解。二叉树顺序存储在物理上是一个数组,在逻辑上是一颗二叉树。
② 链式存储:
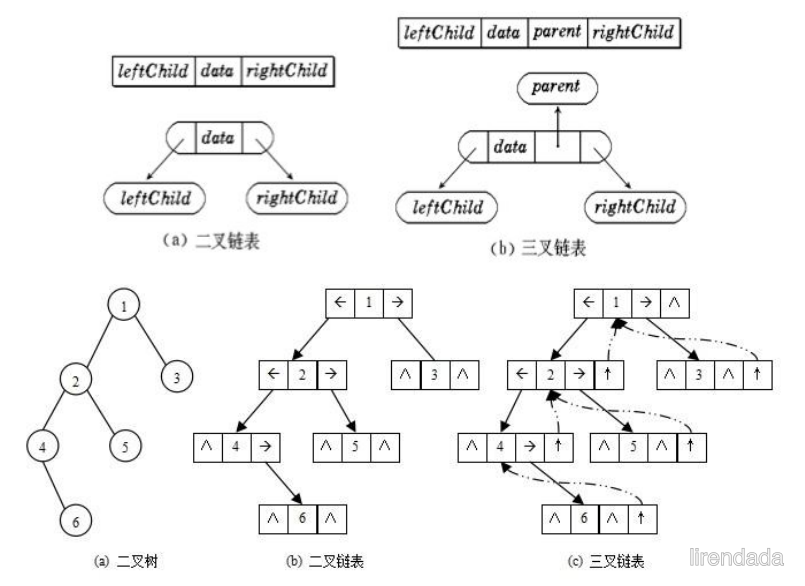
二叉树的链式存储结构是指,用链表来表示一棵二叉树,即用链来指示元素的逻辑关系。 通常的方法是链表中每个结点由三个域组成,数据域和左右指针域,左右指针分别用来给出该结点左孩子和右孩子所在的链结点的存储地址 。链式结构又分为二叉链和三叉链,当前我们学习中一般都是二叉链,后面课程学到高阶数据结构如红黑树等会用到三叉链。
// 二叉链
struct BinaryTreeNode
{
     struct BinTreeNode* _pLeft; // 指向当前节点左孩子
     struct BinTreeNode* _pRight; // 指向当前节点右孩子
     BTDataType _data; // 当前节点值域
}

// 三叉链
struct BinaryTreeNode
{
     struct BinTreeNode* _pParent; // 指向当前节点的双亲
     struct BinTreeNode* _pLeft; // 指向当前节点左孩子
     struct BinTreeNode* _pRight; // 指向当前节点右孩子
     BTDataType _data; // 当前节点值域
};
5、选择题
1. 某二叉树共有 399 个结点,其中有 199 个度为 2 的结点,则该二叉树中的叶子结点数为( )
A 不存在这样的二叉树
B 200
C 198
D 199

2.下列数据结构中,不适合采用顺序存储结构的是( )
A 非完全二叉树
B 堆C 队列
D 栈

3.在具有 2n 个结点的完全二叉树中,叶子结点个数为( )
A n		B n+1 	C n-1 	D n/2

4.一棵完全二叉树的节点数位为531个,那么这棵树的高度为( )
A 11
B 10
C 8
D 12

5.一个具有767个节点的完全二叉树,其叶子节点个数为()
A 383
B 384
C 385
D 386
1.B
2.A
3.A
4.B
5.BⅢ. 二叉树的顺序结构及实现
1、 二叉树的顺序结构
普通的二叉树是不适合用数组来存储的,因为可能会存在大量的空间浪费。而完全二叉树更适合使用顺序结构存储。现实中我们通常把堆 ( 一种二叉树 ) 使用顺序结构的数组来存储,需要注意的是这里的堆和操作系统虚拟进程地址空间中的堆是两回事,一个是数据结构,一个是操作系统中管理内存的一块区域分段。
2、堆的概念及结构
如果有一个关键码的集合K = {k0,k1, k2,…,kn-1},把它的所有元素按完全二叉树的顺序存储方式存储在一个一维数组中,并满足:Ki <= K2i+1 且 Ki<= K2i+2 (Ki >= K2i+1 且 Ki >= K2i+2) i = 0,1,2…,则称为小堆(或大堆)。将根节点最大的堆叫做最大堆或大根堆,根节点最小的堆叫做最小堆或小根堆。
堆的性质:
- 堆中某个节点的值总是不大于或不小于其父节点的值;
- 堆总是一棵完全二叉树。
- 堆的顺序并不是有序的,只是某个节点与其父节点之间的关系是有序的而已!
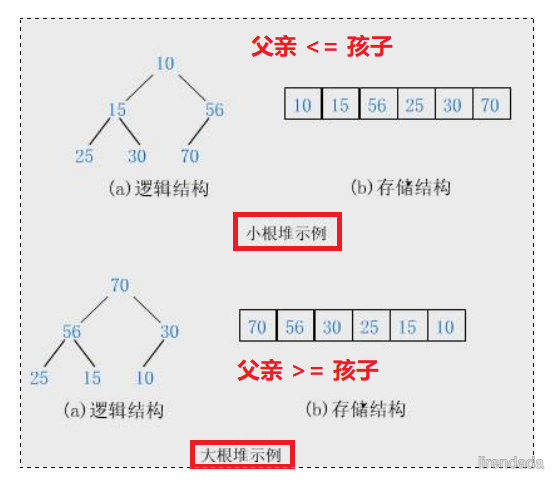
💃 假设父亲下标为 parent,则
- leftchild = 2*parent + 1
- rightchild = 2*parent + 2
- parent = (child - 1) / 2 (注意这里用左孩子或者右孩子都可以,因为 int 类型除以2后都去掉了小数位)
选择题
1.下列关键字序列为堆的是:()
A 100,60,70,50,32,65
B 60,70,65,50,32,100
C 65,100,70,32,50,60
D 70,65,100,32,50,60
E 32,50,100,70,65,60
F 50,100,70,65,60,32

2.已知小根堆为8,15,10,21,34,16,12,删除关键字 8 之后需重建堆,在此过程中,关键字之间的比较次数是
()。
A 1 B 2 C 3 D 4

3.一组记录排序码为(5 11 7 2 3 17),则利用堆排序方法建立的初始堆为
A(11 5 7 2 3 17)
B(11 5 7 2 17 3)
C(17 11 7 2 3 5)
D(17 11 7 5 3 2)
E(17 7 11 3 5 2)
F(17 7 11 3 2 5)

4.最小堆[0,3,2,5,7,4,6,8],在删除堆顶元素0之后,其结果是()
A[3,2,5,7,4,6,8]
B[2,3,5,7,4,6,8]
C[2,3,4,5,7,8,6]
D[2,3,4,5,6,7,8]
1.A 2.C 3.C 4.C3、堆的实现
① 向下调整算法与向上调整算法
现在我们给出一个数组,逻辑上看做一颗完全二叉树。我们通过从根节点开始的向下调整算法可以把它调整成一个小堆。向下调整算法有一个前提:左右子树必须是一个堆,才能调整(若不为堆则需要建堆,下面会讲)。
int a[] = {27,15,19,18,28,34,65,49,25,37};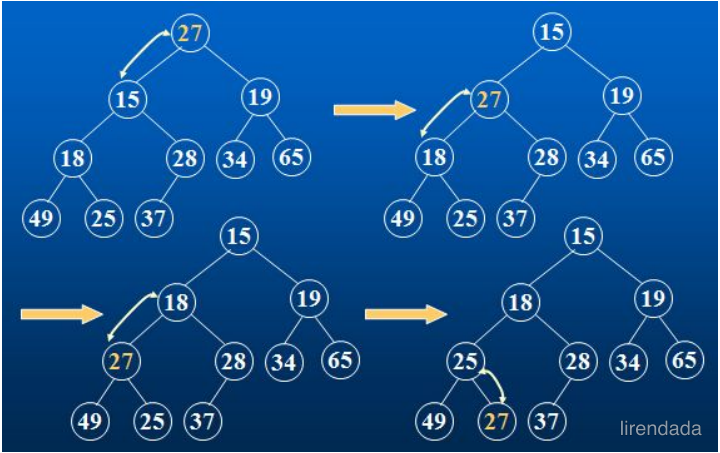
步骤:(以建大堆为例)
- 选出左右孩子中大那个,有一个重要的点,就是判断右孩子节点是否存在
- 大的这个孩子和父亲比
- 如果大的孩子比父亲大,则跟父亲交换,并且把原来孩子的位置当成父亲继续向下调整,直到孩子走到二叉树外面
- 如果大的孩子比父亲小,则不需要处理,调整完成,整棵树已经是大堆了!
//以大堆为例的向下调整算法
void AdjustBigDown(HPDataType* a, int n, int parent)
{
	//先默认为左孩子,下面判断若右孩子小则下标加一即可
	int child = parent * 2 + 1;

	while (child < n)//当child超过n代表已经超出了叶子节点
	{
		//先判断右孩子是否比左孩子大,有一个重要的点,就是判断右孩子节点是否存在
		if ((child + 1 < n) && (a[child + 1] > a[child]))
		{
			child += 1;
		}

		//比较父亲节点和孩子节点
		if (a[child] > a[parent])
		{
			Swap(&a[child], &a[parent]);
			parent = child;//交换完再将孩子节点作为父亲节点,重复步骤
			child = parent * 2 + 1;
		}
		else
		{
			break;
		}
	}
} 而向上调整算法的思路是与向下是类似的,只不过要注意的是这里while循环的条件应该要用 child > 0 而不是 parent >= 0,因为parent 在这里是通过 (child - 1) / 2 算出来的,最小只能是 0。且如果这里 child 的类型是 size_t 的话,这里也会死循环,因为无符号整型是没有负数的!
// 以大堆为例的向上调整算法
void AdjustBigUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;

	// 换成 while(parent >= 0) 是错的,因为child为0时,parent会一直循环为0,即死循环
	while (child > 0)
	{
		if (a[parent] < a[child])
		{
			Swap(&a[parent], &a[child]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
			break;
	}
} 时间复杂度:O(logN) -->其实就是完全二叉树的高度(深度)
② 堆的创建
下面我们给出一个数组,这个数组逻辑上可以看做一颗完全二叉树,但是还不是一个堆,现在我们通过算法,把它构建成一个堆。根节点左右子树不是堆,我们怎么调整呢?这里我们从倒数的第一个非叶子节点的子树开始调整,一直调整到根节点的树,就可以调整成堆。
int a[] = {27,15,19,18,28,34,65,49,25,37};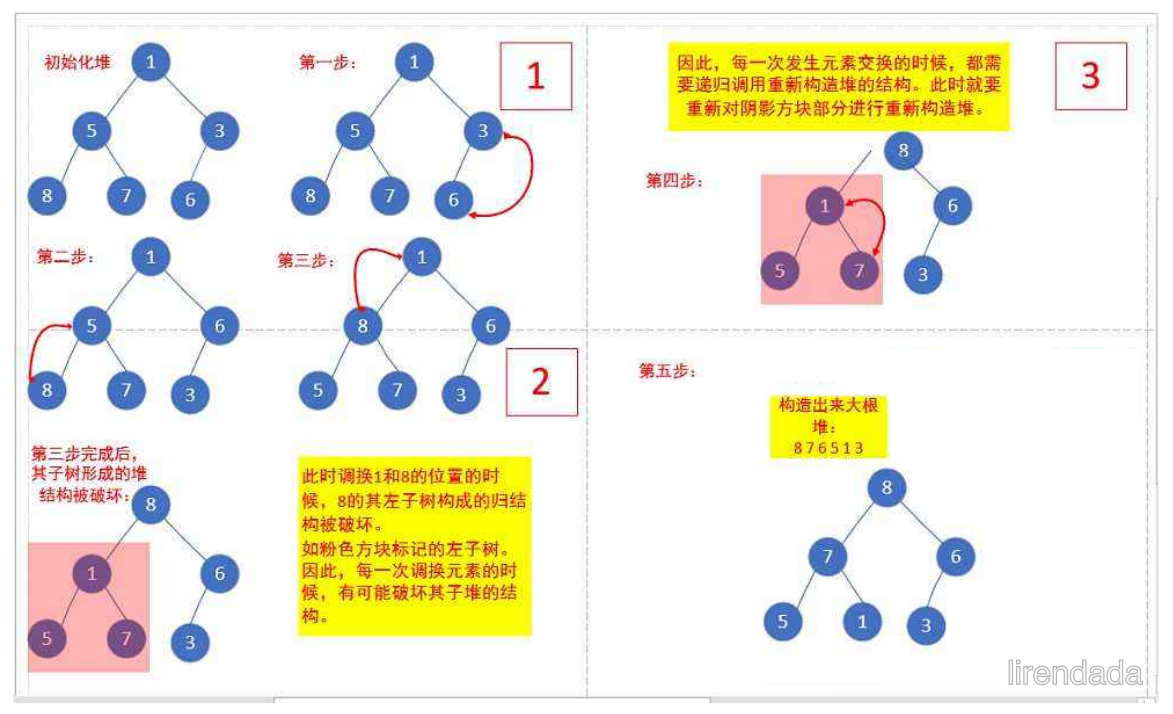
//建成大堆
for (int i = (hp->size - 1 - 1) / 2; i >= 0; i--)
{
    AdjustBigDown(hp->a, hp->size, i); //调用上面的向上调整算法
}
建堆的时间复杂度:
因为堆是完全二叉树,而满二叉树也是完全二叉树,此处为了简化使用满二叉树来证明(时间复杂度本来看的就是近似值,多几个节点不影响最终结果):
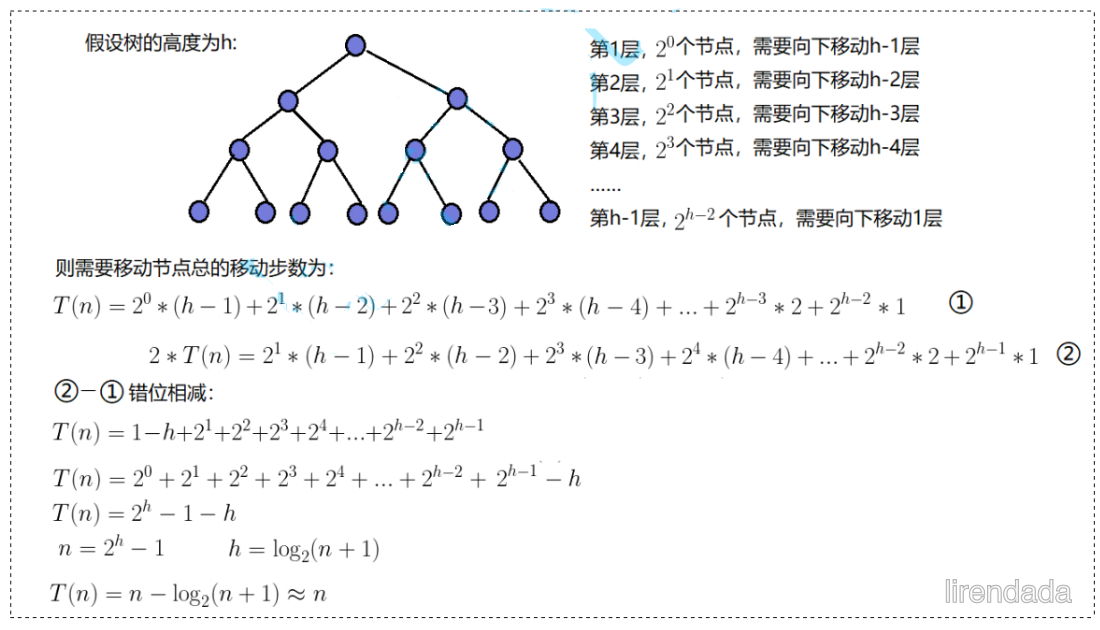
因此:建堆的时间复杂度为 O(N)。
③ 堆的插入
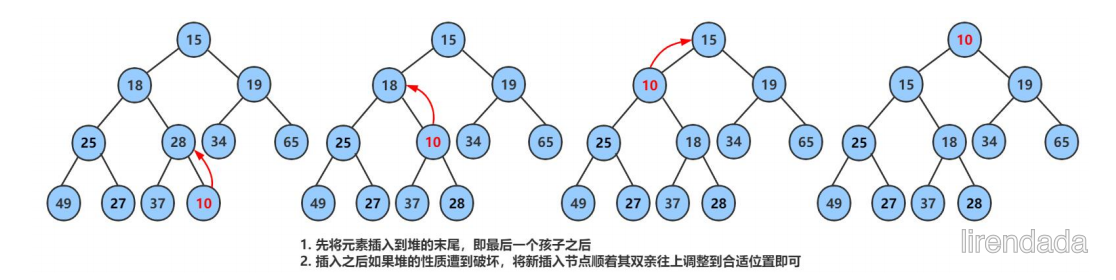
先插入一个10到数组的尾上,再进行向上调整算法,直到满足堆。
//堆的插入
void HeapPush(Heap* hp, HPDataType x)
{
	assert(hp);
	//判断是否需要扩容
	if (hp->size == hp->capacity)
	{
		HPDataType* newarr = (HPDataType*)realloc(hp->a, sizeof(HPDataType) * 2 * hp->capacity);
		if (newarr == NULL)
		{
			printf("realloc fail!\n");
			exit(-1);
		}
		hp->a = newarr;
		hp->capacity *= 2;
	}

	hp->a[hp->size] = x;
	hp->size++;
	//向上调整
	AdjustBigUp(hp->a, hp->size - 1);
}
④ 堆的删除
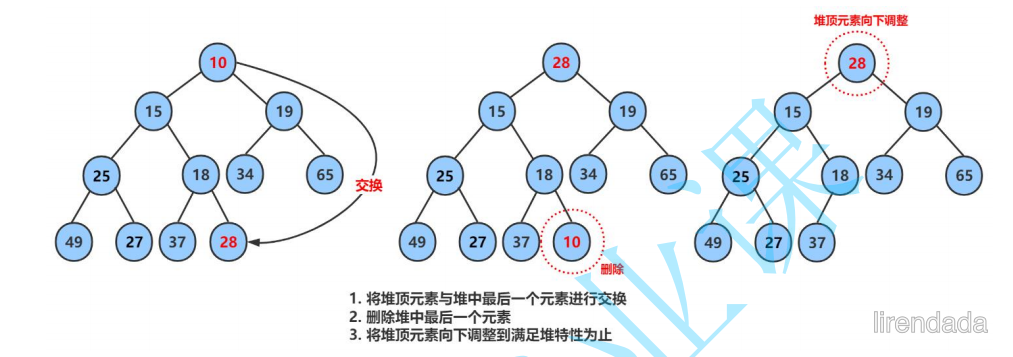
删除堆是删除堆顶的数据,将堆顶的数据根最后一个数据一换,然后删除数组最后一个数据,再进行向下调整算法。
//堆的删除
void HeapPop(Heap* hp)
{
	assert(hp);
	assert(hp->size > 0);

	//先将尾和头交换
	Swap(&hp->a[0], &hp->a[hp->size - 1]);
	//然后去掉尾
	hp->size--;
	//最后向下调整
	AdjustBigDown(hp->a, hp->size, 0);
}
⑤ 堆排序
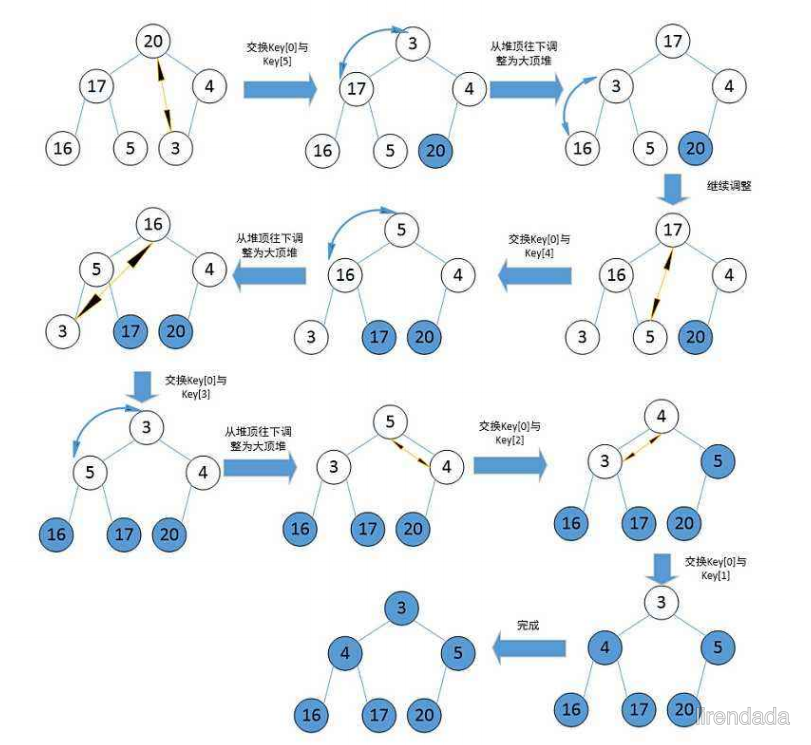
堆排序即利用堆的思想来进行排序,总共分为两个步骤:
-
建堆
-
升序:建大堆
-
降序:建小堆
-
-
利用堆删除思想来进行排序
建堆和堆删除中都用到了向下调整,因此掌握了向下调整,就可以完成堆排序。
//对数组进行堆排序
void HeapSort(HPDataType* a, int n)
{
	int end = n - 1;
	while (end > 0)
	{
		//先交换每次的a[end]和a[0]
		Swap(&a[end], &a[0]);
		//将每次的最后一个排除,继续建大堆,选出次大的
		AdjustBigDown(a, end, 0);
		end--;
	}
}
⑥ TOP-K 问题
TOP-K 问题:即求数据结合中前 K 个最大的元素或者最小的元素,一般情况下数据量都比较大。
比如:专业前10名、世界500强、富豪榜、游戏中前100的活跃玩家等。
对于Top-K问题,能想到的最简单直接的方式就是排序,但是:如果数据量非常大,排序就不太可取了(可能数据都不能一下子全部加载到内存中)。最佳的方式就是用堆来解决,基本思路如下:
-
用数据集合中前 K 个元素来建堆
- 前k个最大的元素,则建小堆
- 前k个最小的元素,则建大堆
-
用剩余的 N-K 个元素依次与堆顶元素来比较,不满足则替换堆顶元素比特就业课将剩余N-K个元素依次与堆顶元素比完之后,堆中剩余的K个元素就是所求的前K个最小或者最大的元素。
//TopK问题: 找出N个数里面最大/最小的前K个问题。
//这里实现两个版本:
//1. 找最大的K个元素
//假设堆为小堆
void PrintSTopK(int* a, int n, int k)
{
	Heap hp;
	//建立含有K个元素的堆
	HeapCreate(&hp, a, k);

	for (size_t i = k; i < n; ++i)  // N
	{
		//每次和堆顶元素比较,大于堆顶元素,则删除堆顶元素,插入新的元素
		if (a[i] > HeapTop(&hp)) // LogK
		{
			HeapPop(&hp);
			HeapPush(&hp, a[i]);
		}
	}
	for (int i = 0; i < k; ++i) {
		printf("%d ", HeapTop(&hp));
		HeapPop(&hp);
	}
}

//2. 找最小的K个元素
//假设堆为大堆
void PrintBTopK(int* a, int n, int k)
{
	Heap hp;
	//建立含有K个元素的堆
	HeapCreate(&hp, a, k);

	for (size_t i = k; i < n; ++i)  // N
	{
		//每次和堆顶元素比较,小于堆顶元素,则删除堆顶元素,插入新的元素
		if (a[i] < HeapTop(&hp)) // LogK
		{
			HeapPop(&hp);
			HeapPush(&hp, a[i]);
		}
	}
	for (int i = 0; i < k; ++i) {
		printf("%d ", HeapTop(&hp));
		HeapPop(&hp);
	}
}

void TestTopk()
{
	int n = 10000;
	int* a = (int*)malloc(sizeof(int) * n);
	srand(time(0));
	//随机生成10000个数存入数组,保证元素都小于1000000
	for (size_t i = 0; i < n; ++i)
	{
		a[i] = rand() % 1000000;
	}
	//确定10个最大的数
	a[5] = 1000000 + 1;
	a[1231] = 1000000 + 2;
	a[531] = 1000000 + 3;
	a[5121] = 1000000 + 4;
	a[115] = 1000000 + 5;
	a[2335] = 1000000 + 6;
	a[9999] = 1000000 + 7;
	a[76] = 1000000 + 8;
	a[423] = 1000000 + 9;
	a[3144] = 1000000 + 10;

	PrintBTopK(a, n, 10);
}
⑦ 其余常见函数
//堆的构建
void HeapCreate(Heap* hp, HPDataType* a, int n)
{
	assert(hp);
	hp->a = (HPDataType*)malloc(sizeof(HPDataType) * n);
	if (hp->a == NULL)
	{
		printf("malloc fail!\n");
		exit(-1);
	}
	else
	{
		hp->capacity = n;
		hp->size = n;
		//将a数组中的数据拷到hp->a中
		memcpy(hp->a, a, sizeof(HPDataType) * n);

		//建成大堆
		for (int i = (hp->size - 1 - 1) / 2; i >= 0; i--)
		{
			AdjustBigDown(hp->a, hp->size, i);
		}
	}
}

//堆的销毁
void HeapDestroy(Heap* hp)
{
	assert(hp);
	free(hp->a);
	hp->a = NULL;
	hp->capacity = hp->size = 0;
}

//打印堆
void HeapPrint(Heap* hp)
{
	assert(hp);
	printf("物理结构为:\n");
	for (int i = 0; i < hp->size; i++)
		printf("%d ", hp->a[i]);

	printf("\n简易的逻辑结构为:\n");
	int num = 0;
	int level = 1;
	for (int i = 0; i < hp->size; i++)
	{
		printf("%-3d ", hp->a[i]);
		++num;
		if (num == level)
		{
			printf("\n");
			level *= 2;
			num = 0;
		}
	}
	printf("\n");
	printf("\n");
}

//取堆顶的数据
HPDataType HeapTop(Heap* hp)
{
	assert(hp);
	assert(hp->size > 0);
	return hp->a[0];
}

//堆的数据个数
int HeapSize(Heap* hp)
{
	assert(hp);
	return hp->size;
}

//堆的判空
int HeapEmpty(Heap* hp)
{
	assert(hp);
	return hp->size == 0;
}
Ⅳ. 二叉树链式结构的实现
1、 前置说明
在学习二叉树的基本操作前,需先要创建一棵二叉树,然后才能学习其相关的基本操作。由于现在大家对二叉树结构掌握还不够深入,为了降低大家学习成本,此处手动快速创建一棵简单的二叉树,快速进入二叉树操作学习,等二叉树结构了解的差不多时,我们反过头再来研究二叉树真正的创建方式。
typedef int BTDataType;
typedef struct BinaryTreeNode
{
    BTDataType _data;
    struct BinaryTreeNode* _left;
    struct BinaryTreeNode* _right; }BTNode;

BTNode* CreatBinaryTree()
{
    BTNode* node1 = BuyNode(1);
    BTNode* node2 = BuyNode(2);
    BTNode* node3 = BuyNode(3);
	BTNode* node4 = BuyNode(4);
    BTNode* node5 = BuyNode(5);
    BTNode* node6 = BuyNode(6);

    node1->_left = node2;
    node1->_right = node4;
    node2->_left = node3;
    node4->_left = node5;
    node4->_right = node6;
    return node1;
}
注意:上述代码并不是创建二叉树的方式,真正创建二叉树方式后序详解重点讲解。
2、二叉树的遍历
所谓遍历(Traversal)是指沿着某条搜索路线,依次对树中每个结点均做一次且仅做一次访问。访问结点所做的操作依赖于具体的应用问 题。 遍历是二叉树上最重要的运算之一,是二叉树上进行其它运算之基础。
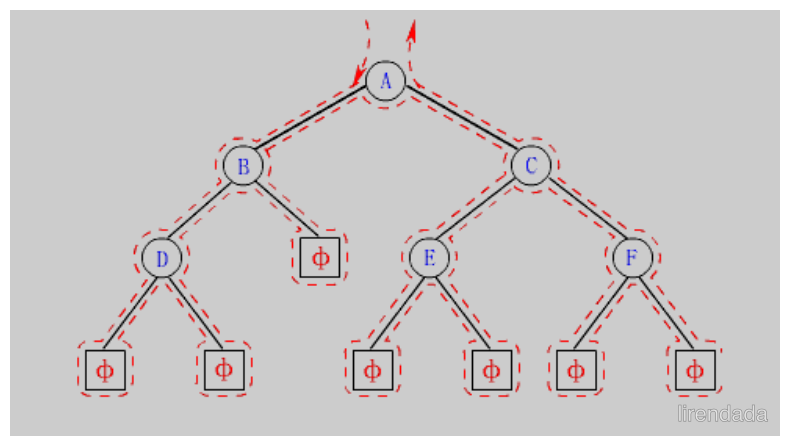
前序 / 中序 / 后序的递归结构遍历:是根据访问结点操作发生位置命名
-
NLR:前序遍历(Preorder Traversal 亦称先序遍历)——访问根结点的操作发生在遍历其左右子树之前。
-
LNR:中序遍历(Inorder Traversal)——访问根结点的操作发生在遍历其左右子树之中(间)。
-
LRN:后序遍历(Postorder Traversal)——访问根结点的操作发生在遍历其左右子树之后。
由于被访问的结点必是某子树的根,所以 N(Node )、 L(Left subtree )和 R(Right subtree )又可解释为 根、根的左子树和根的右子树。NLR、LNR和LRN分别又称为先根遍历、中根遍历和后根遍历。
// 二叉树前序遍历
void PreOrder(BTNode* root);
// 二叉树中序遍历
void InOrder(BTNode* root);
// 二叉树后序遍历
void PostOrder(BTNode* root);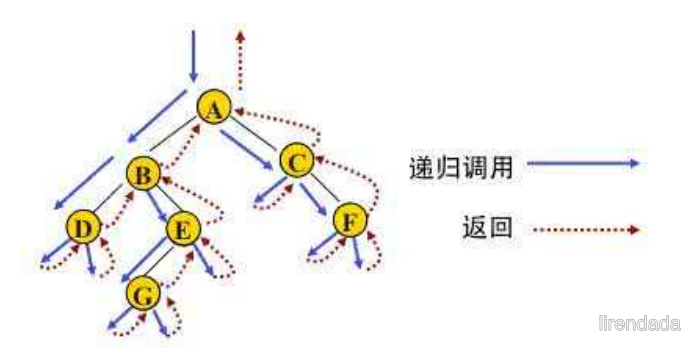
层序遍历:除了先序遍历、中序遍历、后序遍历外,还可以对二叉树进行层序遍历。设二叉树的根节点所在层数为1,层序遍历就是从所在二叉树的根节点出发,首先访问第一层的树根节点,然后从左到右访问第2层上的节点,接着是第三层的节点,以此类推,自上而下,自左至右逐层访问树的结点的过程就是层序遍历。
// 层序遍历
void LevelOrder(BTNode* root);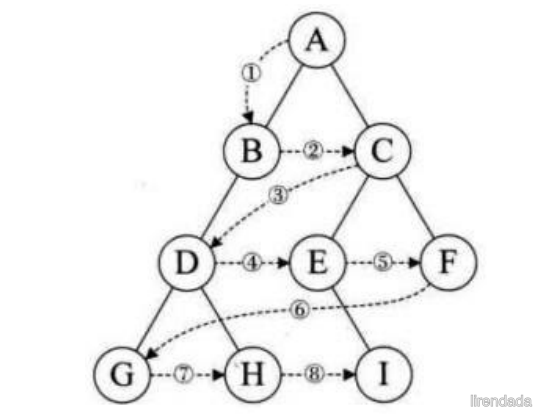
选择题
1.某完全二叉树按层次输出(同一层从左到右)的序列为 ABCDEFGH 。该完全二叉树的前序序列为( )
A ABDHECFG
B ABCDEFGH
C HDBEAFCG
D HDEBFGCA

2.二叉树的先序遍历和中序遍历如下:先序遍历:EFHIGJK;中序遍历:HFIEJKG.则二叉树根结点为()
A E
B F
C G
D H

3.设一课二叉树的中序遍历序列:badce,后序遍历序列:bdeca,则二叉树先序遍历序列为____。
A adbce
B decab
C debac
D abcde

4.某二叉树的后序遍历序列与中序遍历序列相同,均为 ABCDEF ,则按层次输出(同一层从左到右)的序列为
A FEDCBA
B CBAFED
C DEFCBA
D ABCDEF
1.A 2.A 3.D 4.A3、二叉树及一些常见题的实现
#include "queue.h"

typedef char BTDataType;

typedef struct BinaryTreeNode
{
	BTDataType data;
	struct BinaryTreeNode* left;
	struct BinaryTreeNode* right;
}BTNode;

BTNode* CreateTreeNode(BTDataType x)
{
	BTNode* node = (BTNode*)malloc(sizeof(BTNode));
	if (node == NULL)
	{
		printf("malloc fail\n");
		exit(-1);
	}
	node->data = x;
	node->left = NULL;
	node->right = NULL;

	return node;
}

//二叉树的销毁(使用后序遍历最合适)
void BinaryTreeDestroy(BTNode* root)
{
	if (root == NULL)
		return;

	BinaryTreeDestroy(root->left);
	BinaryTreeDestroy(root->right);
	free(root);
}

//二叉树的前序遍历
void BTPrevOrder(BTNode* root)
{
	if (root == NULL)//返回条件
	{
		printf("NULL ");
		return;
	}

	printf("%c ", root->data);
	BTPrevOrder(root->left);
	BTPrevOrder(root->right);
}

//二叉树的中序遍历
void BTInOrder(BTNode* root)
{
	if (root == NULL)//返回条件
	{
		printf("NULL ");
		return;
	}

	BTPrevOrder(root->left);
	printf("%c ", root->data);
	BTPrevOrder(root->right);
}

//二叉树的后序遍历
void BTPostOrder(BTNode* root)
{
	if (root == NULL)//返回条件
	{
		printf("NULL ");
		return;
	}

	BTPrevOrder(root->left);
	BTPrevOrder(root->right);
	printf("%c ", root->data);
}

//二叉树节点个数
int BinaryTreeSize(BTNode* root)
{
	return root == NULL ? 0 : BinaryTreeSize(root->left) +
		BinaryTreeSize(root->right) +
		1;
}

//二叉树叶子节点个数
int BinaryTreeLeafSize(BTNode* root)
{
	if (root == NULL)
		return 0;
	if (root->left == NULL && root->right == NULL)
		return 1;
	return BinaryTreeLeafSize(root->left) + BinaryTreeLeafSize(root->right);
}

//二叉树第k层节点个数
int BinaryTreeLevelKSize(BTNode* root, int k)
{
	if (root == NULL)
		return 0;
	if (k == 1)
		return 1;
	return BinaryTreeLevelKSize(root->left, k - 1) + BinaryTreeLevelKSize(root->right, k - 1);
}

//二叉树查找值为x的节点
BTNode* BinaryTreeFind(BTNode* root, BTDataType x)
{
	if (root == NULL)
		return NULL;

	if (root->data == x)
		return root;

	//判断左子树和右子树是否找到x
	BTNode* left = BinaryTreeFind(root->left, x);
	if (left)
		return left;
	BTNode* right = BinaryTreeFind(root->right, x);
	if (right)
		return right;

	//若都找不到则返回NULL
	return NULL;
}

//二叉树的层序遍历(广度优先遍历)
void BinaryTreeLevelOrder(BTNode* root)
{
	Queue q;//先初始化队列,记得最后销毁
	QueueInit(&q);

	if (root == NULL)//判空一下
		return;

	QueuePush(&q, root);//先把root放进去

	while (!QueueEmpty(&q))//直到队列为空
	{
		//先记录下队头数据,然后pop,顺便打印
		BTNode* tmp = QueueFront(&q);
		QueuePop(&q);
		printf("%c", tmp->data);

		//将front的下一层带入队列
		//要判断一下左右孩子是否为空
		if (tmp->left != NULL)
			QueuePush(&q, tmp->left);
		if (tmp->right != NULL)
			QueuePush(&q, tmp->right);
	}
	QueueDestroy(&q);
}

//判断二叉树是否为完全二叉树
bool BinaryTreeComplete(BTNode* root)
{
	Queue q;//先创一个队列
	QueueInit(&q);

	if(root != NULL)//若非空,则根节点先入队
		QueuePush(&q, root);

	while (!QueueEmpty(&q))
	{
		BTNode* tmp = QueueFront(&q);
		QueuePop(&q);

		//若为NULL则判断队列中是否都为NULL
		if (tmp == NULL)
		{
			while (!QueueEmpty(&q))
			{
				BTNode* tm = QueueFront(&q);
				QueuePop(&q);

				if (tm != NULL)
					return false;
			}
			break;//记得退出循环
		}

		QueuePush(&q, tmp->left);
		QueuePush(&q, tmp->right);
	}
	QueueDestroy(&q);
	return true;
}

int main()
{
	BTNode* A = CreateTreeNode('A');
	BTNode* B = CreateTreeNode('B');
	BTNode* C = CreateTreeNode('C');
	BTNode* D = CreateTreeNode('D');
	BTNode* E = CreateTreeNode('E');
	BTNode* F = CreateTreeNode('F');
	A->left = B;
	A->right = C;
	B->left = D;
	C->left = E;
	C->right = F;

	BTPrevOrder(A);
	printf("\n%d ", BinaryTreeSize(A));
	printf("\n%d ", BinaryTreeLeafSize(A));
	printf("\n%d ", BinaryTreeLevelKSize(A, 3));

	printf("\n%p", BinaryTreeFind(A, 'F'));
	printf("\n%p\n", BinaryTreeFind(A, 'X'));

	BinaryTreeLevelOrder(A);
	printf("\n%d\n", BinaryTreeComplete(A));

	BinaryTreeDestroy(A);
	A = NULL;
	return 0;
}