二叉树在前面C语言阶段已经讲过,该笔记取名二叉树进阶是因为:
-
map和set特性需要先铺垫二叉搜索树,而二叉搜索树也是一种树形结构 -
二叉搜索树的特性了解,有助于更好的理解
map和set的特性 -
二叉树中部分面试题稍微有点难度
-
有些
OJ题使用C语言方式实现比较麻烦
因此本节借二叉树搜索树,对二叉树部分进行收尾总结。
Ⅱ. 二叉搜索树
1、概念
二叉搜索树(Binary Search Tree)又称二叉排序树,它或者是一棵空树,或者是具有以下性质的二叉树:
- 若它的左子树不为空,则左子树上所有节点的值都小于根节点的值
- 若它的右子树不为空,则右子树上所有节点的值都大于根节点的值
- 它的左右子树也分别为二叉搜索树
int a [] = {5,3,4,1,7,8,2,6,0,9};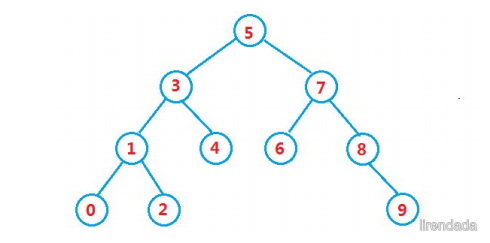
⛵ 特点:用中序遍历的话,结果都是有序的
2、性能分析
插入和删除操作都必须先查找,查找效率代表了二叉搜索树中各个操作的性能。对有n个结点的二叉搜索树,若每个元素查找的概率相等,则二叉搜索树平均查找长度是结点在二叉搜索树的深度的函数,即结点越深,则比较次数越多。
但对于同一个关键码集合,如果各关键码插入的次序不同,可能得到不同结构的二叉搜索树:
最优情况下,二叉搜索树为完全二叉树,其平均比较次数为:O(logN)
最差情况下,二叉搜索树退化为单支树,其平均比较次数为: O(N)
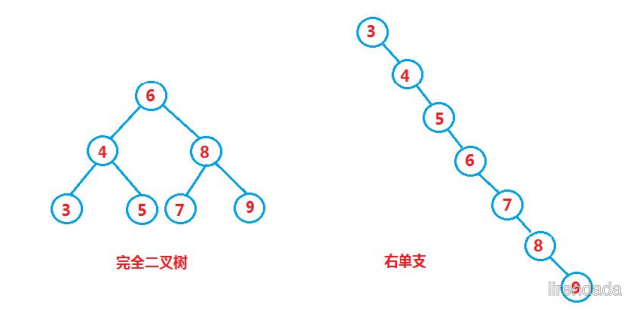
❓ 问题:如果退化成单支树,二叉搜索树的性能就失去了。那能否进行改进,不论按照什么次序插入关键码,都可以使二叉搜索树的性能最佳?
💡 解答: 为了解决这个问题,引出了 AVL 树和红黑树,他们是平衡搜索树,用来解决这种最坏的情况,使时间复杂度控制在 O(N) ,这个后续会讲!
Ⅲ. 二叉搜索树的操作
1、二叉搜索树的查找
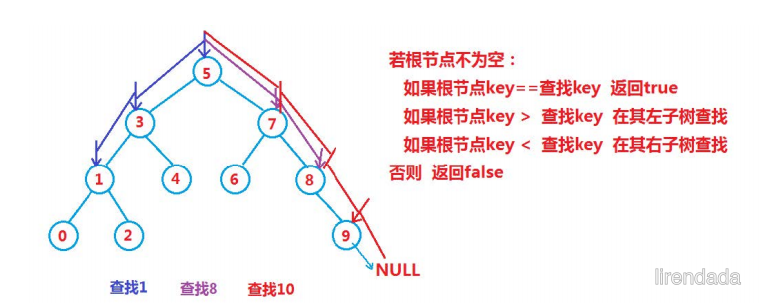
- 从根开始比较,查找,比根大则往右边走查找,比根小则往左边走查找。
- 最多查找高度次,若走到空还没找到,则这个值不存在。
① 迭代版本
Node* Find(const K& val)
{
    Node* cur = _root;
    while (cur != nullptr)
    {
        // 比根小则去左子树找
        if (cur->_key > val)
            cur = cur->_left;
        // 比根大则去右子树找
        else if (cur->_key < val)
            cur = cur->_right;
        // 找到了则返回该节点
        else
            return cur;
    }
    return nullptr;
}
② 递归版本
🍰 注意:为了接口的一致性(一般只传 key 等),我们将需要传节点的函数独立出来作为子函数,然后从主接口去调用。
bool FindR(const K& key)
{
    return _FindR(_root, key);
}

//查找递归的子函数
bool _FindR(Node* root, const K& key)
{
    //没找到直接返回false
    if (root == nullptr)
        return false;

    if (root->_key > key)
        return _FindR(root->_left, key);
    else if (root->_key < key)
        return _FindR(root->_right, key);
    else
        return true;
}
2、二叉树的插入
插入的具体过程如下:
-
树为空,则直接插入
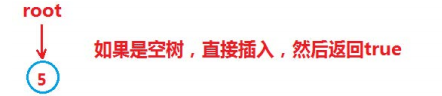
-
树不空,按二叉搜索树性质查找插入位置,插入新节点
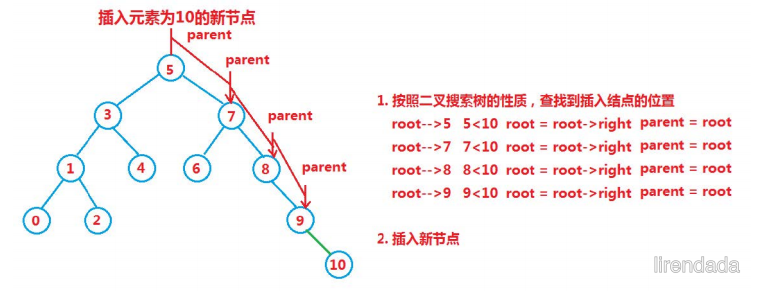
① 迭代版本
//若是重复元素则返回false,插入成功则返回true
bool Insert(const K& key)
{
    //若没有元素的时候直接给_root开辟节点
    if (_root == nullptr)
    {
        _root = new Node(key);
        return true;
    }

    Node* cur = _root;
    Node* parent = nullptr;
    while (cur != nullptr)
    {
        parent = cur; //让parent先记录cur的位置

        if (key < cur->_key)
        {
            cur = cur->_left;
        }
        else if (cur->_key < key)
        {
            cur = cur->_right;
        }
        else  //重复则直接返回false
        {
            return false;
        }
    }

    //最后记得开辟新节点和parent链接起来
    if (key < parent->_key)
        parent->_left = new Node(key);
    else
        parent->_right = new Node(key);

    return true;
}
② 递归版本
🐛 这里能实现不传递 parent,其实就是用传引用来解决了这个问题,这里子类的节点就是父类的左右子树的别名!找到 nullptr 处然后插入即可。
bool InsertR(const K& key)
{
    return _InsertR(_root, key);
}

//插入递归的子函数
bool _InsertR(Node*& root, const K& key)
{
    // 若为空说明没有重复的,则直接开辟节点,返回true
    if (root == nullptr)
    {
        root = new Node(key);
        return true;
    }

    // 查找要插入的位置
    if (root->_key > key)
        return _InsertR(root->_left, key);
    else if (root->_key < key)
        return _InsertR(root->_right, key);
    // 若找到重复的直接返回false
    else
        return false;
}
3、二叉树的删除
首先查找元素是否在二叉搜索树中,如果不存在,则返回 , 否则要删除的结点可能分下面四种情况:
a. 要删除的结点无孩子结点也就是叶子节点
b. 要删除的结点只有左孩子结点
c. 要删除的结点只有右孩子结点
d. 要删除的结点有左、右孩子结点
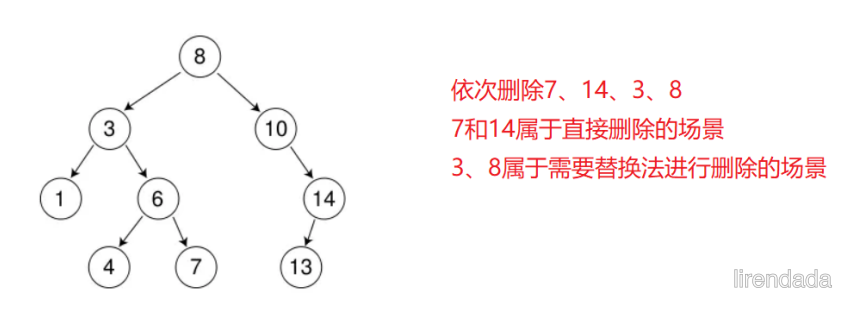
看起来有待删除节点有4种情况,实际情况a可以与情况b或者c合并起来,因此真正的删除过程如下:
- 情况** **b :删除该结点且使被删除节点的双亲结点指向被删除节点的左孩子结点
- 情况** **c :删除该结点且使被删除节点的双亲结点指向被删除结点的右孩子结点
- 情况** d :在它的右子树中寻找中序下的第一个结点 ( 关键码最小,即右子树的最小值 **) ,用它的值填补到被删除节点中,再来处理该结点的删除问题
① 迭代版本
bool Erase(const K& val)
{
    Node* cur = _root;
    Node* parent = nullptr;
    // 先找到该节点
    while (cur != nullptr)
    {
        if (cur->_key > val)
        {
            parent = cur;
            cur = cur->_left;
        }
        else if (cur->_key < val)
        {
            parent = cur;
            cur = cur->_right;
        }
        else // 找到后开始删除
        {
            // 判断不同情况下怎么删除节点
            // 1、左为空或者右为空,把另一个孩子交给父亲,删除自己
            if (cur->_left == nullptr)
            {
                if (cur == _root)
                {
                    _root = cur->_right;
                }
                else
                {
                    if (parent->_left == cur)
                    {
                        parent->_left = cur->_right;
                    }
                    else
                    {
                        parent->_right = cur->_right;
                    }
                }
                delete cur;
            }
            else if (cur->_right == nullptr)
            {
                if (cur == _root)
                {
                    _root = cur->_left;
                }
                else
                {
                    if (parent->_left == cur)
                    {
                        parent->_left = cur->_left;
                    }
                    else
                    {
                        parent->_right = cur->_left;
                    }
                }
                delete cur;
            }
            else // 2、当左右节点都不为空的情况,替换法删除(这里默认为找右子树的最小值)
            {
                // 先找到右子树的最小值,顺便记下minParent的值,以便后面的删除
                Node* minParent = cur; // 注意这里不能设为空,如果minRight没进去循环,后面的删除就会崩了
                Node* minRight = cur->_right;
                while (minRight->_left != nullptr) //注意这里不能写minRight != nullptr,因为这样子也可能最后自己变成了nullptr
                {
                    minParent = minRight;
                    minRight = minRight->_left;
                }

                //让cur节点与minRight的值交换
                cur->_key = minRight->_key;

                //删除minRight节点,此时只有可能是右子树或者叶子节点
                if (minParent->_left == minRight)
                {
                    minParent->_left = minRight->_right;
                }
                else
                {
                    minParent->_right = minRight->_right;
                }
                delete minRight;
            }

            return true;
        }
    }

    return false;
}
② 递归版本
bool EraseR(const K& key)
{
    return _EraseR(_root, key);
}

//删除递归的子函数
bool _EraseR(Node*& root, const K& key)
{
    if (root == nullptr)
        return false;

    if (root->_key > key)
    {
        return _EraseR(root->_left, key);
    }
    else if (root->_key < key)
    {
        return _EraseR(root->_right, key);
    }
    else //找到了节点后开始删
    {
        //左右子树有一棵为空的情况
        if (root->_left == nullptr)
        {
            Node* del = root;
            root = root->_right;
            delete del;
        }
        else if (root->_right == nullptr)
        {
            Node* del = root;
            root = root->_left;
            delete del;
        }
        else  //左右子树都不为空的情况
        {
            //先找到右子树的最小值
            Node* cur = root->_right;
            while (cur->_left)
            {
                cur = cur->_left;
            }

            //先记下最小值,然后继续调用函数去删掉那个用来代替的cur节点
            K rightMin = cur->_key;
            _EraseR(root->_right, rightMin);

            root->_key = rightMin;
        }
        return true;
    }
}
4、二叉树的中序遍历
//中序遍历得用子函数去调用,因为我们的二叉树遍历接口一般不用传参的,如t.Inorder()
//但是如果不传参的话,这里没办法接着去走它的左右子树,所以我们得把它变成子函数去调用
void Inorder()
{
    _Inorder(_root);
    cout << endl;
}
private:
void _Inorder(Node* root) //作为私有成员函数,防止被外界访问
{
    if (root == nullptr)
        return;

    _Inorder(root->_left);
    cout << root->_key << " ";
    _Inorder(root->_right);
}
Ⅳ. 二叉搜索树的实现
1、整体框架
#pragma once
#include <iostream>
using namespace std;

template <class K>
class BSTreeNode
{
public:
	BSTreeNode(const K& key = K()) //最好有缺省值
		:_key(key),
		_left(nullptr),
		_right(nullptr)
	{}
public:
	BSTreeNode<K>* _left;
	BSTreeNode<K>* _right;
	K _key;
};

template <class K>
class BSTree
{
public:
	typedef BSTreeNode<K> Node;
public:
	BSTree()
		:_root(nullptr)
	{}

	//若是重复元素则返回false,插入成功则返回true
	bool Insert(const K& key);

	bool Erase(const K& val);

	Node* Find(const K& val);

	//中序遍历得用子函数去调用,因为我们的二叉树遍历接口一般不用传参的,如t.Inorder()
	//但是如果不传参的话,这里没办法接着去走它的左右子树,所以我们得把它变成子函数去调用
	void Inorder()
	{
		_Inorder(_root);
		cout << endl;
	}
private:
	void _Inorder(Node* root); //作为私有成员函数,防止被外界访问

private:
	Node* _root;
};
2、拷贝构造以及赋值重载
看以下代码:
void Test2()
{
	int a[] = { 5,3,4,1,7,8,2,6,0,9 };
	BSTree<int> b;
	for (auto e : a)
	{
		b.InsertR(e);
	}
	b.Inorder();

	BSTree<int> copy = b;
	copy.Inorder();
}

🚩 运行结果:
0 1 2 3 4 5 6 7 8 9
0 1 2 3 4 5 6 7 8 9 程序虽然正常跑起来啦!但是其实这是错误的,为什么?
🐛 因为这只是浅拷贝,b 和 c 现在其实指向的是同一块空间,程序没有崩溃的原因是因为我们也没有自己写析构函数来释放空间,一旦写了就会奔溃,所以我们是有必要自己来写拷贝构造以及赋值重载的!
对于深拷贝,简单的说就是重新开辟一个空间,然后把值拷贝过去。
而对于二叉树的拷贝,我们可以采用递归的方式,并且我们得写个子函数 Copy() 替我们完成拷贝,因为我们得传递左右子树节点:
//拷贝构造函数
BSTree(const BSTree<K>& t)
{
    _root = Copy(t._root);
}

Node* Copy(Node* root)
{
    if (root == nullptr)
        return nullptr;

    Node* copynode = new Node(root->_key);
    copynode->_left = Copy(root->_left);
    copynode->_right = Copy(root->_right);
    return copynode;
} 对于赋值重载那就更简单啦,我们直接用现代写法,复用拷贝构造!
🔺 这里的重点还是利用传值而不是传引用,这样子就在传参时候间接调用了拷贝构造函数!
//赋值重载
BSTree<K>& operator=(BSTree<K> t)
{
    swap(t._root, _root);
    return *this;
}
3、析构函数
我们要用递归去析构掉节点,所以我们得传参去递归左右子树,也就是说我们得写个子函数 Destory() 替我们去完成析构的任务。
//析构函数
~BSTree()
{
    Destory(_root);
    _root = nullptr;
}

void Destory(Node* root)
{
    if (root == nullptr)
        return;

    //得用后序遍历的方式来删除,不然会找不到左右子树
    Destory(root->_left);
    Destory(root->_right);
    delete root;
}
Ⅴ. 二叉搜索树的应用
1、K 模型: K 模型即只有 key 作为关键码,结构中只需要存储 Key 即可,关键码即为需要搜索到的值。
比如:给一个单词
word,判断该单词是否拼写正确,具体方式如下:
以单词集合中的每个单词作为
key,构建一棵二叉搜索树在二叉搜索树中检索该单词是否存在,存在则拼写正确,不存在则拼写错误。
#pragma once
#include <iostream>
using namespace std;

namespace K
{
	template <class K>
	class BSTreeNode
	{
	public:
		BSTreeNode(const K& key = K())
			:_key(key),
			_left(nullptr),
			_right(nullptr)
		{}
	public:
		BSTreeNode<K>* _left;
		BSTreeNode<K>* _right;
		K _key;
	};

	template <class K>
	class BSTree
	{
	public:
		typedef BSTreeNode<K> Node;
	public:
		BSTree()
			:_root(nullptr)
		{}
		//拷贝构造函数
		BSTree(const BSTree<K>& t)
		{
			_root = Copy(t._root);
		}
		//赋值重载
		BSTree<K>& operator=(BSTree<K> t)
		{
			swap(t._root, _root);
			return *this;
		}
		//析构函数
		~BSTree()
		{
			Destory(_root);
			_root = nullptr;
		}
		//若是重复元素则返回false,插入成功则返回true
		bool Insert(const K& key);
		bool Erase(const K& val);
		Node* Find(const K& val);

		//中序遍历得用子函数去调用,因为我们的二叉树遍历接口一般不用传参的,如t.Inorder()
		//但是如果不传参的话,这里没办法接着去走它的左右子树,所以我们得把它变成子函数去调用
		void Inorder()
		{
			_Inorder(_root);
			cout << endl;
		}
	private:
		void _Inorder(Node* root) //作为私有成员函数,防止被外界访问
		Node* Copy(Node* root);
		void Destory(Node* root);
	private:
		Node* _root;
	};
}

void Test1()
{
	int a[] = { 5,3,4,1,7,8,2,6,0,9 };
	K::BSTree<int> b;
	for (auto e : a)
	{
		b.InsertR(e);
	}
	b.Inorder();

	for (auto e : a)
	{
		b.EraseR(e);
	}

	b.Erase(7);
	b.Inorder();
}

void Test2()
{
	int a[] = { 5,3,4,1,7,8,2,6,0,9 };
	K::BSTree<int> b;
	for (auto e : a)
	{
		b.InsertR(e);
	}
	b.Inorder();

	K::BSTree<int> copy = b;
	copy.Inorder();

	K::BSTree<int> opetor;
	opetor = b;
	opetor.Inorder();
}
2、KV 模型:每一个关键码key,都有与之对应的值Value,即<Key, Value>的键值对。该种方式在现实生活中非常常见:
- 比如英汉词典就是英文与中文的对应关系,通过英文可以快速找到与其对应的中文,英文单词与其对应的中文
<word, chinese>就构成一种键值对; - 再比如统计单词次数,统计成功后,给定单词就可快速找到其出现的次数,单词与其出现次数就是
<word, count>就构成一种键值对。 - 比如:实现一个简单的英汉词典
dict,可以通过英文找到与其对应的中文,具体实现方式如下:- <单词,中文含义>为键值对构造二叉搜索树,注意:二叉搜索树需要比较,键值对比较时只比较
Key查询英文单词时,只需给出英文单词,就可快速找到与其对应的key
- <单词,中文含义>为键值对构造二叉搜索树,注意:二叉搜索树需要比较,键值对比较时只比较
namespace KV
{
	template <class K, class V>
	class BSTreeNode
	{
	public:
		BSTreeNode(const K& key = K(), const V& value = V())
			:_key(key),
			_value(value),
			_left(nullptr),
			_right(nullptr)
		{}
	public:
		BSTreeNode<K, V>* _left;
		BSTreeNode<K, V>* _right;
		K _key;
		V _value;
	};

	template <class K, class V>
	class BSTree
	{
	public:
		typedef BSTreeNode<K, V> Node;
	public:
		BSTree()
			:_root(nullptr)
		{}
		//拷贝构造函数
		BSTree(const BSTree<K, V>& t)
		{
			_root = Copy(t._root);
		}
		//赋值重载
		BSTree<K, V>& operator=(BSTree<K, V> t)
		{
			swap(t._root, _root);
			return *this;
		}
		//析构函数
		~BSTree()
		{
			Destory(_root);
			_root = nullptr;
		}

		//若是重复元素则返回false,插入成功则返回true
		bool Insert(const K& key, const V& value);
		bool Erase(const K& val);
		//中序遍历得用子函数去调用,因为我们的二叉树遍历接口一般不用传参的,如t.Inorder()
		//但是如果不传参的话,这里没办法接着去走它的左右子树,所以我们得把它变成子函数去调用
		void Inorder();
	private:
		void _Inorder(Node* root); //作为私有成员函数,防止被外界访问
		Node* Copy(Node* root);
		void Destory(Node* root);
	private:
		Node* _root;
	};
}
① 简单的中英文互译
void Test3()
{
	//输入单词,查找对应的中文翻译
	KV::BSTree<string, string> dict;
	dict.InsertR("string", "字符串");
	dict.InsertR("liren", "利刃");
	dict.InsertR("yt", "杨狗");
	dict.InsertR("apple", "苹果");
	dict.InsertR("const", "常量");
	dict.InsertR("static", "静态");
	//......可以插入词库里面的所有单词

	string str;
	while (cin >> str)
	{
		KV::BSTreeNode<string, string>* tmp = dict.FindR(str);
		if (tmp == nullptr)
			cout << "查无此单词:" << str << endl;
		else
			cout << str << " 中文翻译:" << tmp->_value << endl;
	}
}
② 统计字符串出现的次数
void Test4()
{
	//统计字符串出现的次数
	string arr[] = { "利刃","利刃","rk98" ,"杨狗" ,"利刃" ,"杨狗" ,"利刃" ,"利刃" ,"苹果" ,"利刃" };
	KV::BSTree<string, int> countTree;

	//用传引用防止string过多的调用拷贝构造,又为了防止被修改,所以加上const
	for (const auto& e : arr)
	{
		//先查找字符串是否在搜索树中
		//1、不在的话,说明字符串第一次出现,则插入<字符串,1>
		//2、如果存在的话,则直接让对应字符串出现的次数++即可
		KV::BSTreeNode<string, int>* tmp = countTree.Find(e);
		if (tmp == nullptr)
			countTree.Insert(e, 1);
		else
			tmp->_value++;
	}
	countTree.Inorder();
}
Ⅵ. 二叉树进阶面试题
-
二叉树创建字符串。OJ链接
-
二叉树的分层遍历1。OJ链接
-
二叉树的分层遍历2。OJ链接
-
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先 。OJ链接
-
二叉树搜索树转换成排序双向链表。OJ链接
-
根据一棵树的前序遍历与中序遍历构造二叉树。 OJ链接
-
根据一棵树的中序遍历与后序遍历构造二叉树。OJ链接
-
二叉树的前序遍历,非递归迭代实现 。OJ链接
-
二叉树中序遍历 ,非递归迭代实现。OJ链接
-
二叉树的后序遍历 ,非递归迭代实现。OJ链接
这里我们主要讲一下迭代版本的前中后序遍历,其他的放到刷题笔记中去!
1、迭代实现前序遍历
首先讲讲为什么要去实现非递归的遍历呢,因为递归的缺陷就是空间问题,栈溢出是有可能存在的情况,所以我们必须尝试着去迭代遍历!
回归正题!我们怎么实现迭代遍历呢?还能像递归一样递归左右子树吗,显然不太行!所以我们这里又给了一个新思路:
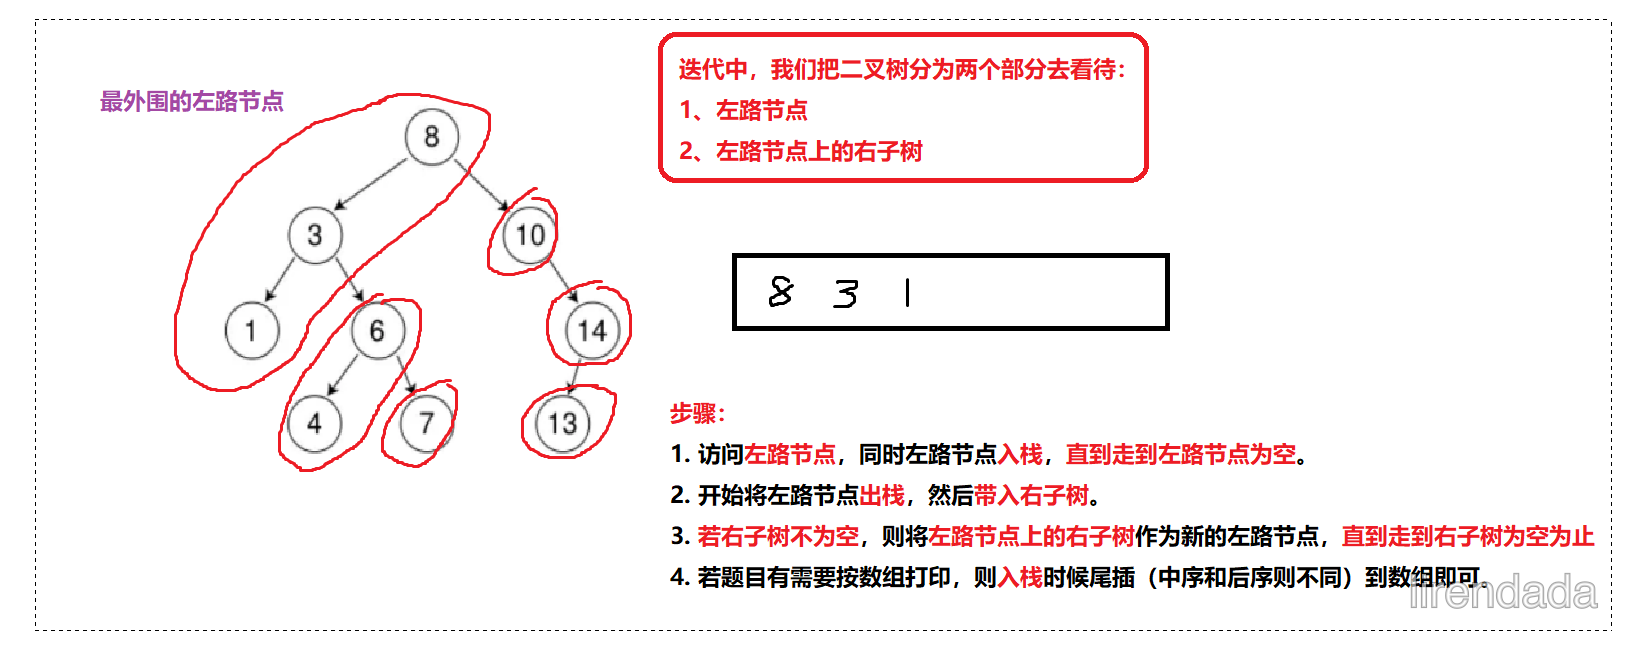
将二叉树分为两个部分去看待:
- 左路节点
- 左路节点上的右子树
然后借用栈来模拟递归
前序遍历步骤:
- 访问左路节点,同时左路节点入栈,直到走到左路节点为空。
- 开始将左路节点出栈,然后带入右子树。
- 若右子树不为空,则将左路节点上的右子树作为新的左路节点,直到走到右子树为空为止
- 若题目有需要按数组打印,则入栈时候尾插(中序和后序则不同)到数组即可。
class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
        stack<TreeNode*> st;
        vector<int> v;
        TreeNode* cur = root;

        // 当cur为空且st为空说明已经遍历完了
        while(cur || !st.empty())
        {
            // 1、访问左路节点,左路节点入栈
            while(cur != nullptr)
            {
                st.push(cur);
                v.push_back(cur->val);
                cur = cur->left;
            }

            // 2、依次取左路节点的右子树出来访问
            TreeNode* top = st.top();
            st.pop();

            cur = top->right;
        }
        return v;
    }
};
二叉树的前序遍历,非递归迭代实现 。OJ链接
2、迭代实现中序遍历
有了前序遍历做铺垫就好理解了,中序也就是在前序的基础上改动了一点!
与前序不同的是:
- 中序不能在入左路节点进栈的时候进行打印或者尾插节点元素(因为中序得先访问左子树再访问中间节点!)
- 所以中序得在左路节点都入栈后才打印或者尾插节点元素
class Solution {
public:
    vector<int> inorderTraversal(TreeNode* root) {
        stack<TreeNode*> st;
        vector<int> v;
        TreeNode* cur = root;

        while(cur || !st.empty())
        {
            // 1、先将左路节点入栈
            while(cur != nullptr)
            {
                st.push(cur);
                cur = cur->left;
            }

            // 依次取左路节点的右子树进行访问
            // 与前序遍历不同,中序在左路节点全部入栈、访问右子树之前顺便打印或者尾插该节点
            TreeNode* top = st.top();
            st.pop();

            v.push_back(top->val);

            cur = top->right;
        }
        return v;
    }
};
二叉树中序遍历 ,非递归迭代实现。OJ链接
3、迭代实现后序遍历
后序的情况就相对来说比较复杂啦,但是大体的思路还是和前中序是差不多的!
思路:
- 与前中序一样,先将左路节点都入栈
- 然后依次取左路节点的右子树出来访问
- 如果这个时候右子树为空或者右子树已经访问过了,那么就可以访问栈顶元素了
- 如果这个时候右子树不为空且还没被访问过,那就让
cur = top->right变成子问题去解决
而这里面最重要的一点就是如何让右子树已经知道自己被访问过了?
💡 我们可以设一个 flag 变量,然后将每次出栈的元素赋给 flag,当我们用 top 去访问右子树的时候,每次就看看 top->right == flag,若相等则说明刚才已经遍历过了,若没有的话就遍历右子树!
class Solution {
public:
    vector<int> postorderTraversal(TreeNode* root) {
        stack<TreeNode*> st;
        vector<int> v;
        TreeNode* cur = root;
        TreeNode* flag = nullptr; //用来标记是否走过该右子树的节点
        while(cur || !st.empty())
        {
            // 1、访问左路节点,左路节点入栈
            while(cur != nullptr)
            {
                st.push(cur);
                cur = cur->left;
            }

            // 2、依次取左路节点的右子树出来访问
            TreeNode* top = st.top();

            //若右子树为空或者右子树已经访问过了(top->right == flag),那么我们就可以访问栈顶元素了
            if(top->right == nullptr || top->right == flag)
            {
                st.pop();
                v.push_back(top->val);
                flag = top; //将top该点赋给flag,说明该点是走过的了
            }
            else
            {
                cur = top->right;
            }
        }
        return v;
    }
};
二叉树的后序遍历 ,非递归迭代实现。OJ链接