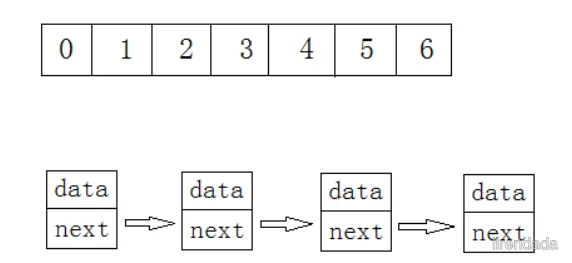
一、问题引入
这里有道题:给 40 亿个不重复的无符号整数,没排过序。给一个无符号整数,如何快速判断一个数是否在这 40 亿个数中。这里一共有三种方法:
- 遍历,时间复杂度
O(N) - 先排序
O(NlogN),然后利用二分查找:O(logN)
很明显发现前两种方法虽然可行,但是对于 40 亿个整数来说,内存开销是十分的大的,因为 40 亿个整数相当于是 16GB 左右,这个时候也更不可能去使用红黑树这些数据结构来解决,毕竟红黑树这些数据结构本身就带有一些负载的消耗(旋转),所以我们这里给出了第三种方法:位图!
二、位图概念
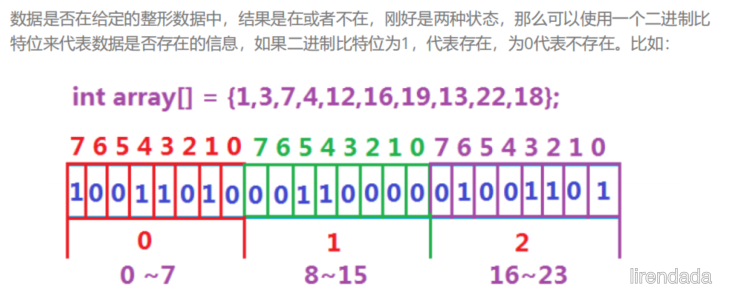
所谓位图,就是用每一位来存放某种状态,适用于海量数据,数据无重复的场景。通常是用来判断某个数据存不存在的。
比如上面的面试题,要我们开 40 亿个整数,并且判断一个数是否在这其中,那么我们只需要开辟 500MB 的空间大小,因为我们这里每个比特位代表一个数字存不存在的状态,比如 0 代表不存在,1 代表存在,那么一个比特位就足够啦,于是只需要开原本需要 16GB 的 1/32 即可,也就是 500MB!这就很巧妙的解决了空间问题!
而至于时间问题,查找某个数字的时候,位图也是通过某个数字的对应映射关系查找的,也就是通过哈希!所以时间复杂度为 O(1)。
三、位图的模拟实现
首先我们先把其框架搭出来:
// BitSet.h
#include <iostream>
#include <vector>
namespace liren
{
	class BitSet
	{
	private:
		std::vector<char> _bits;
	};
}
❓ 这里很奇怪哦,用到的是 vector 里面存的 char,为什么呢?
仔细想一想,c++ 中最小的存储单位就是 char,由于我们要的是按比特位来识别数字,所以我们这里就用 char 类型来表示 8 个比特位,也就是 8 个数字,这样子也方便我们后面的位运算!(用 int 类型来存储也可以,但是一共有 32 个比特位,相比于 char 的话会更难控制一些,所以这里选用 char)
❓ 那么我们接下来的拷贝构造函数中如何来初始化呢?
这里我们用模板参数 N 来代表要初始化的比特位个数,那么问题又来了,数组开多大的空间呢❓
🌛 由于我们数组中存放的类型是 char 类型,所以我们要得到 N 个比特位的话,则要 resize(N / 8),这里还有一个细节,就是还要多加一,因为假设 N 是 10 的话,那么 N / 8 其实还是 1,那么我们开出来的就只有一个 char 也就是 8 个比特位,但是 N 是 10 啊,所以为了保险起见,我们每次多开一个 char 的空间!也就是 resize(N / 8 + 1) !
// BitSet.h
#include <iostream>
#include <vector>
namespace liren
{
	// N代表要存放的比特位数量
	template <size_t N>
	class BitSet
	{
	public:
		// 构造函数
		BitSet()
		{
			// 每次多开一个字节,并初始化为0
			_bits.resize(N / 8 + 1, 0);
		}
	private:
		std::vector<char> _bits;
	};
}下面我们就来实现位图的几个主要的接口函数:(注意这里vs是小端,大端的实现略有不同)
set 函数:将 x 位置处的比特位设为 1
方法:先获取到 x 的位置,然后按位或上 x 处比特位为 1 的数即可。
// 将x位置处的比特位设为1
void set(size_t x)
{
    // 先获取x的位置
    size_t i = x / 8;
    size_t j = x % 8;

    // 接着让x处的比特位(按位或)上(只有x处为1的数)
    // 注意这里vs是小端存储,注意方向
    _bits[i] |= (1 << j);
}
reset 函数:将 x 位置处的比特位设为 0
方法:先获取到 x 的位置,然后让 x 处的比特位按位与(&)上 x 处比特位为 0 其他位为 1 的数即可。
// 将x位置处的比特位设为0
void reset(size_t x)
{
    // 先获取x的位置
    size_t i = x / 8;
    size_t j = x % 8;

    // 接着让x处的比特位(按位与)上(只有x处为0的数)
    // 注意这里vs是小端存储,注意方向
    _bits[i] &= (~(1 << j));
}
test 函数:检查 x 位置处的比特位是否为 1
// 检查x位置处的比特位是否为1
bool test(size_t x)
{
    // 先获取x的位置
    size_t i = x / 8;
    size_t j = x % 8;

    // 接着让x处的比特位(按位与)上(只有x处为1的数)
    return _bits[i] & (1 << j);
} 测试代码:
// test.cpp
#include "BitSet.h"

int main()
{
	liren::BitSet<20> t;

	t.set(10);
	std::cout << t.test(10) << std::endl;

	t.reset(10);
	std::cout << t.test(10);
	return 0;
} 接下来我们尝试着来解决上面遗留的面试题:
int main()
{
    // 40亿个整数,我们只需要开500MB的比特位即可
    // 但是为了保证int的范围都被包括,我们要开42亿整数空间的大小
    // 也就是unsigned的最大值
    // 但其实这里我们直接利用十六进制表示即可开unsigned的最大值
    //liren::BitSet<-1> b; 这种写法会报错

    liren::BitSet<0xffffffff> b;

    b.set(1314);
    std::cout << b.test(1314) << std::endl;

    b.reset(1314);
    std::cout << b.test(1314);

    return 0;
}

// 运行结果
1
0
四、位图的应用
-
快速查找某个数据是否在一个集合中
-
排序 + 去重
-
求两个集合的交集、并集等
-
操作系统中磁盘块标记
五、常见面试题
① 给定100亿个整数,设计算法找到只出现一次的整数?
这道题有两个思路:
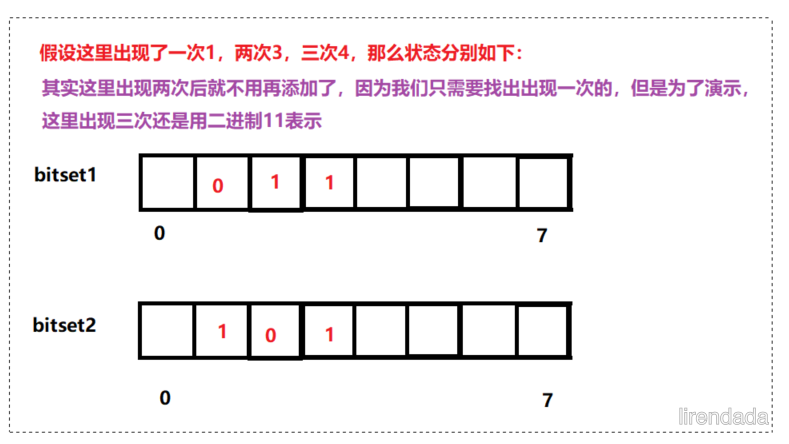
- 先来说第一个,因为100亿个整数,那么肯定会有重复的,那么状态肯定就不止是两种而是三种了:出现0次、出现1次、出现2次及两次以上,那么我们就得将我们的位图修改一下,将原来的一个比特位代表状态改为用两个比特位来表示状态,但是这种方法就得重写一遍我们的位图,所以这里我们使用第二种方法。
- 第二种方法就是使用两个位图的分别一个对应的比特位来表示这三种状态,那么这样子我们就可以复用我们的位图代码!
template <size_t N>
class TwoBitSet
{
    public:
    void set(size_t x)
    {
        // 如果两个比特位都是0,则出现0次
        if (!_bs1.test(x) && !_bs2.test(x))
        {
            // 将其变成出现1次
            _bs2.set(x);
        }
        // 如果出现一次,则_bs1为0,_bs2为1
        else if (!_bs1.test(x) && _bs2.test(x))
        {
            // 将其变成出现2次
            _bs1.set(x);
            _bs2.reset(x);
        }
    }

    void PrintOnceNum()
    {
        for (size_t i = 0; i < N; ++i)
        {
            if (!_bs1.test(i) && _bs2.test(i))
            {
                std::cout << i << " ";
            }
        }
        std::cout << std::endl;
    }
    private:
    BitSet<N> _bs1;
    BitSet<N> _bs2;
}; 测试代码:
int main()
{
    int a[] = { 99, 0, 4, 50, 33, 44, 2, 5, 99, 0, 50, 99, 50, 2 };
	liren::TwoBitSet<100> tbs;
	for (auto e : a)
	{
		tbs.set(e);
	}
	tbs.PrintOnceNum();
    return 0;
}

// 运行结果
4 5 33 44 注意:其实这里100亿个整数,我们也只需要 500MB,因为整数的范围只是到42亿左右,100亿个整数其实是包含了很多重复的数字而已!
② 给两个文件,分别有100亿个整数,我们只有1G内存,如何找到两个文件交集?
这里我们先说第一种常见的错误方法:就是将一个文件中的整数 set 到一个位图,读取第二个文件中的整数判断在不在位图中,在就是交集,不在就不是交集。
这个方法看起来似乎是对的,但是其实是错的,比如看以下例子:
int a1[] = {5, 30, 1, 99, 10};
int a2[] = {8, 10, 11, 9, 30, 10, 30, 10, 30}; 虽然遍历了 a1 的时候我们是用 set 去重了,但是遍历 a2 的时候我们并没有去重,那么当判断到 a2 中多组重复的数据的时候,照样会被打印出来,导致错误!
下面看一下正确的思路:
- 将一个文件中的整数
set到一个位图bs1,将另一个文件中的整数set到一个位图bs2- 遍历
bs2中的值,看在不在bs1中,在的话就是交集 bs1中的值依次和bs2中的值按位与,结果为1的位置值就是交集
- 遍历
// 这里使用的是直接遍历bs2,时间复杂度比较高
void FindIntersection()
{
	int a1[] = { 5, 30, 1, 99, 10 };
	const size_t n1 = sizeof(a1) / sizeof(a1[0]);
	int a2[] = { 8, 10, 11, 9, 30, 10, 30, 10, 30 };
	const size_t n2 = sizeof(a2) / sizeof(a2[0]);

	liren::BitSet<0xffffffff> bs1;
	liren::BitSet<0xffffffff> bs2;

	// 先将a1和a2放到两个位图中
	for (size_t i = 0; i < n1; ++i)
		bs1.set(a1[i]);
	for (size_t i = 0; i < n2; ++i)
		bs2.set(a2[i]);

	// 遍历bs2,看看是否在bs1中,在就是交集
	for (size_t i = 0; i <= 0xffffffff; ++i)
	{
		if (bs2.test(i))
		{
			if (bs1.test(i))
				std::cout << i << " ";
		}
	}
	std::cout << std::endl;
}
③ 位图应用变形:1个文件有100亿个int,1G内存,设计算法找到出现次数不超过2次的所有整数
这道题其实和第一道题是类似的,要表示不超过2次的整数,那么就是四种状态:00、01、10、11,所以用两个位图依然可以解决。
那么这种类型的题是可以拓展到不超过N次的所有整数的,比如找出不超过5次的所有整数,那么我们只需要3个位图即可,因为三个位图就是可以代表三个比特位也就是8种状态,以此类推……
Ⅱ. 布隆过滤器
二、布隆过滤器的提出
我们在使用新闻客户端看新闻时,它会给我们不停地推荐新的内容,它每次推荐时要去重,去掉那些已经看过的内容。问题来了,新闻客户端推荐系统如何实现推送去重的? 用服务器记录了用户看过的所有历史记录,当推荐系统推荐新闻时会从每个用户的历史记录里进行筛选,过滤掉那些已经存在的记录。 如何快速查找呢?
-
用哈希表存储用户记录,缺点:浪费空间
-
用位图存储用户记录,缺点:位图一般只能处理整形,如果内容编号是字符串,就无法处理了。
-
将哈希与位图结合,即布隆过滤器
二、布隆过滤器的概念
布隆过滤器是由布隆(Burton Howard Bloom)在 1970 年提出的 一种紧凑型的、比较巧妙的概率型数据结构,特点是高效地插入和查询,可以用来告诉你“某样东西一定不存在或者可能存在”,它是用多个哈希函数,将一个数据映射到位图结构中。此种方式不仅可以提升查询效率,也可以节省大量的内存空间。
布隆过滤器原理很简单:就是把一个字符串哈希成一个整数 key,然后选取一个很长的比特序列,开始都是 0,在 key 把此位置的 0 变为 1;下次进来一个字符串,哈希之后的值 key,如果在此比特位上的值也是 1,那么就说明这个字符串存在了
相比于传统的 List、Set、Map 等数据结构,它更高效、占用空间更少,但是缺点是其返回的结果是概率性的,而不是确切的。
三、布隆过滤器的结构
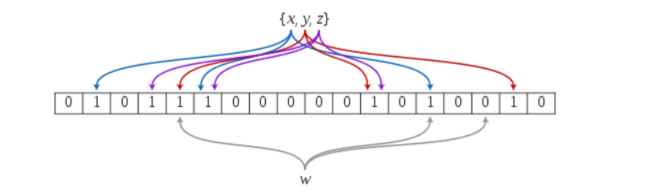
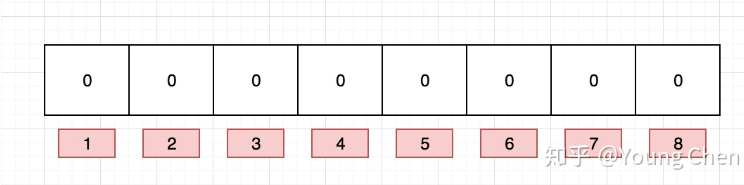
布隆过滤器是一个位向量或位数组,如下图所示:
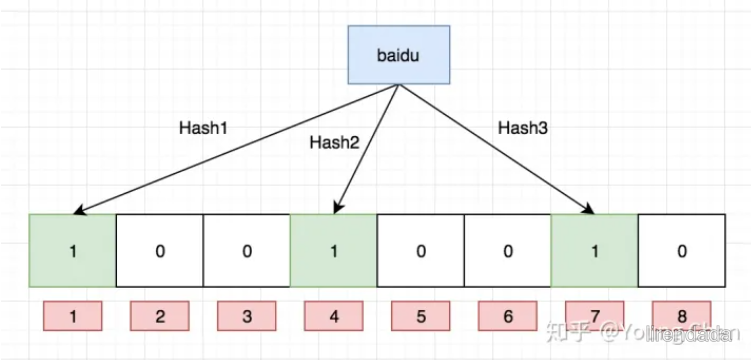
如果我们要映射一个值到布隆过滤器中,我们需要使用多个不同的哈希函数生成多个哈希值,并对每个生成的哈希值指向的 bit 位置 1,例如针对值 baidu 和三个不同的哈希函数分别生成了哈希值 1、4、7,则上图转变为:
Ok,我们现在再存一个值 tencent,如果哈希函数返回 3、4、8 的话,图继续变为:
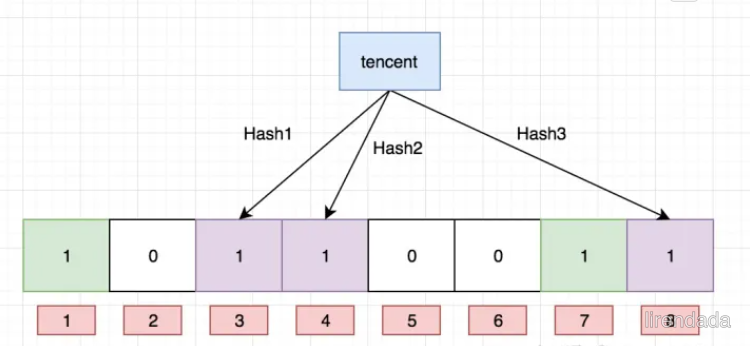
值得注意的是,4 这个比特位由于两个值的哈希函数都返回了这个比特位,因此它被覆盖了。现在我们如果想查询 dianping 这个值是否存在,哈希函数返回了 1、5、8 三个值,结果我们发现 5 这个比特位上的值为 0,说明没有任何一个值映射到这个 bit 位上,因此我们可以很确定地说 dianping 这个值不存在。而当我们需要查询 baidu 这个值是否存在的话,那么哈希函数必然会返回 1、4、7,然后我们检查发现这三个比特位上的值均为 1,那么我们可以说 baidu 存在了么?
答案是不可以,只能是 baidu 这个值可能存在。
这是为什么呢?答案跟简单,因为随着增加的值越来越多,被置为 1 的比特位也会越来越多,这样某个值 taobao 即使没有被存储过,但是万一哈希函数返回的三个比特位都被其他值置位了 1,那么程序还是会判断 taobao 这个值存在。
四、布隆过滤器的模拟实现
首先我们还是先把框架搭出来:
// BloomFilter.h
#include <iostream>
#include <string>
#include <bitset>
using std::cout;
using std::endl;
using std::string;
using std::bitset;

struct BKDRHash
{
	size_t operator()(const string& s)
	{
		// BKDR
		size_t value = 0;
		for (auto ch : s)
		{
			value *= 31;
			value += ch;
		}
		return value;
	}
};

struct APHash
{
	size_t operator()(const string& s)
	{
		size_t hash = 0;
		for (long i = 0; i < s.size(); i++)
		{
			if ((i & 1) == 0)
			{
				hash ^= ((hash << 7) ^ s[i] ^ (hash >> 3));
			}
			else
			{
				hash ^= (~((hash << 11) ^ s[i] ^ (hash >> 5)));
			}
		}
		return hash;
	}
};

struct DJBHash
{
	size_t operator()(const string& s)
	{
		if (s.size() == 0)   // 这是由本人添加,以保证空字符串返回哈希值0
			return 0;
		size_t hash = 5381;
		for (auto ch : s)
		{
			hash += (hash << 5) + ch;
		}
		return hash;
	}
};

namespace liren
{
    // N代表要开的比特位也就是要插入的数量
    // Factor是后面要与N相乘开空间的因子,是通过数学计算得来的
    // K默认是string
    // 下面的三个哈希函数,我们选用几个稍微不错的哈希算法,作为默认的参数使用
	template <size_t N,
    	size_t Factor = 5,
		class K = string,
		class HashFunc1 = BKDRHash,
		class HashFunc2 = APHash,
		class HashFunc3 = DJBHash>
	class BloomFilter
	{
	private:
		bitset<N * Factor> _bs;
	};
} 一般来说,哈希函数使用 2-5 个即可,不需要太多,不然误报率会提高,且空间占用率也会变大~
至于这里的 Factor 的大小,可以参考详解布隆过滤器的原理,使用场景和注意事项
我这里就将其公式贴出来即可:
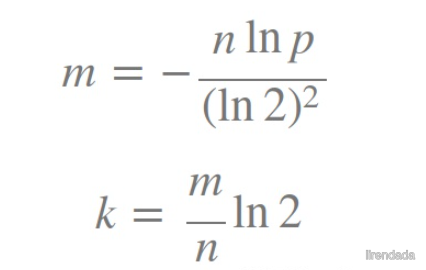

我们来计算一下,我们这里要得到的就是 m,那么将 ln2/n 移过去,就变成了 ,而这里 ln2 大概是 0.7, k 是 3(因为这里用三个哈希函数),所以最后得到
而由于 Factor 是 size_t 类型,所以我们就向上取整为 5,具体的数值是自由可以改变的,效果会不同~
这就是为什么我们的位图 bs 是开 <N * Factor> 的大小!
🌛 布隆过滤器越长其误报率越小,但是空间消耗越大
① 插入函数 Set
有了位图,其实实现起来很简单,就是先获取三个下标(因为使用了三个哈希函数),然后将下标处的值设为 1 即可,注意的是为了防止出界,我们需要模上 len 也就是我们位图的大小~
void set(const K& key)
{
    size_t len = N * Factor;
    // 由于我们使用三个哈希函数,所以要获取三个下标
    size_t index1 = HashFunc1()(key) % len;
    size_t index2 = HashFunc2()(key) % len;
    size_t index3 = HashFunc3()(key) % len;

    _bs.set(index1);
    _bs.set(index2);
    _bs.set(index3);
}
② 查找函数 Test
布隆过滤器的思想是将一个元素用多个哈希函数映射到一个位图中,因此被映射到的位置的比特位一定为 1。所以可以按照以下方式进行查找:分别计算每个哈希值对应的比特位置存储的是否为零,只要有一个为零,代表该元素一定不在哈希表中,否则可能在哈希表中。
🔺 注意:布隆过滤器如果说某个元素不存在时,该元素一定不存在,如果该元素存在时,该元素可能存在,因为有些哈希函数存在一定的误判。
比如:在布隆过滤器中查找 alibaba 时,假设 3 个哈希函数计算的哈希值为:1、3、7,刚好和其他元素的比特位重叠,此时布隆过滤器告诉该元素存在,但实该元素是不存在的。
bool Test(const K& key)
{
    size_t len = N * Factor;

    // 若下面有一个是为0则是不存在的
    size_t index1 = HashFunc1()(key) % len;
    if (_bs.test(index1) == 0)
        return false;

    size_t index2 = HashFunc2()(key) % len;
    if (_bs.test(index2) == 0)
        return false;

    size_t index3 = HashFunc3()(key) % len;
    if (_bs.test(index3) == 0)
        return false;

    return true; // 这里只能判断可能存在,不能判断绝对存在
}
③ 布隆过滤器的删除
布隆过滤器不能直接支持删除工作,因为在删除一个元素时,可能会影响其他元素。
比如:删除上图中 tencent 元素,如果直接将该元素所对应的二进制比特位置 0,baidu 元素也被删除了,因为这两个元素在多个哈希函数计算出的比特位上刚好有重叠。
一种支持删除的方法:将布隆过滤器中的每个比特位扩展成一个小的计数器,插入元素时给 k 个计数器(k 个哈希函数计算出的哈希地址)加一,删除元素时,给 k 个计数器减一,通过多占用几倍存储空间的代价来增加删除操作。
缺陷:
-
无法确认元素是否真正在布隆过滤器中
-
存在计数回绕
五、布隆过滤器的优点
-
增加和查询元素的时间复杂度为:
O(K)(K为哈希函数的个数,一般比较小),与数据量大小无关 -
哈希函数相互之间没有关系,方便硬件并行运算
-
布隆过滤器不需要存储元素本身,在某些对保密要求比较严格的场合有很大优势
-
在能够承受一定的误判时,布隆过滤器比其他数据结构有这很大的空间优势
-
数据量很大时,布隆过滤器可以表示全集,其他数据结构不能
-
使用同一组散列函数的布隆过滤器可以进行交、并、差运算
六、布隆过滤器的缺点
-
有误判率,即存在假阳性,即不能准确判断元素是否在集合中
-
不能获取元素本身
-
一般情况下不能从布隆过滤器中删除元素
-
如果采用计数方式删除,可能会存在计数回绕问题
七、布隆过滤器的应用场景
一般布隆过滤器应用在数据量大、需要节省空间、运行误判等场景,下面举两个例子:
- 比如说一个注册界面,需要用户填入昵称,这个时候我们就需要到数据库里面查找该用户输入的昵称是否存在,存在的话就显式红框框代表无法通过,不存在则通过,但是有个缺点,就是数据库的操作是在磁盘中的,速度非常的慢,那么这个时候我们就可以借助到布隆过滤器了! 我们可以先将数据库的数据映射到布隆过滤器,然后每次用户输入昵称的时候,先到布隆过滤器上判断,由于布隆过滤器只能确定不存在的情况,所以当用户输入的是不存在的昵称则直接通过,不需要和数据库打交道~如果输入的昵称是存在的,那么有可能结果是误判的,如果是允许存在误判的话,那么直接结束,如果不允许不存在误判的话,那么就再到数据库里面查找是否存在这个昵称! 我们通过布隆过滤器就节省了很多的索引时间,提高了效率!
- 比如说做一个邮箱的时候,我们需要一个垃圾邮箱过滤,那么这个时候我们也可以通过布隆过滤器,判断消息中是否存在需要入垃圾邮箱的关键字,是的话直接放入垃圾邮箱中~
八、布隆过滤器的面试题
给两个文件,分别有 100 亿个 query,我们只有 1GB 内存,如何找到两个文件交集?分别给出精确算法和近似算法
- 对于近似算法,那么我们用布隆过滤器就能解决了,因为题目要求是近似,也就是说,一些不是交集的
query,那么也是允许的,因为是近似算法。 - 对于精确的算法呢?好像布隆过滤器解决不了问题,那么就有了哈希切分,下面会讲解!
Ⅲ. 布谷鸟过滤器
一、布谷鸟过滤器由来
为了解决布隆过滤器不能删除元素的问题, 论文 《Cuckoo Filter:Better Than Bloom》 作者提出了布谷鸟过滤器。相比布谷鸟过滤器,布隆过滤器有以下不足:查询性能弱、空间利用效率低、不支持反向操作(删除)以及不支持计数。
- 查询性能弱是因为布隆过滤器需要使用多个
hash函数探测位图中多个不同的位点,这些位点在内存上跨度很大,会导致CPU缓存行命中率低。 - 空间效率低是因为在相同的误判率下,布谷鸟过滤器的空间利用率要明显高于布隆,空间上大概能节省
40%多。不过布隆过滤器并没有要求位图的长度必须是2的指数,而布谷鸟过滤器必须有这个要求。从这一点出发,似乎布隆过滤器的空间伸缩性更强一些。 - 不支持反向删除操作这个问题着实是击中了布隆过滤器的软肋。在一个动态的系统里面元素总是不断的来也是不断的走。布隆过滤器就好比是印迹,来过来就会有痕迹,就算走了也无法清理干净。比如你的系统里本来只留下
1kw个元素,但是整体上来过了上亿的流水元素,布隆过滤器很无奈,它会将这些流失的元素的印迹也会永远存放在那里。随着时间的流失,这个过滤器会越来越拥挤,直到有一天你发现它的误判率太高了,不得不进行重建。
布谷鸟过滤器在论文里声称自己解决了这个问题,它可以有效支持反向删除操作。而且将它作为一个重要的卖点,诱惑你们放弃布隆过滤器改用布谷鸟过滤器。
为啥要取名布谷鸟呢?
有个成语,「鸠占鹊巢」,布谷鸟也是,布谷鸟从来不自己筑巢。它将自己的蛋产在别人的巢里,让别人来帮忙孵化。待小布谷鸟破壳而出之后,因为布谷鸟的体型相对较大,它又将养母的其它孩子(还是蛋)从巢里挤走 —— 从高空摔下夭折了。
二、布谷鸟哈希
最简单的布谷鸟哈希结构是一维数组结构,会有两个 hash 算法将新来的元素映射到数组的两个位置。如果两个位置中有一个位置为空,那么就可以将元素直接放进去。但是如果这两个位置都满了,它就不得不「鸠占鹊巢」,随机踢走一个,然后自己霸占了这个位置。
p1 = hash1(x) % length
p2 = hash2(x) % length 不同于布谷鸟的是,布谷鸟哈希算法会帮这些受害者(被挤走的蛋)寻找其它的窝。因为每一个元素都可以放在两个位置,只要任意一个有空位置,就可以塞进去。所以这个伤心的被挤走的蛋会看看自己的另一个位置有没有空,如果空了,自己挪过去也就皆大欢喜了。但是如果这个位置也被别人占了呢?好,那么它会再来一次「鸠占鹊巢」,将受害者的角色转嫁给别人。然后这个新的受害者还会重复这个过程直到所有的蛋都找到了自己的巢为止。
三、布谷鸟哈希的问题
布谷鸟哈希会遇到一个问题,那就是如果数组太拥挤了,连续踢来踢去几百次还没有停下来,这时候会严重影响插入效率。这时候布谷鸟哈希会设置一个阈值,当连续占巢行为超出了某个阈值,就认为这个数组已经几乎满了。这时候就需要对它进行扩容,重新放置所有元素。
还会有另一个问题,那就是可能会存在挤兑循环。比如两个不同的元素,hash 之后的两个位置正好相同,这时候它们一人一个位置没有问题。但是这时候来了第三个元素,它 hash 之后的位置也和它们一样,很明显,这时候会出现挤兑的循环。不过让三个不同的元素经过两次 hash 后位置还一样,这样的概率并不是很高,除非你的 hash 算法太挫了。
布谷鸟哈希算法对待这种挤兑循环的态度就是认为数组太拥挤了,需要扩容(实际上并不是这样)。
四、布谷鸟哈希的优化
上面的布谷鸟哈希算法的平均空间利用率并不高,大概只有 50%。到了这个百分比,就会很快出现连续挤兑次数超出阈值。这样的哈希算法价值并不明显,所以需要对它进行改良。
改良的方案之一是增加 hash 函数,让每个元素不止有两个巢,而是三个巢、四个巢。这样可以大大降低碰撞的概率,将空间利用率提高到 95%左右。
另一个改良方案是在数组的每个位置上挂上多个座位,这样即使两个元素被 hash 在了同一个位置,也不必立即「鸠占鹊巢」,因为这里有多个座位,你可以随意坐一个。除非这多个座位都被占了,才需要进行挤兑。很明显这也会显著降低挤兑次数。这种方案的空间利用率只有 85% 左右,但是查询效率会很高,同一个位置上的多个座位在内存空间上是连续的,可以有效利用 CPU 高速缓存。
所以更加高效的方案是将上面的两个改良方案融合起来,比如使用 4 个 hash 函数,每个位置上放 2 个座位。这样既可以得到时间效率,又可以得到空间效率。这样的组合甚至可以将空间利用率提高到 99%,这是非常了不起的空间效率。
五、布谷鸟过滤器
布谷鸟过滤器和布谷鸟哈希结构一样,它也是一维数组,但是不同于布谷鸟哈希的是,布谷鸟哈希会存储整个元素,而布谷鸟过滤器中只会存储元素的指纹信息(几个 bit,类似于布隆过滤器)。这里过滤器牺牲了数据的精确性换取了空间效率。正是因为存储的是元素的指纹信息,所以会存在误判率,这点和布隆过滤器如出一辙。
首先布谷鸟过滤器还是只会选用两个 hash 函数,但是每个位置可以放置多个座位。这两个 hash 函数选择的比较特殊,因为过滤器中只能存储指纹信息。当这个位置上的指纹被挤兑之后,它需要计算出另一个对偶位置。而计算这个对偶位置是需要元素本身的,我们来回忆一下前面的哈希位置计算公式。
fp = fingerprint(x)
p1 = hash1(x) % length
p2 = hash2(x) % length 我们知道了 p1 和 x 的指纹,是没办法直接计算出 p2 的。
六、特殊的hash函数
布谷鸟过滤器巧妙的地方就在于设计了一个独特的 hash 函数,使得可以根据 p1 和 x 元素指纹直接计算出 p2,而不需要完整的 x 元素。
fp = fingerprint(x)
p1 = hash(x)
p2 = p1 ^ hash(fp) // 异或 从上面的公式中可以看出,当我们知道 fp 和 p1,就可以直接算出 p2。同样如果我们知道 p2 和 fp,也可以直接算出 p1 —— 对偶性。
p1 = p2 ^ hash(fp) 所以我们根本不需要知道当前的位置是 p1 还是 p2,只需要将当前的位置和 hash(fp) 进行异或计算就可以得到对偶位置。而且只需要确保 hash(fp) != 0 就可以确保 p1 != p2,如此就不会出现自己踢自己导致死循环的问题。
🚶♀️ 也许你会问为什么这里的 hash 函数不需要对数组的长度取模呢?实际上是需要的,但是布谷鸟过滤器强制数组的长度必须是 2 的指数,所以对数组的长度取模等价于取 hash 值的最后 n 位。在进行异或运算时,忽略掉低 n 位之外的其它位就行。将计算出来的位置 p 保留低 n 位就是最终的对偶位置。
Ⅳ. 哈希切分
还是上面这道题:给两个文件,分别有100亿个 query,我们只有 1GB 内存,如何找到两个文件交集?
由于 query 是字符串,并且是 100 亿个,内存占用非常的大,所以我们是不能将其放到 set 等数据结构中去找交集的,因为除了字符串的空间占用,set 等结构本身也是有负载消耗的。
那么我们这里尝试用一种方法:哈希切分
其实本质上就是将一个大文件通过哈希函数,切分为多个小文件,比如以下的例子:
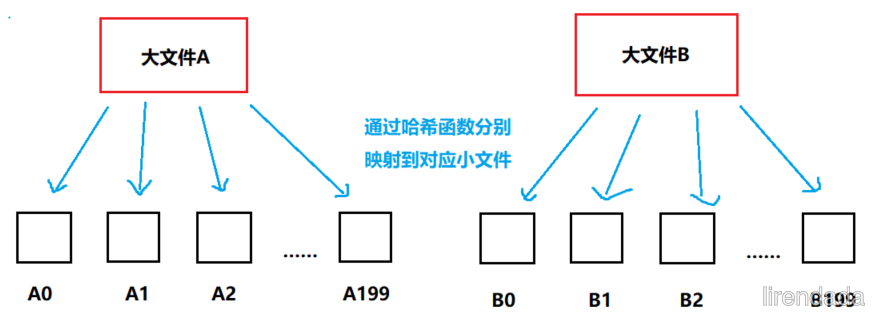
注意的是,我们只有 1GB 的内存大小,而 100 亿个 query 假设每个是 10字节,那么差不多就是 100GB 左右,那么我们每次要比较的是 Ai 和 Bi 小文件的交集,那么我们就像上图一样,每个大文件切分为 200 份,这样子的话每份就是 500MB 左右,大概能满足要求(后面会说如果内存不够的解决方法)
🔥 更要注意的是,上图是将 A 和 B 的 200 份都画出来了,其实我们每次只生成一份 Ai 和 Bi 而已,因为只有 1GB 内存,每次最多只够两个小文件比较,这点要注意!
接下来就是 Ai 与 Bi 的小文件找交集即可( A 和 B 中相同的 query 一定进入编号相同的小文件中,因为使用的哈希算法是一样的~),i 从 0 开始,直到 i 为切分的总数后结束!最后将所有的交集并起来即可~
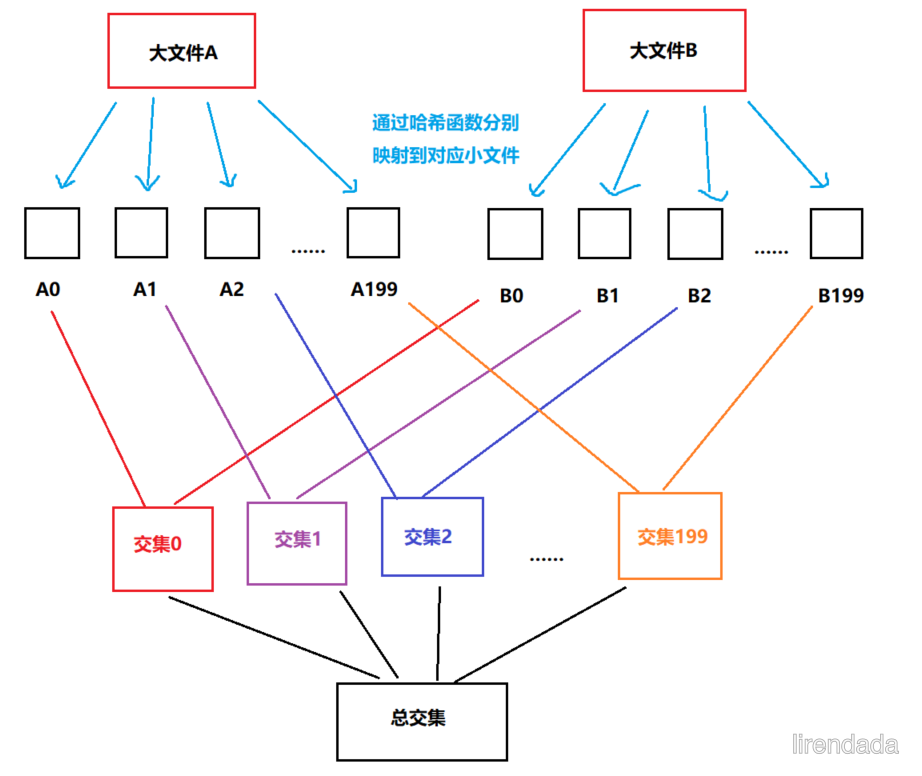
而我们切分的过程的公式就是 index = BKDRHash(query) % 200 (注意这里我们使用的BKDR,其他的也可以的~)
这就是哈希切分的思想以及应用~
❓ 遗留问题:那要是 Ai 和 Bi 都太大,超过了内存,那咋办?
🌛 解决方法:其实是因为这种哈希算法导致一个桶中的元素挂了太多,那这个时候就可以考虑换个哈希算法,再切分一次,一般来说两次是最多的了~
哈希切分的一道题
❓ 给一个超过 100GB 大小的 log file,log 中存着 IP 地址,设计算法找到出现次数最多的IP地址?除此之外如何找到 top K 的 IP?
💡 这道题很明显吧,海量数据,加上我们要处理的是 IP 地址也就是字符串,那么我们就可以考虑使用哈希切分的思想
第一问的做法:依次读取 IP,假设这里我们切分为 100 个小文件,那么每个就是 1GB,最后我们用 map 来统计次数的时候,1GB 还是比较可观的,切分更多也不是不可以,只不过这里切分 100 个为例子:
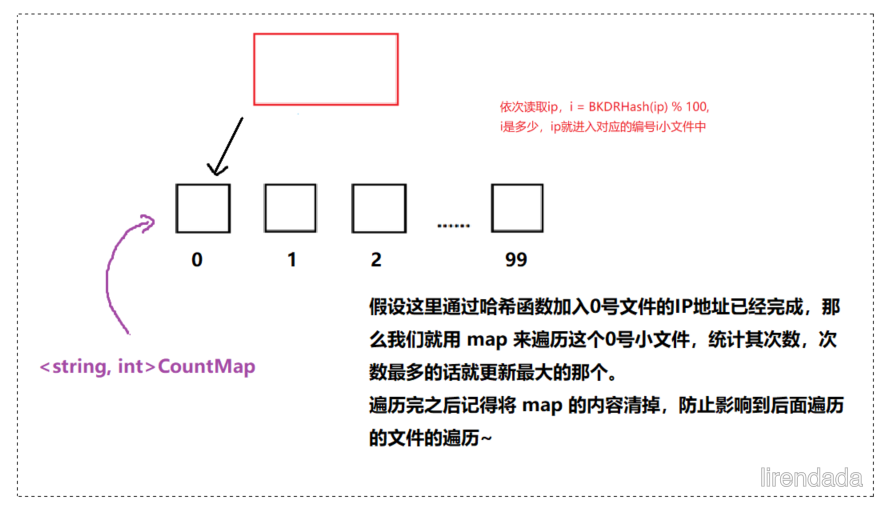
然后 0号小文件 遍历完之后,继续通过哈希函数将符合 1号小文件 的 IP 地址存入,然后 map 继续遍历统计,注意要记得更新最多次的那个(可以用一个变量保存),直到第 100 个小文件也遍历完成!
第二问的做法:第二问的前提思路和第一问是一样的,只不过第二问要的 topK 的 IP,所以我们使用的是 priority_queue<pair<string, int>, ...> 来存储每次的最大值,注意是用小堆来存最大值哦,这一点这里就不赘述了,详细的看优先级队列的讲解!