Ⅰ. 常见的锁策略
一、乐观锁 && 悲观锁
-
悲观锁 :每次取数据时,总是担心数据会被其它线程修改,所以会在取数据前先加锁 ,当其它线程想要访问数据时就会被阻塞。
-
典型案例 :数据库行锁、
synchronized、ReentrantLock -
优点 :在并发访问中保证了数据的一致性
-
缺点 :会造成较高的锁竞争,降低并发性能,因为当一个线程持有锁时,其他线程只能等待
-
-
乐观锁 :每次取数据时,总是乐观认为数据不会被其它线程修改,因此不会对数据进行上锁,而会采用 "忙等" 或者版本号机制来代替上锁 。通常在更新数据数据前,会判断其他数据在更新前有没有对数据进行修改,如果没有则进行更新操作,否则进行相应的补偿操作,
-
典型案例 :数据库版本号、
Atomic类(CAS)、时间戳机制 -
优点 :并发度高,因为不需要加锁,所以不会出现因为线程竞争导致的阻塞现象
-
缺点 :在高并发环境下,乐观锁的重试操作可能会比较频繁,导致性能下降。此外乐观锁的实现需要对数据进行版本号的维护,这需要增加额外的开销。
-
| 悲观锁 | 乐观锁 | |
|---|---|---|
| 吞吐量 | 低(锁竞争导致线程阻塞和上下文切换) | 高(无锁竞争,适合高并发读场景) |
| 冲突处理 | 直接阻塞,避免冲突 | 冲突时回滚或重试(自旋) |
| 适用场景 | 写操作频繁、冲突概率高(如银行转账、库存扣减) | 读操作为主、冲突概率低(如商品浏览、配置读取) |
| 死锁风险 | 高(需严格按顺序释放锁) | 无 |
| 实现复杂度 | 低(依赖数据库或语言原生锁) | 中(需设计版本号或CAS逻辑) |
二、重量级锁 && 轻量级锁
锁的核心特性 "原子性",这种机制追根溯源是 CPU 这样的硬件设备提供的:
-
CPU提供了 "原子操作指令" -
操作系统基于
CPU的原子指令, 实现了mutex互斥锁 -
JVM基于操作系统提供的互斥锁, 实现了synchronized和ReentrantLock等关键字和类
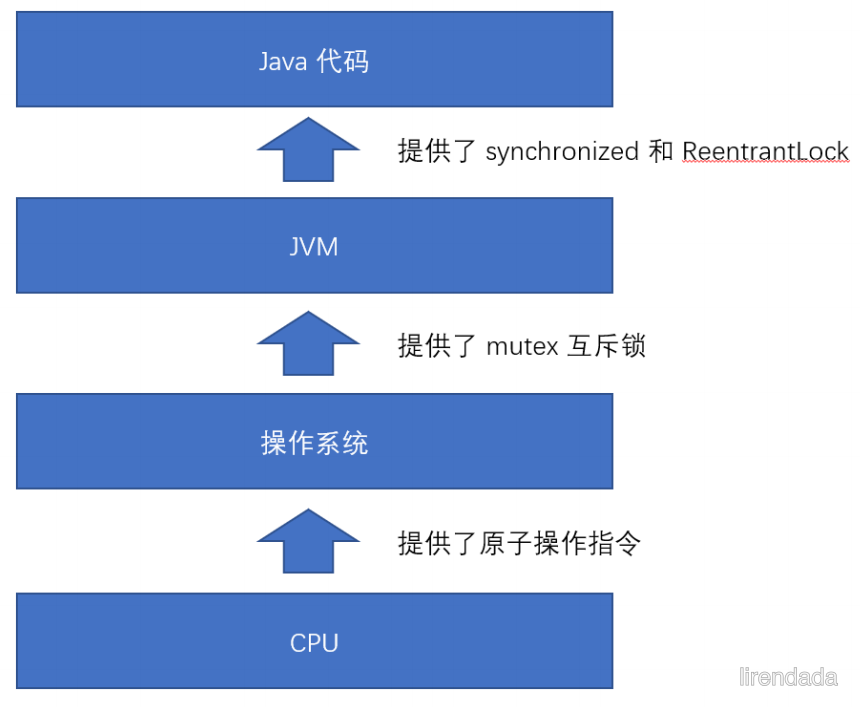
注意: synchronized 并不仅仅是对 mutex 进行封装,在 synchronized内部还做了很多其它的工作 ,下面会详细介绍!
-
重量级锁 :加锁机制重度依赖
OS提供的mutex-
大量的内核态与用户态切换
-
容易引发线程调度
-
-
轻量级锁 :加锁机制尽可能不使用
OS提供的mutex,而是尽量在用户态代码完成互斥操作 ,当实在搞不定的时候,才使用mutex。-
少量的内核态与用户态切换
-
不太容易引发线程调度
-
下面在介绍 synchronized 原理的时候会介绍两者的关系!
三、自旋锁 && 挂起等待锁
-
自旋锁 :在获取不到锁的情况下,不断地尝试获取锁,直到获取成功或者超过一定次数之后再进行等待 。
-
适用于锁被持有的时间比较 短 的情况 。例如在多处理器系统上使用自旋锁,因为在这种情况下,线程等待锁的时间很短,使用自旋锁可以避免线程切换的开销,提高性能。
-
所以自旋锁的缺点就是如果锁被持有的时间较长,那么就会持续消耗
CPU资源!
-
-
挂起等待锁 :在获取不到锁的情况下,线程会进入阻塞状态,让出
CPU,等待锁的持有者释放锁之后被唤醒 。-
适用于锁被持有的时间比较 长 的情况 。例如在单处理器系统上使用互斥锁,因为在这种情况下,线程等待锁的时间比较长,使用自旋锁会浪费大量的
CPU资源。 -
挂起等待锁的优点就是不会消耗
CPU资源,因为一旦阻塞就会让出CPU使用权!
-
四、公平锁 && 非公平锁
-
公平锁 :遵守 "先来后到" 规则 。比如
B比C先来,当A释放锁的之后,B先于C获取到锁。 -
非公平锁 :不遵守 "先来后到" 规则 。比如
B比C先来,当A释放锁的之后,B和C都有可能获取到锁。 -
这两种锁没有好坏之分,关键还要看适用场景!
五、可重入锁 && 不可重入锁
可重入锁:允许同一个线程多次获取同一把锁 ,反之则为不可重入锁。
Java 里只要以 Reentrant 开头命名的锁都是可重入锁,而且 JDK 提供的所有现成的 Lock 实现类,包括 synchronized 锁也是可重入的。
而 Linux 系统提供的 mutex 是不可重入锁。
六、读写锁
读写锁允许多个线程同时读取资源,但在写入资源时需要进行互斥访问 。
读写锁分为 共享锁(读锁) 和 排他锁(写锁) ,当一个线程获得共享锁时,其他其它线程也可以获得共享锁,但是不能获得排他锁;当一个线程获得排他锁时,其它线程无法获得共享锁和排他锁。
Java 标准库提供了 ReentrantReadWriteLock 类,实现了读写锁:
-
ReentrantReadWriteLock.ReadLock类表示读锁,这个对象提供了lock/unlock方法进行加锁解锁 -
ReentrantReadWriteLock.WriteLock类表示写锁,这个对象也提供了lock/unlock方法进行加锁解锁
Ⅱ. CAS
一、什么是 CAS❓❓❓
CAS(Compare-And-Swap,比较并交换) 是一种无锁 的原子 操作技术(乐观锁 ),用于在多线程环境下实现变量的线程安全修改 。它通过 CPU底层指令保证操作的原子性 ,避免了传统锁(如synchronized)带来的线程阻塞和上下文切换开销。
其伪代码如下所示:
注意:下面的伪代码并不是原子的,真实的
CAS是一个原子的硬件指令完成的 ,而下面的伪代码只是辅助理解CAS的工作流程!
**boolean CAS** (address, expectValue, newValue) {
    **if** (&address == expectValue) {
        &address = newValue; // 注意我们只关心address是否被修改,所以这里是赋值操作,真实场景应该是交换
        **return true** ;
    }
    **return false** ;
}
上面 CAS 函数中通常有三个参数:共享变量的内存地址 、期待值 、要修改的值 。其操作如下所示:
-
首先比较共享变量的值是否等于期待值(这个期待值往往是
address所指内存原来的值) -
如果相等,则将共享变量的值替换为新值,然后返回
true,表示操作成功! -
如果不相等,说明其它线程可能改变过这个期待值,则不执行任何操作(怕影响到其它线程),然后返回
false,这样子操作失败的线程就能获得一个失败的信号!
在这个过程中,CAS操作具有原子性 ,即其他线程无法同时访问共享变量,从而避免了竞态条件和数据竞争等问题。
二、CAS 的应用
Java 中 CAS 的底层实现依赖于 sun.misc.Unsafe 类(JDK 内部使用,不建议直接调用)。
Unsafe 提供了一系列 compareAndSwapXxx 方法(如 compareAndSwapInt、compareAndSwapObject),这些方法直接调用 CPU 的原子指令(如 x86 的 cmpxchg 指令),确保操作的原子性。
① 实现原子类
标准库中提供了 java.util.concurrent.atomic 包,里面的类都是基于这种方式来实现的。典型的就是 AtomicInteger 类,其中的 getAndIncrement 相当于 i++ 操作,如下所示:
**AtomicInteger count**  = **new AtomicInteger** (0);
System.*out*.println(count.getAndIncrement()); // 相当于i++
该函数的伪代码如下所示:
**class AtomicInteger**  {
    **private volatile int ** value; // 实际上存放在内存中,用volatile保持内存可见性

   ** public int getAndIncrement** () {
      **  int oldValue ** = value; // oldValue实际上存放在寄存器中

        // 如果value==oldValue,则说明没有线程改过,则赋值为OldValue+1,跳出循环,返回原先没有++的值
        // 如果value!=oldValue,则不进行赋值,收到false后进入循环更新oldValue,重新判断,直到数值相同
        **while** (CAS(value, oldValue, oldValue + 1) == **false** ) {
            oldValue = value;
        }
        **return ** oldValue;
    }
}💥注意事项:
CAS是直接读写内存的,即value一直存放在内存,而读写内存对于CAS来说是一条硬件指令,是原子的,这在上面代码中没有体现出来,但是要知道!
② 实现自旋锁
伪代码如下所示:
public class SpinLock {
    private Thread owner = null;

    **public void lock** (){
        *// 通过 CAS 判断当前锁是否被某个线程持有  *
        *// 如果这个锁已经被别的线程持有, 即this.owner!=null,那么就自旋等待  *
        *// 如果这个锁没有被别的线程持有, 那么就把 owner 设为当前尝试加锁的线程  *
        **while** (CAS(this.owner, null, Thread.currentThread()) == false){
        }
    }

   ** public void unlock**  (){
        this.owner = null;
    }
}三、CAS 存在的 ABA 问题
CAS 操作虽然可以保证对共享变量的原子性操作,但是由于 CAS 操作涉及到对共享变量的读取和修改,因此可能存在 ABA问题 ,即在多线程并发访问共享变量的情况下,共享变量的值在某个时刻被其它线程先改为 A,然后改为 B,最后又改为 A,从而导致一些问题 。
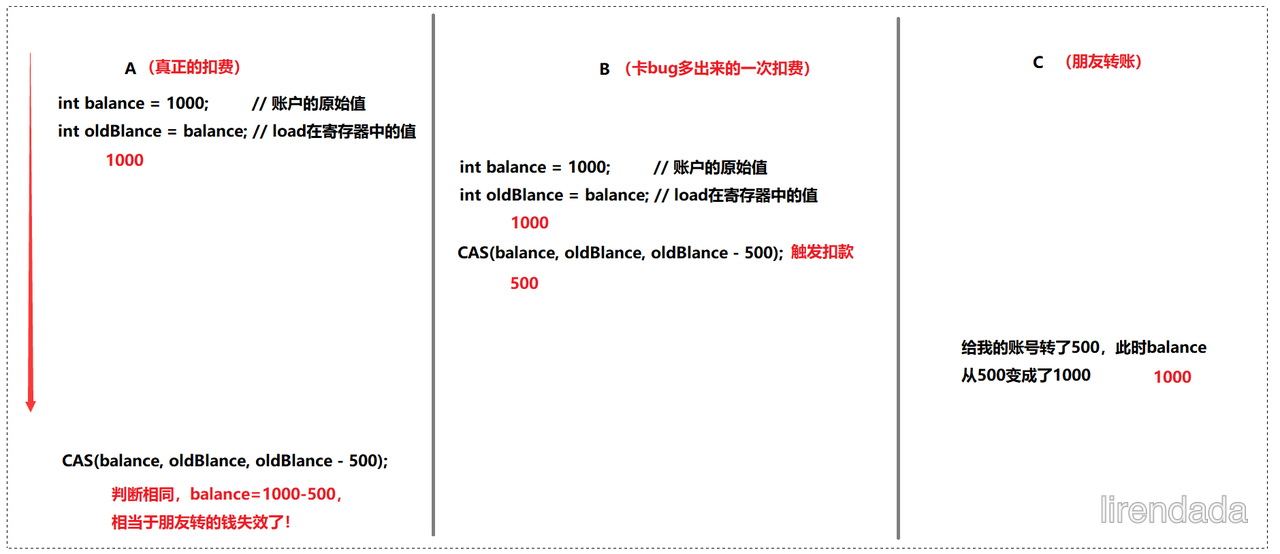
比如列举一个非常非常极端的例子,假设银行就是用 CAS 操作保证存钱、转账等操作是原子的,此时我去银行取 500 块钱,点击取钱按钮后,ATM 机会后台生成一个线程 A 去执行取钱操作,但是一不小心机器卡了,此时我就多点了一下取钱按钮,导致了后台可能创建了一个新线程 B,也去执行取钱操作,但我浑然不知,假设 B 比 A 提前完成了扣款操作。与此同时朋友给我银行转账了 500 块钱,执行的是线程 C,导致 balance 变成了 1000,在极端情况下,A 最后才完成了 CAS 操作,判断相同,又扣了 500 块钱,相当于朋友的钱被银行吃了!
如何解决这个问题❓❓❓
上述问题主要是由既有加操作,又有减操作引起的,只要我们让程序只能进行加操作,就能避免这种情况!
因此引入了版本号机制 ,约定每次修改操作,都需要对版本号加一 ,即在进行 CAS 操作时,不仅要比较共享变量的值是否等于期望值,还需要比较版本号是否匹配。这样可以确保即使共享变量的值在中间被修改过,但由于版本号不匹配,CAS 操作依然会失败,从而避免了上述问题的出现。
Ⅲ. synchronized 原理
一、基本特点
结合上面的锁策略,可以总结出 synchronized 具有以下特性(只考虑 JDK 1.8)
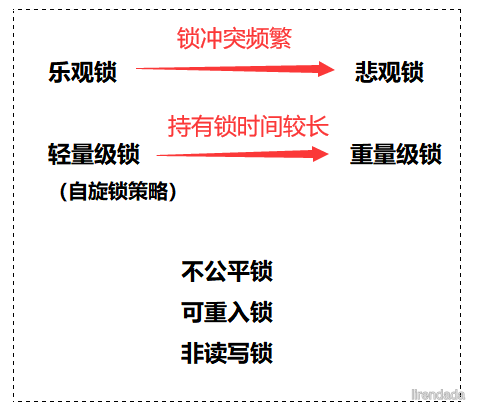
在底层实现上,synchronized 是通过 monitorenter 和 monitorexit 指令(字节码指令)来实现锁的获取和释放。
二、锁升级策略
在 JVM 中,对象的锁状态可以在运行时在 无锁 → 偏向锁 → 轻量级锁 → 重量级锁 之间逐级升级(不可降级 )。
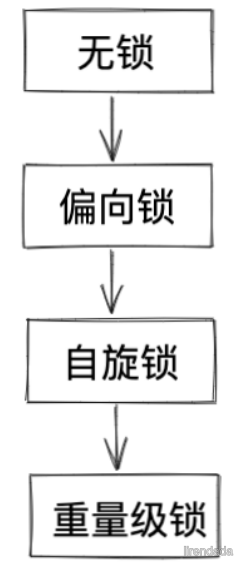
| 锁状态 | 特点 | 适用场景 |
|---|---|---|
| 无锁 | 默认状态,无同步需求 | 没有使用 synchronized |
| 偏向锁 | 只被一个线程使用过的锁 | 无线程竞争 |
| 轻量级锁 | 多线程并发,但竞争很小 | 多个线程交替执行同步块,对锁竞争小 |
| 重量级锁 | 多线程并发,且竞争严重 | 多个线程同时进入同步块,阻塞 |
① 偏向锁
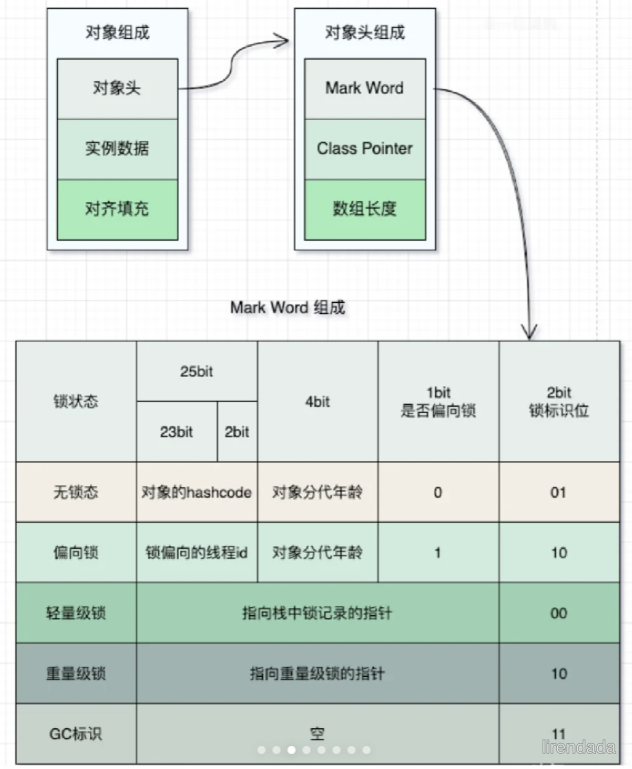
偏向锁 :不是真正的加锁,只是在对象头中标记锁信息为 "偏向锁" ,只有当其它线程也来竞争该锁的时候,才会取消偏向锁状态,转变为 "轻量级锁"。这样子做的好处有点像 "懒汉模式" 的延迟启动,尽量避免不必要的开锁开销 ,因为不一定真的有线程来竞争锁!
对象头结构 ** ** 是
JVM用来管理对象运行时信息的元数据容器,每个Java对象在内存中分为三部分 :
对象头 (
Header):存储锁状态、GC 分代年龄、哈希码等实例数据 (
Instance Data):对象的字段值对齐填充 (
Padding):补齐内存对齐
② 轻量级锁
偏向锁被第二个线程访问时会撤销并升级为轻量级锁,轻量级锁通过 CAS以及自旋来代替线程阻塞,减少用户态与内核态切换的成本 ,步骤可以参考上面介绍 CAS 中实现自旋锁的那段伪代码,逻辑差不多!
③ 重量级锁
如果竞争进一步激烈,自旋不能快速获取到锁状态,synchronized 就会自动转变为重量级锁,即采用内核提供的 mutex来保证线程安全 !步骤大概如下所示:
-
执行
mutex加锁操作,进入内核态 -
在内核态判定当前锁是否已经被占用
-
如果该锁没有占用,则加锁成功,并切换回用户态
-
如果该锁被占用,则加锁失败,此时线程被挂起,进入锁的等待队列,等待操作系统唤醒
-
经历了一系列的沧海桑田,这个锁被其它线程释放了,操作系统也想起了这个挂起的线程,于是唤醒这个线程,尝试重新获取锁!
三、锁消除
锁消除是 JVM 的一种优化技术,当编译器和 JVM检测到同步代码块实际上并不存在共享数据的竞争,则会直接移除对应的同步指令,提高效率 !
举个例子,本身就是线程安全的 StringBuffer,可能被一些程序员用 synchronized 加锁保护起来,但压根没必要加锁,所以这些代码实际上都会被移除!
四、锁粗化
锁粗化是 JVM 针对高频次加锁场景的优化技术,通过合并相邻的同步块来减少锁竞争和上下文切换的开销 。当编译器检测到多个连续的同步操作使用同一锁对象时(例如循环体内反复加锁或相邻代码段重复获取同一锁),会将多个细粒度的锁区域合并为一个更大的锁范围,从而将原本多次的加锁/解锁操作简化为单次操作。
举个很简单的例子,你有三个任务要向老板汇报,你分三次打电话过去汇报每个任务,和分一次去汇报三个任务的结果是一样的,但这个过程中显然后者更省力更高效!
Ⅳ. JUC (java.util.concurrent)
JUC 是 Java 标准库中用于并发编程的核心工具包 ,大概包含以下组件:
-
线程管理工具:
-
线程池:通过
ExecutorService、ThreadPoolExecutor等类实现高效的线程复用和任务调度 -
线程工厂:标准化线程创建行为(如命名、优先级)
-
-
同步与锁机制:
-
显式锁:
Lock接口(如ReentrantLock),支持更灵活的锁控制 -
条件变量:
Condition类实现线程间精细化的等待/唤醒机制
-
-
并发数据结构:
-
线程安全容器:如
ConcurrentHashMap、CopyOnWriteArrayList,兼顾性能与安全性 -
阻塞队列:
BlockingQueue接口支持生产者-消费者模式的高效实现
-
-
原子操作类:
AtomicInteger、AtomicReference等提供无锁化的线程安全数值操作
一、Callable 接口
Callable 接口是 Java 并发编程中用于表示可以由线程执行的任务的一种接口,它与 Runnable接口类似,但功能更强大 。
Callable是任务的生产者 ,负责定义需要执行的任务并生成结果;Future是任务的消费者 ,用于获取任务执行的结果或状态。两者通过 异步执行 和 结果传递 实现协作。
**@FunctionalInterface**
**public interface Callable** <V> {
    **V**  **call** () **throws ** Exception;
}| 特性 | Runnable | Callable |
|---|---|---|
| 返回结果 | 无 | 有 (泛型支持) |
| 抛出异常 | 不能抛出受检异常 | 可以抛出受检异常 |
| 核心方法 | void ``run``() |
V ``call``() throws Exception |
| 引入版本 | Java 1.0 | Java 5 |
相当于在 Runnable 的基础上,Callable 多了泛型返回值、异常处理的机制,更加强大!
① 用 Thread 启动任务,需要适配器类 FutureTask
在使用 Callable 的时候,由于 Thread类在构造的时候只能传入 Runnable,而不能直接传入 Callable,但可以通过使用 适配器类 FutureTask来作为桥梁搭建关系** 。
原因如下所示:
-
FutureTask实现了Runnable,可以塞进Thread -
FutureTask的构造函数接受Callable,可以让你写返回值逻辑 -
FutureTask实现了Future,你可以get()拿到结果
**public static void main** (String[] args) **throws ** Exception {
    Callable<String> cable = () -> {
        Thread.*sleep*(**1000** );
        **return ** "使用Callable执行完成";
    };

    *// 使用FutureTask包装Callable*
*    *FutureTask<String> ft = **new FutureTask** <>(cable);

    *// 传给Thread进行构造*
*   **** ** ***Thread thread ** = **new Thread** (ft);
    thread.start();

    *// 使用get()方法获取返回值*
*    ***String ret**  = ft.get();
    System.*out*.println("结果:" + ret);
}
② 线程池启动任务,需要使用接口 Future(推荐⭐⭐⭐)
Future是一个接口,表示 "未来某个时间的计算结果" ;而 FutureTask 是它的一个实现类,同时也实现了 Runnable。
实际开发中更推荐这种方式,如下所示:
**public static void main** (String[] args) **throws ** ExecutionException, InterruptedException {
 **   ExecutorService pool ** = Executors.*newFixedThreadPool*(5);

    *// submit一个Callable任务,然后返回Future<String>类型,需要强转*
*    *Future<String> ft = pool.submit(() -> {
        **try ** {
            Thread.*sleep*(**1000** );
            **return ** "使用Callable执行完成";
        } **catch ** (InterruptedException e) {
            **throw new ** RuntimeException(e);
        }
    });

    **String ret ** = ft.get();
    System.*out*.println("结果:" + ret);
}二、ReentrantLock
ReentrantLock 是一把可重入独占锁,相比 synchronized 来说使用方式要传统、复杂一点,但是更灵活强大,一般业务简单用 synchronized 足够,但并发复杂或需要更强控制力时,选 ReentrantLock。
① 常用方法
| 方法名 | 作用 | 说明 |
|---|---|---|
| lock() | 获取锁 | 不可中断,阻塞直到拿到锁 |
| unlock() | 释放锁 | 必须手动调用,一般写在 finally块中 |
| tryLock() | 尝试获取锁 | 不阻塞,立即返回 true/false,适合失败降级处理 |
| tryLock(long time, TimeUnit unit) | 限时尝试获取锁 | 在指定时间内等待,超时返回 false |
| lockInterruptibly() | 可中断地获取锁 | 允许在等待锁时响应中断(用于避免死锁 ) |
| isLocked() | 查询是否被锁定 | 返回当前锁是否被任意线程持有 |
| isHeldByCurrentThread() | 是否被当前线程持有 | 可用于调试/逻辑判断 |
| getHoldCount() | 当前线程持锁次数 | 多用于递归加锁场景 |
| newCondition() | 获取 Condition 条件变量 |
替代 Object.wait()/notify() 的高级用法 |
💥注意事项:
- 其中
lockInterruptibly()和lock()两者都会在获取不到锁的时候进行阻塞挂起,区别是如果发生了死锁,前者可以通过监测线程调用Thread.interrupt()来唤醒,破除循环等待条件 ;而后者没办法唤醒,如果发生了死锁的话则只能关闭线程等来挽救,损失比较大。
② 使用方式
-
对于
lock()和unlock():lock.lock(); // 尽量不要写在try里面,因为如果lock抛异常了,然后去finally中unlock的话,会直接报错的 **try ** { // 临界区 } **finally ** { lock.unlock(); } -
对于
trylock():**if ** (lock.tryLock()) { **try ** { // 获取锁成功 } **finally ** { lock.unlock(); } } **else ** { // 获取失败,降级处理;也可以搞个计数重新trylock,直到次数达到某个上限就退出 } -
对于
lockInterruptibly():**try ** { lock.lockInterruptibly(); // 被唤醒的话,会抛出InterruptedException,然后进行特殊处理即可 **try ** { // 临界区 } **finally ** { lock.unlock(); } } **catch ** (InterruptedException e) { // 响应中断逻辑(释放资源等) } -
配合条件变量:
Condition condition = lock.newCondition();

lock.lock();
**try ** {
    **while ** (!条件成立) {
        condition.await(); // 相当于 wait()
    }
    // 继续执行
    condition.signal(); // 相当于 notify()
} **finally ** {
    lock.unlock();
}
③ ReentrantLock 和 synchronized 的区别
| synchronized | ReentrantLock | |
|---|---|---|
| 基本功能 | JVM 内置关键字 |
JDK 提供的类 |
| 可重入性 | ✅ | ✅ |
| 可中断性 | ❌ | ✅ lockInterruptibly() |
| 尝试获取锁 | ❌ | ✅ tryLock() |
| 超时获取锁 | ❌ | ✅ tryLock(timeout) |
| 公平锁支持 | ❌ | ✅ 构造时指定 new ReentrantLock(true) |
| 必须手动释放锁 | ❌(自动) | ✅ 必须手动 unlock() |
| 条件变量 | 仅一个(wait/notify) |
支持多个独立的 Condition 对象(newCondition()) |
| 性能差异 | JVM优化后性能很好 |
功能强大但稍慢 |
如何选择使用哪个锁❓❓ ❓
-
锁竞争不激烈的时候,使用
synchronized,效率更高,自动释放更方便。 -
锁竞争激烈的时候,使用
ReentrantLock,搭配trylock()更灵活控制加锁的行为,而不是死等。 -
如果需要使用公平锁,使用
ReentrantLock。
三、 原子类 Atomic
Java 的原子类是 java.util.concurrent.atomic 包中的核心工具之一,用于在并发环境下进行线程安全的变量操作,利用了 CAS来实现,而不依赖 synchronized或锁机制,所以性能也比较高 !
下面是常见的原子类及其方法:
| 原子类 | 方法名 | 说明 |
|---|---|---|
| AtomicInteger / AtomicLong |
get() | 获取当前值 |
| set(newValue) | ||
| 设置新值 | ||
| getAndSet(newValue) | 获取旧值并设置新值 | |
| getAndIncrement() | ||
相当于 i++ |
||
| incrementAndGet() | 相当于 ++i |
|
| getAndAdd(delta) | ||
获取当前值后加 delta |
addAndGet(delta) | |
加 delta 后返回值 |
||
| compareAndSet(expect, update) | 原子条件更新 | |
| AtomicBoolean | get() | |
| 获取布尔值 | set(newValue) | |
| 设置布尔值 | ||
| compareAndSet(expect, update) | CAS 操作 |
|
| getAndSet(newValue) | ||
| 获取并设置布尔值 | AtomicReference |
get() |
| 获取引用 | ||
| set(newRef) | 设置引用 | |
| getAndSet(newRef) | ||
| 获取并替换引用 | ||
| compareAndSet(expect, update) | CAS 引用替换 |
AtomicIntegerArray / AtomicLongArray |
| get(index) | 获取指定位置的值 | |
| set(index, newValue) | ||
| 设置指定位置的值 | ||
| getAndIncrement(index) | 获取并自增指定位置的值 | |
| incrementAndGet(index) | 自增后返回值 | |
| compareAndSet(index, expect, update) | ||
CAS 更新某个位置的值 |
AtomicStampedReference |
四、信号量 Semaphore
Semaphore 是 信号量机制 的实现,用于控制对某些资源的访问数量。它的核心作用是:允许多个线程同时访问某个资源,但限制最大线程数 。
| 方法签名 | 返回值类型 | 说明 |
|---|---|---|
| Semaphore(int permits) | - | 创建一个非公平信号量,最多允许 permits 个许可 |
| Semaphore(int permits, boolean fair) | - | 创建一个公平或非公平信号量 |
| void acquire() | void | 获取一个许可,如果无可用许可则阻塞 |
| void acquire(int permits) | void | 获取多个许可,若不足则阻塞 |
| boolean tryAcquire() | boolean | 尝试获取一个许可,立即返回是否成功 |
| boolean tryAcquire(long timeout, TimeUnit unit) | boolean | 在给定时间内尝试获取许可,超时失败 |
| void release() | void | 释放一个许可,供其他线程使用 |
| void release(int permits) | void | 释放多个许可 |
| int availablePermits() | int | 返回当前可用许可数 |
| int drainPermits() | int | 一次性获取并清空所有许可,返回清空前数量 |
| boolean hasQueuedThreads() | boolean | 是否有线程在等待许可 |
| int getQueueLength() | int | 当前等待许可的线程数(估计值) |
典型场景一:限制时访问某个服务的线程数 (如 API 接口限流),避免系统因突发流量崩溃
Semaphore semaphore = **new**  Semaphore(100); // 允许 100 个并发请求
**public**  **void**  handleRequest() {
    semaphore.acquire();
    **try ** {
        // 处理请求
    } **finally**  {
        semaphore.release();
    }
}经典场景二:控制同时执行的任务数量 (如批量处理),平衡资源占用与处理效率。
// 限制同时处理的任务数为 5
Semaphore taskSemaphore = **new**  Semaphore(5);
**for**  (**int**  i = 0; i < 100; i++) {
    **new**  Thread(() -> {
        taskSemaphore.acquire();
        **try**  {
            processTask();
        } **finally**  {
            taskSemaphore.release();
        }
    }).start();
}经典场景三:协调生产者和消费者的执行节奏 ,避免生产者过快或消费者过慢导致的阻塞。
Semaphore emptySlots = **new**  Semaphore(10); // 缓冲区容量 10
Semaphore filledSlots = **new**  Semaphore(0);

// 生产者
**void**  produce() **throws**  InterruptedException {
    emptySlots.acquire();
    addToBuffer();
    filledSlots.release();
}

// 消费者
**void**  consume() **throws**  InterruptedException {
    filledSlots.acquire();
    removeFromBuffer();
    emptySlots.release();
}
五、倒计时锁存器 CountDownLatch
CountDownLatch 是一种 "倒计时锁存器",它可以让一个或多个线程等待,直到其它线程完成一组操作 。
形象地说:它就像一个倒计时器 ,初始值设为 N,每次 countDown() 值减 1,直到变成 0,所有等待的线程才会继续执行。
| 方法签名 | 返回类型 | 说明 |
|---|---|---|
| CountDownLatch(int count) | - | 构造函数,设置初始计数值 |
| void await() | void | 当前线程阻塞,直到计数器归零 |
| boolean await(long timeout, TimeUnit unit) | boolean | 等待指定时间,如果超时返回 false |
| void countDown() | void | 计数器减 1 |
| long getCount() | long | 获取当前计数器值 |
典型场景一:主线程需要汇总多个子线程的计算结果
CountDownLatch latch = **new**  CountDownLatch(3);
**for**  (**int**  i = 0; i < 3; i++) {
    **new**  Thread(() -> {
        // 子线程执行任务
        latch.countDown();
    }).start();
}
latch.await(); // 主线程等待所有子线程完成
System.out.println("所有子线程已完成,主线程继续执行");典型场景二:控制依赖程序启动顺序
ountDownLatch serviceLatch = **new**  CountDownLatch(3);
// 启动数据库服务
**new**  Thread(() -> {
    startDatabase();
    serviceLatch.countDown();
}).start();
// 启动缓存服务
**new**  Thread(() -> {
    startCache();
    serviceLatch.countDown();
}).start();
serviceLatch.await(); // 等待所有服务启动
startMainService();六、Semaphore、CountDownLatch、ReentrantLock 的区别
| 工具类 | 控制并发数量 | 等待阻塞 | 支持释放 | 可复用 | 公平性控制 |
|---|---|---|---|---|---|
Semaphore |
✅ | ✅ | ✅ | ✅ | ✅ |
CountDownLatch |
❌(用于等待) | ✅ | ❌ | ❌(一次性) | ❌ |
ReentrantLock |
❌(互斥) | ✅ | ✅ | ✅ | ✅ |
Ⅴ. 线程安全的集合类
一、常见的线程安全集合类
| 类别 | 常用类名 | 特点和说明 |
|---|---|---|
| 老版同步类(Java 1.0+) | Vector、 Hashtable |
方法基本都被 synchronized 修饰,性能较差,不推荐新项目使用 |
| 并发集合(java.util.concurrent) | ConcurrentHashMap、ConcurrentLinkedQueue、CopyOnWriteArrayList | 为并发设计,性能更优,是现代推荐的线程安全集合 |
| 同步包装类(Collections.synchronizedXXX) | Collections.synchronizedList(List synchronizedMap() 等 |
使用装饰器模式包装普通集合,实现线程安全,但使用时仍需手动同步遍历等操作 |
| 阻塞队列(BlockingQueue 系列) |
ArrayBlockingQueue、LinkedBlockingQueue、PriorityBlockingQueue、 DelayQueue等 |
内建锁机制,可用于线程间的安全通信,支持阻塞读写操作 |
💥注意事项:
-
ConcurrentLinkedQueue是一个高性能、线程安全的 非阻塞 队列 ,它采用CAS保证并发安全,是非阻塞队列的经典实现。 -
CopyOnWriteArrayList是一种具有 "写时拷贝 " 功能的容器,即每次修改操作(比如add/remove/set)都会创建一个新的数组副本 ,然后在这个副本上面进行修改,最后等到没有线程在读取数组的时候,才将引用指向这个新数组。-
适用场景: 读多写少
-
注意: 读操作不会加锁 ,而每次写操作都会复制数组,写操作非常昂贵 ,大量写操作会严重影响性能和内存。
-
-
synchronizedList是一种将普通List包装成线程安全版本的方式,原理是通过在所有操作的外部添加上synchronized关键字 来保证只有一个线程可以访问集合的方法~- 适合低并发、读写相当的场景,虽然读写操作是线程安全的,但是遍历的时候仍然需要手动加锁 。
二、Hashtable 与 ConcurrentHashMap 的区别
| Hashtable | ConcurrentHashMap(推荐⭐⭐⭐) | |
|---|---|---|
| 线程安全性 | ✅ | ✅ |
| 加锁策略 | 全表锁 | 读操作 :无锁 ,配合 volatile 读取保证内存可见写操作 :分段锁 (JDK7)或 桶锁+CAS (JDK8) |
| 扩容策略 | 由触发扩容的线程独自完成整个扩容过程,涉及到大量的元素拷贝,效率非常低 | 协作式扩容 ,即多个线程共同搬桶 (下面注意事项有过程) |
| 并发性能 | ❌ 性能差 ,每次读写都锁整个表 | ✅ 性能高 ,支持高并发读写 |
| null 键/值支持 | ❌ 键和值都不能为 null |
❌ 键不能为 null,值可以为 null |
| 迭代器是否 fail-fast | ❌ |
✅ 不会严格 fail-fast,本质属于 fail-safe即不抛异常,但也不保证看到实时最新数据 |
💥注意事项:
-
对于
Hashtable来说,它只是简单地在关键方法上添加了synchronized锁,粒度很粗,相当于给整个哈希表加锁,即所有读写操作都是互斥的,所以效率很低! -
对于
ConcurrentHashMap来说就不一样了,它是针对每个桶进行独立的加锁操作,在读操作时候甚至都不加锁,在写操作的时候会用上桶锁,此外在实现size()时候用CAS来保证一致性并且提高效率! -
协作式扩容的大概步骤 :
-
发现需要扩容的线程,只需要创建一个新的数组,同时只搬几个元素过去
-
整个扩容期间,新老数组同时存在
-
后续每个来操作
ConcurrentHashMap的线程,都会参与搬家的过程,每个操作负责搬运一小部分元素 -
搬完最后一个元素再把老数组删掉
-
这个期间,插入只往新数组加,查找则需要同时查新数组和老数组
-
所以协作式扩容整体是渐进式 的,而不是一次性阻塞所有线程来完成搬运 ,大大提高并发效率!
-
-
名词解释:
-
分段锁 :在
JDK 1.7中引入的,JDK 1.8中已经不再使用,简单的说就是把若干个哈希桶,分成一个段,然后针对每个段分别加锁 ,相比于桶锁来说效率要低,而且不灵活! -
fail-fast(快速失败) :遍历集合的同时对元素进行修改,则会抛出 ConcurrentModificationException,不支持并发读写。
-
fail-safe(快速成功) :遍历集合的同时对元素进行修改,不会抛出异常,反映了弱一致性,支持并发读写,适用于高并发场景。
-
Ⅵ. 死锁
一、死锁的案例
public class DeadlockExample {
    private static final Object lock1 = new Object();
    private static final Object lock2 = new Object();

    public static void main(String[] args) {
        Thread threadA = **new ** Thread(() -> {
            **synchronized ** (lock1) {
                System.out.println("Thread-A 持有 lock1");
                **try ** {
                    Thread.sleep(100); // 模拟操作耗时,增加死锁概率
                } **catch ** (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println("Thread-A 等待获取 lock2...");
                **synchronized ** (lock2) {
                    System.out.println("Thread-A 成功获取 lock2");
                }
            }
        });

        Thread threadB = **new ** Thread(() -> {
            **synchronized ** (lock2) {
                System.out.println("Thread-B 持有 lock2");
                **try ** {
                    Thread.sleep(100); // 模拟操作耗时,增加死锁概率
                } **catch ** (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println("Thread-B 等待获取 lock1...");
                **synchronized ** (lock1) {
                    System.out.println("Thread-B 成功获取 lock1");
                }
            }
        });

        threadA.start();
        threadB.start();
    }
}

// 程序会输出以下内容后卡住(死锁):
Thread-A 持有 lock1
Thread-B 持有 lock2
Thread-A 等待获取 lock2...
Thread-B 等待获取 lock1...
二、死锁的预防与避免
-
破坏互斥条件(不可行): 因为锁的互斥性是线程安全的基础,无法破坏。
-
破坏请求与保持条件: 线程一次性申请所有所需资源,未获取成功则释放已占资源
**synchronized** (lock1) { **if** (tryLock(lock2)) { // 尝试获取lock2 **try** { // 执行任务 } **finally** { unlock(lock2); } } } -
破坏不可剥夺条件: 允许线程主动释放已持有的锁,如
ReentrantLock.unlock()Lock lock = **new** ReentrantLock(); **if** (lock.tryLock()) { **try** { // 临界区 } **finally** { lock.unlock(); // 主动释放 } } -
破坏循环等待条件: 按固定顺序获取锁(全局锁排序)
// 定义锁的顺序 **private** **static** **final** Object[] locks = {lockA, lockB, lockC}; **public** **void** doWork() { Arrays.sort(locks); // 按对象哈希值排序 **synchronized** (locks[0]) { **synchronized** (locks[1]) { **synchronized** (locks[2]) { // 临界区 } } } } -
超时机制: 使用
Lock.tryLock(timeout, unit)设置超时时间**if** (lock1.tryLock(1, TimeUnit.SECONDS)) { **try** { **if** (lock2.tryLock(1, TimeUnit.SECONDS)) { **try** { // 执行任务 } **finally** { lock2.unlock(); } } } **finally** { lock1.unlock(); } } -
资源分配策略:
-
银行家算法:动态检测资源分配安全性,避免系统进入不安全状态(适用于实时系统)
-
锁分级:将锁按优先级分级,高优先级锁优先分配。
-
-
并发工具替代锁:
-
无锁数据结构:如
ConcurrentHashMap、AtomicInteger -
信号量
Semaphore:控制并发访问数量 -
CountDownLatch/CyclicBarrier:协调线程执行顺序,避免嵌套锁
-