在讲线程控制之前,我们必须先有一些基本认识的搭建!
我们之前讲过,在 linux 中是没有所谓的线程的,而是用一种 “轻量级进程” 来代替,但是我们以前创建新进程的时候,是通过 fork() 函数来实现的,难道我们创建线程的时候也要调用 fork() 吗❓❓❓
当然不是,但是 操作系统只能给我们提供创建轻量级进程的接口。为了解决 线程 与 “轻量级进程“ 之间的问题,可以说是概念不匹配的问题,而引入了多种原生线程库,这些库为我们提供了一系列的线程接口,让我们可以在 用户态 就能实现控制线程。
一、POSIX线程库 -- pthread库
POSIX 线程库(POSIX threads,简称 pthread)是一种标准的线程库,它实现了 POSIX 标准定义的线程 API,可以在多种操作系统上使用,包括 Linux、UNIX、MacOS 等。
POSIX 库提供了一系列的函数来创建、同步和销毁线程,绝大多数函数的名字都是以 pthread_ 打头的,比如 pthread_create()、pthread_join()、pthread_mutex_init()、pthread_cond_wait()等等。这些函数可以帮助程序员实现线程的创建、同步和协作等操作。
二、调用前提🎍
- 要使用这些函数库,必须引入头文件
<pthread.h> - 使用
gcc等编译器链接这些线程函数库时,要使用编译器命令的-lpthread选项
三、用户态线程和内核级线程的区别
【用户级线程】和【内核级线程】的主要区别在于它们的执行上下文和调度方式。
【用户级线程】是由用户空间的线程库实现的,它们的执行上下文(寄存器、栈、程序计数器等)保存在用户进程的虚拟地址空间中,因此线程的切换是由线程库完成的。用户态线程的调度也是由线程库完成的,它们被调度时只能在当前进程的上下文中运行,因此如果某个用户态线程执行了一个耗时的操作,它可能会阻塞整个进程。
【内核级线程】是由操作系统内核实现和管理的,它们的执行上下文保存在内核空间中,因此线程的切换是由内核完成的。内核级线程的调度也是由内核完成的,它们被调度时可以在任何进程的上下文中运行,因此一个内核级线程阻塞不会影响其他线程的执行。
在一些系统中,用户态线程和内核级线程可能存在一定的混合模式,比如 Linux 中的轻量级进程。轻量级进程在内核中被表示为内核级线程,但是由用户态线程库来创建和管理,因此轻量级进程的执行上下文保存在用户进程的虚拟地址空间中,线程的切换也是由线程库完成的。但是由于轻量级进程是由内核来调度的,因此它们的调度方式与内核级线程相似,可以在任何进程的上下文中运行。
除了上述区别之外,用户态线程和内核级线程还有以下区别:
- 调度方式:内核级线程的调度是由内核来完成的,而用户态线程的调度则是由用户程序自己来完成的。
- 系统调用:内核级线程在进行系统调用时会切换到内核态,而用户态线程在进行系统调用时会导致整个进程被阻塞,因为用户态线程是没有直接访问系统调用接口的权限的,需要通过系统调用将控制权交给内核来完成。
- 线程切换:内核级线程在进行线程切换时,需要保存和恢复整个进程的状态,开销较大。而用户态线程在进行线程切换时,只需要保存和恢复当前线程的状态,开销较小。
- 调试和性能分析:由于内核级线程是由内核来管理和调度的,因此在进行调试和性能分析时,需要使用内核级工具来进行分析。而用户态线程则可以使用用户态工具进行分析。
总之,用户态线程和内核级线程都有各自的优缺点,选择何种方式取决于应用的具体情况。
Ⅱ. 线程控制
一、创建线程pthread_create()
// 功能:创建一个新线程
// 返回值:成功返回0;失败返回错误码,并且*thread的值是未定义的
int pthread_create (pthread_t *thread, const pthread_attr_t *attr, void*(*start_routine)(void *), void *arg);
参数如下:
- thread:存储线程
ID,也就是线程标识符! - attr:设置线程的属性,
attr为NULL表示使用默认属性。 - start_routine:函数指针,代表线程启动后要执行的函数。
- arg:传给线程启动函数也就是
start_routine的参数。
其中 pthread_t 和 pthread_attr_t 的声明如下:
typedef unsigned long int pthread_t; // 用于存放线程ID的

union pthread_attr_t
{
    char __size[__SIZEOF_PTHREAD_ATTR_T]; // __SIZEOF_PTHREAD_ATTR_T其实就是一个宏,为56
    long int __align;
}; 💥💥注意:pthread.h 头文件中的 pthread_t 类型在定义时被 typedef 为无符号长整型 unsigned long int,这样做是为了向后兼容早期的 POSIX 标准和老旧的系统实现。在一些旧的 POSIX 实现中,pthread_t 类型可能是一个无符号长整型,而不是一个不透明的结构体类型。
然而,在现代的 Linux 系统和标准 POSIX 线程库实现中,pthread_t 类型被定义为一个不透明的结构体类型。应用程序应该使用 POSIX 线程库提供的函数来操作 pthread_t 类型的值,而不是直接访问或修改它的内部成员。因此,虽然 pthread_t 类型在定义时被 typedef 为无符号长整型,但实际上它是一个不透明的结构体类型。
下面我们写一段代码来创建新线程:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cassert>
using namespace std;

// 新线程执行的函数
void* thread_routine(void* arg)
{
    char* mes = static_cast<char*>(arg);
    while(true)
    {
        cout << "我是新线程,我正在运行:" << mes << endl;
        sleep(1);
    }
}

int main()
{
    pthread_t thread;
    // 创建新线程
    int n = pthread_create(&thread, nullptr, thread_routine, (void*)"new thread");
    assert(n == 0);
    static_cast<void>(n); // 防止realse下报错

    // 主线程执行
    while(true)
    {
        cout << "我是主线程,我正在运行" << endl;
        sleep(1);
    }
    return 0;
}
这是一个刚接触线程编程经常遇到的一个问题,我们在上面讲过了,我们调用的 pthread_create() 以及后面我们所学的线程接口,其实都不是操作系统提供的,而是应用层提供的,所以我们在编译的时候必须显式的加上 -lpthread 选项表示链接线程库才行!

可以看到,成功链接线程库后,跑出来的结果就是我们的主线程和新线程两个线程在跑,那么我们可以用什么方式来观察两个线程呢❓❓❓
🛺 ps命令的 -L 选项
ps -a 命令是用来列出系统上所有进程的详细信息,包括它们的 PID(进程ID)、PPID(父进程ID)、状态(R表示正在运行,S表示休眠,Z表示僵尸进程等)、CPU利用率、内存占用等信息。
其中,加上 -L 查看轻量级进程的信息。如果不加 -L 选项,则只列出进程的主线程。这个命令可以帮助我们了解系统上运行的所有进程和线程,方便进行进程和线程的调试和管理。
另外,加上 ps 命令的 -f 选项可以以全格式显示进程信息,包括进程的 UID、PID、PPID、LWP、C、NLWP、STIME、TTY、TIME、CMD 等信息。
💥💥💥注意:ps -L 命令中显示的 LWP ID 是在内核态中分配的轻量级进程的 ID。
下面我们通过监控脚本来观察一下:
while :; do ps -afL | head -1 && ps -afL | grep mythread; sleep 1; done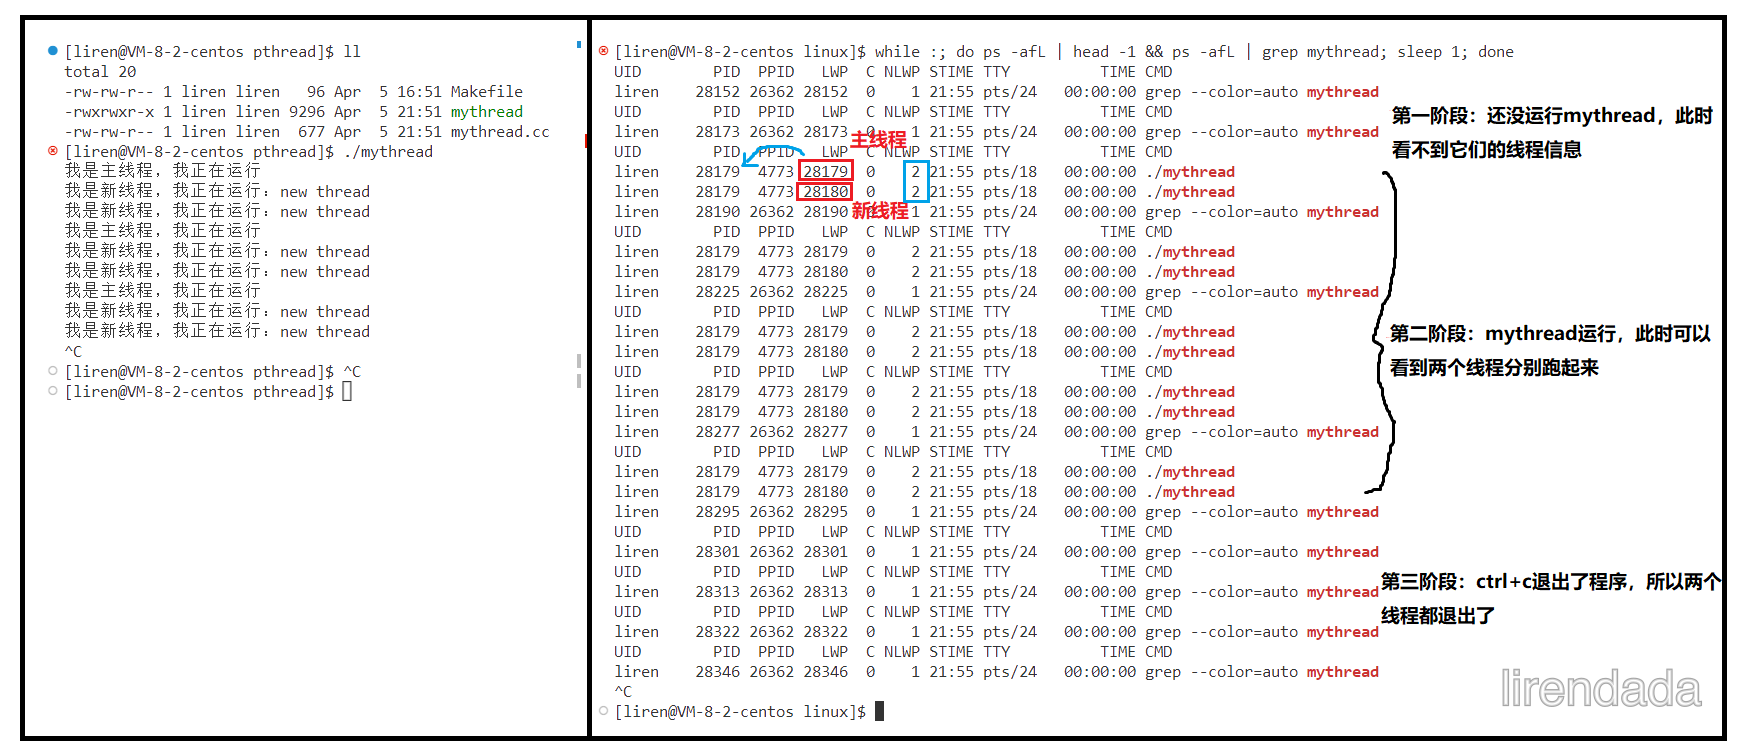
可以看到上述结果中,两个线程的 PID 都是相同的,也就是进程 ID 相同,但是它们的 LWP 是不同的,线程之间就是用 LWP 来区分不同的线程的!
除此之外,可以看到主线程的 LWP 与 PID 是一致的,都是 28179,这样子也验证了我们以前在讲进程的时候,单线程的进程的 PID 和 LWP 也是相同的,完全不违背我们现在所学的知识!
除此之外,还可以看到 NLWP 的大小为 2,代表当前这个进程内一共有两个线程,也就是两个执行流!总结下来就是:
- LWP:代表线程ID,既
gettid()系统调用的返回值。 - NLWP:代表线程组内线程的个数
gettid() 和 线程组 下面会讲到,别急这里开始的知识点比较绕,阅读时候一定要仔细思考,想清楚了就不难了~!
☢️ 线程ID 与 进程ID
上面我们通过 ps -aL 指令可以看到线程的 PID 和 LWP,PID 我们知道这是进程的一个标识符,那这个 LWP 呢❓❓❓
其实这里的 LWP 并不是全称,这里表达的意思是:LWP ID,也就是轻量级进程的 ID,每个轻量级进程都被内核赋予了一个唯一的 LWP ID,用于标识不同的轻量级进程。
LWP ID 与 线程ID 是等价的,它们指向同一个轻量级进程。
❗除此之外,在 Linux 中,轻量级进程 LWP 的 ID 确实是在内核中分配和管理的。在用户态中,轻量级进程是由 POSIX 线程库创建和管理的,而轻量级线程库则负责将 POSIX 线程映射到内核的 LWP 上,从而将用户态线程转换为轻量级进程。因此,LWP ID 的管理是由内核负责的。
所以我们通过 ps -L 看到的 LWP 是内核级别的线程 ID。
🎏 线程组的引入
没有线程之前,一个进程对应内核里的一个进程描述符,对应一个进程ID。但是引入线程概念之后,情况发生了变化,一个用户进程下管辖 N 个用户态线程,每个线程作为一个独立的调度实体在内核态都有自己的进程描述符,进程和内核的描述符一下子就变成了 1:N 关系,POSIX 标准又要求进程内的所有线程调用 getpid 函数时返回相同的进程ID,如何解决上述问题呢?
这个时候 Linux 内核引入了 线程组 的概念:
多线程的进程(又被称为线程组),线程组内的每一个线程在内核之中都存在一个进程描述符(task_struct)与之对应。进程描述符结构体 task_struct 中的 pid,表面上看对应的是 进程ID,其实它对应的是 线程ID 也就是 LWP ID。进程描述符 task_struct 中的 tgid,含义是 Thread Group ID,该值对应的是用户层面的 进程ID,也就是咱们之前学进程的时候其实接触的一直都是这个 tgid,就是我们认为的进程ID。
struct task_struct
{
	pid_t pid;              // 进程或线程的ID,更具体的说法是轻量级进程的ID
    pid_t tgid;             // 轻量级进程组ID,线程的tgid等于进程的pid

    struct list_head tasks;  // 双向链表,用于管理进程或线程
    struct mm_struct *mm;    // 进程或线程的地址空间信息
    struct task_struct *parent;  // 父进程的task_struct结构体指针
    struct files_struct *files;  // 进程或线程的文件描述符表
    struct signal_struct *signal;  // 进程或线程的信号处理器信息
    // ... 其他成员,如进程或线程的状态、优先级等信息
}; 上面进程 ID 与线程 ID 的区别如下表所示:
| 用户态 | 系统调用 | 内核进程描述符中对应的数据 |
|---|---|---|
| 进程ID | pid_t getpid() | pid_t tgid |
| 线程ID | pid_t gettid() | pid_t pid |
对于 gettid() 的调用,其实我们不是直接使用这个接口,只不过这个接口名字会比较好认,真正调用的是 syscall() 接口来获取!
#include <unistd.h>
#include <sys/syscall.h>
int syscall(int number, ...);

// 作用:间接调用系统调用
// 返回值:由正在调用的系统调用定义。通常,返回值为0表示成功;-1返回值表示错误,错误代码存储在errno中。 为了能够获得内核的线程 ID,我们需要给 syscall() 接口传递一个参数:SYS_gettid。
下面我们还是拿上面的代码,只不过我们这次打印出内核的线程 ID 来验证一下:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <sys/syscall.h> // 调用syscall需要引入该头文件
#include <cassert>
using namespace std;

// 新线程执行的函数
void* thread_routine(void* arg)
{
    char* mes = static_cast<char*>(arg);
    while(true)
    {
        cout << "LWP: " << syscall(SYS_gettid) << " 我是新线程,我正在运行:" << mes << endl;
        sleep(1);
    }
}

int main()
{
    pthread_t tid;
    // 创建新线程
    int n = pthread_create(&tid, nullptr, thread_routine, (void*)"new thread");
    assert(n == 0);
    static_cast<void>(n); // 防止realse下报错

    // 主线程执行
    while(true)
    {
        cout << "LWP: " << syscall(SYS_gettid) << " 我是主线程,我正在运行" << endl;
        sleep(2);
    }
    return 0;
}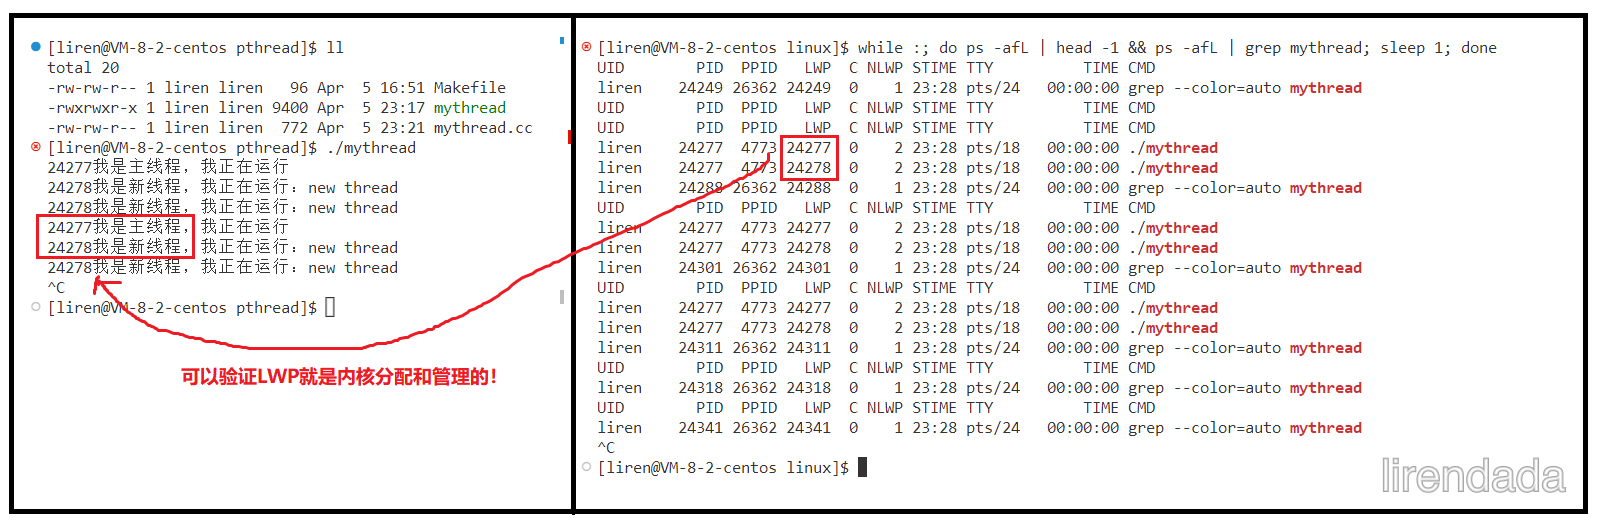
💥💥注意:gettid() 函数获取的是内核级别轻量级进程的ID,这和后面我们讲的 pthread_self() 并不一样,pthread_self() 获取的是用户态线程的ID,两者并不相同!且 gettid() 是系统调用,而 pthread_self() 是线程库提供的第三方接口!
这个我们下面讲 pthread_create() 的返回值就能理解它们的不同之处了!
☢️☢️强调一点:线程和进程不一样,进程有父进程的概念,但在线程组里面,所有的线程都是对等关系。 不存在父线程子线程的说法!
🧨 线程库 && 线程库进程地址空间布局
还记得我们上面调用的 pthread_create() 中第一个参数类型 pthread_t 吗,我们说过,它可能是一个无符号长整形或者一个结构体,在这里它是一个无符号长整形,接下来我们将它打印出来,看看它到底是个什么东西:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cassert>
using namespace std;

// 新线程执行的函数
void* thread_routine(void* arg)
{
    while(true)
    {
        sleep(1);
    }
}
int main()
{
    pthread_t tid;
    int n = pthread_create(&tid, nullptr, thread_routine, (void*)"new thread");
    assert(n == 0);
    static_cast<void>(n); // 防止realse下报错,这里使用c++11推荐的类型转换

    // 主线程执行
    while(true)
    {
        // 打印tid的信息
        cout << " 我是主线程,我正在运行, my tid: " << tid << endl;
        sleep(2);
    }
    return 0;
}

// 运行结果:
[liren@VM-8-2-centos pthread]$ ./mythread
 我是主线程,我正在运行, my tid: 140228457703168
 我是主线程,我正在运行, my tid: 140228457703168
 我是主线程,我正在运行, my tid: 140228457703168
 我是主线程,我正在运行, my tid: 140228457703168
^C
[liren@VM-8-2-centos pthread]$ 是不是很奇怪,tid 是一串啥都不像的数字,有点像身份证一样哈哈,但是其实并不是的!

这里就不卖关子了,其实这是一个地址,我们得一步一步来谈起!
其实在 linux 中,我们是可以通过系统调用来创建线程也就是所谓的轻量级进程,通过一个接口 clone() 来实现:
#include <sched.h>
int clone(int (*fn)(void *), void *child_stack, int flags, void *arg, ...
/* pid_t *ptid, struct user_desc *tls, pid_t *ctid */ ); 包括我们以前的 fork() 函数,其实本质都是调用了 clone() 函数,只不过是允不允许虚拟地址空间等资源共享的问题而已!
除此之外,其实还有一个 vfork() 接口,它的作用其实也是创建一个轻量级进程,只不过我们很少用它!
但是这个 clone() 接口用起来比较复杂,加之一个原因:程序员在理解上只认线程,而不认所谓的轻量级进程的概念。为了解决使用复杂而且概念不同的问题,就有了我们之前所讲的在用户态分配和管理线程的线程库(如 pthread 库),而我们上面的这个 pthread_t 类型就是属于 pthread 库的结构内的!
我们都知道,为了管理线程(注意:线程库是基于内核中的轻量级进程进行管理的,本质还是管理内核中的进程结构,只不过是在用户态中管理),我们必须对线程库进行数据封装,也就是遵循:先描述,再组织。
最后形成的一个层次结构就如下图所示:
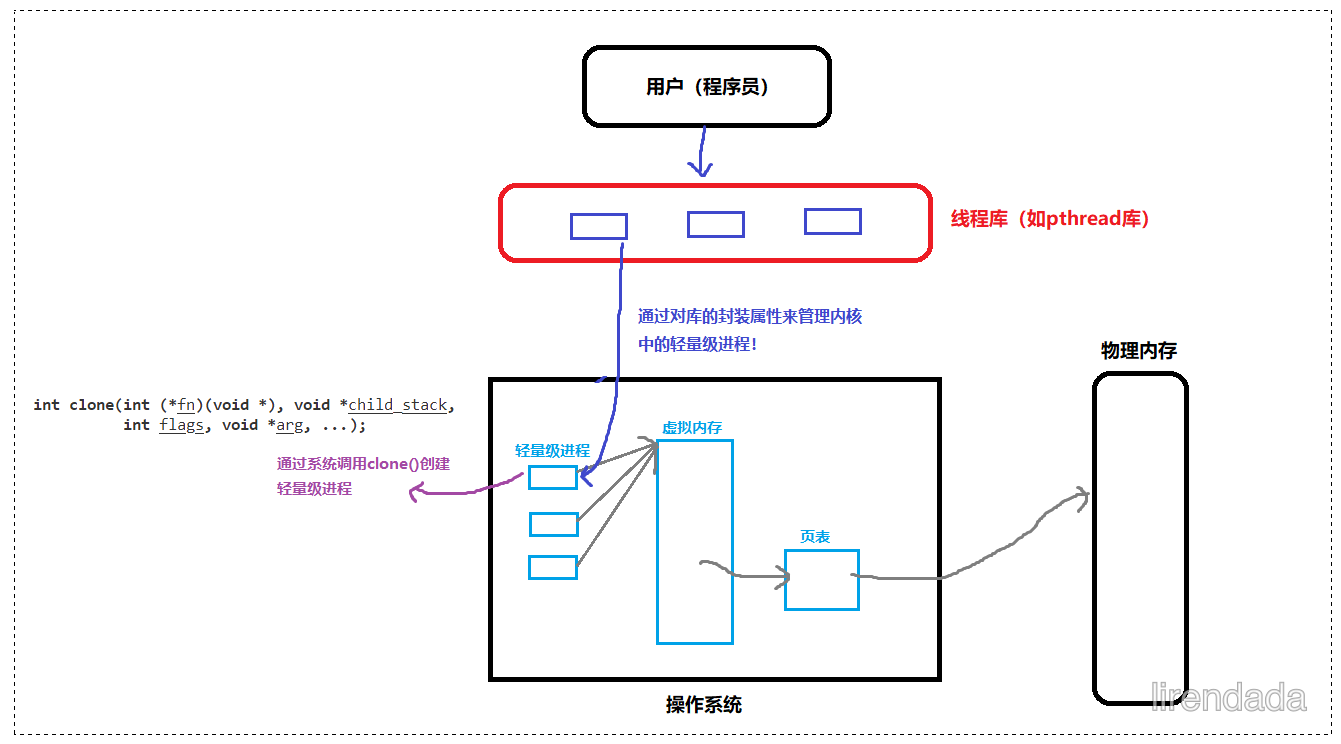
那么既然线程库需要封装,那么肯定就需要知道对应的内核中轻量级进程ID等等,但是我们也可以明白封装的线程属性其实不是很多,因为我们其实都可以通过系统调用进程的接口查看大部分的属性,因为这些属性大部分都是共享的,我们针对封装的属性其实大多数都是线程私有的属性! 而其中就包括了我们上面的 pthread_t 类型!
linux 的实现方案:用户关心的线程属性都在线程库中,也就是 用户级线程,而内核提供线程执行流的调度!
换言之用户只需要关心这个线程是哪个线程,线程的独立栈的大小包括其它线程的属性等等,而不需要我们去关心底层是怎么调度的,让用户感觉起来就像是调用了原生线程一般的感受!
其中内核时通过系统调用接口 clone() 来创建轻量级进程的,并且还记得我们上面提到过的 pthread_attr_t 结构体吗,其实它就是线程库中对于轻量级进程的属性封装,一般来说我们设置其为空即可,表示以默认的属性创建!
下图则是线程库 libpthread.so 加载到内存中,对应虚拟地址空间上的布局:
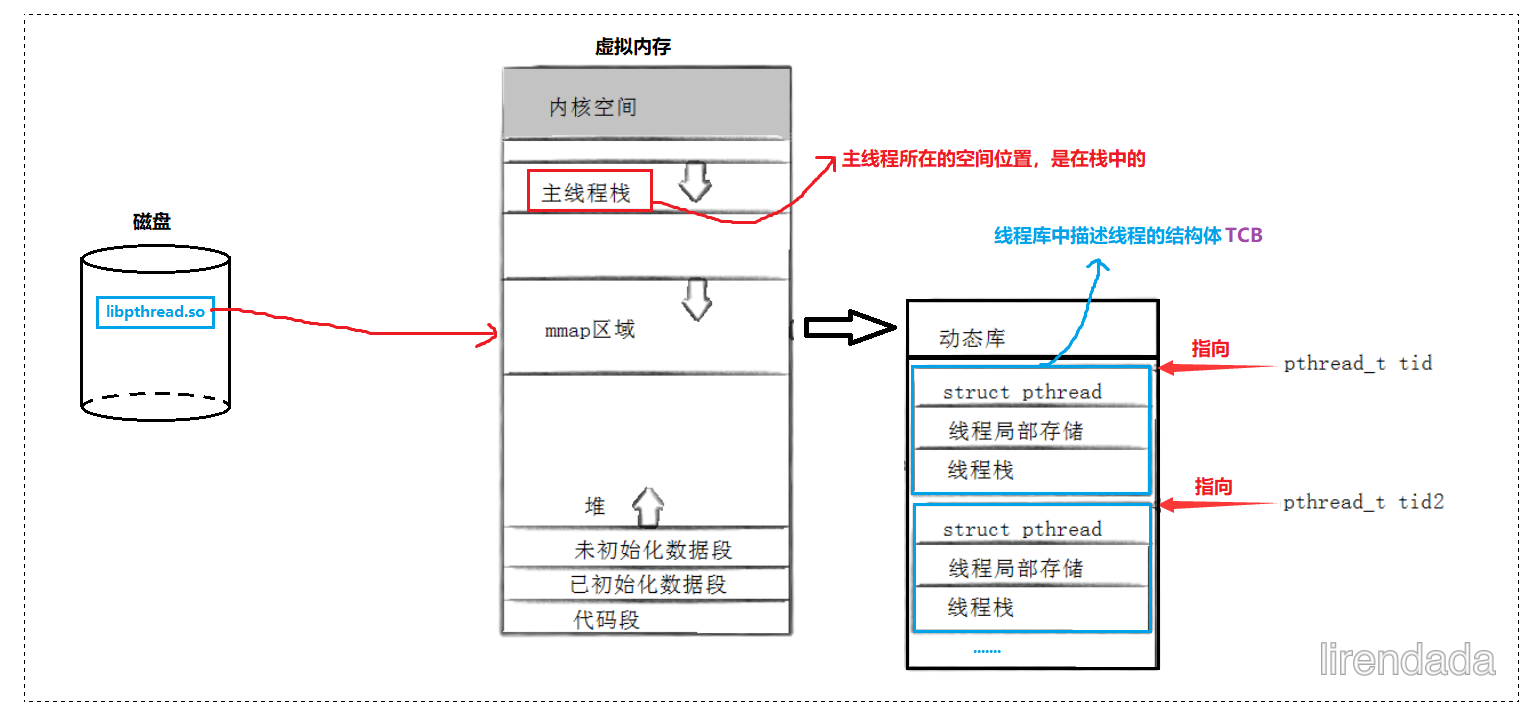
在
Linux中,mmap区域是进程虚拟地址空间中的一段用于映射文件或者其他设备的内存区域。mmap是一种内存映射机制,它可以将一个文件或者设备映射到进程的虚拟地址空间,使得进程可以像访问普通内存一样来访问文件或设备中的内容。mmap区域通常被用于实现共享内存、动态库等功能。mmap区域在进程的虚拟地址空间中通常是以一段连续的地址空间来表示,这个地址空间的大小和内容会随着不同的mmap操作而发生变化。在Linux中,mmap区域通常被管理在进程的虚拟地址空间的 堆(heap)段和 栈(stack)段之间。
mmap区域可以分为私有和共享两种。私有mmap区域只能被当前进程访问,不会被其他进程所共享;而共享mmap区域则可以被多个进程访问,实现了多进程间的共享内存。共享mmap区域通常用于进程间通信(IPC)和共享内存数据结构。
使用 pthread 库创建的线程,其实是在用户空间中创建了一个线程控制块TCB(Thread Control Block),然后通过系统调用将线程控制权交给内核,内核根据线程控制块创建一个轻量级进程LWP,并在 LWP 中运行该线程。因此,POSIX 线程库实现的是用户空间中的线程,但这些线程是由内核中的轻量级进程调度和管理的。
所以最后我们就能知道,原来这个 pthread_t 类型的变量,就是一个在虚拟地址空间中 mmap 区域的目标 TCB 的起始地址! 通过这个地址我们就能找到对应的线程控制块进行管理!
剩下的线程栈、局部存储我们会在后面讲的时候不断接触到,会不断提及!
在
Linux操作系统中,线程的独立栈是由操作系统为每个线程分配的内存空间,用于存储线程执行时所需的数据和函数调用信息等。而线程的独立栈的最大空间可通过ulimit命令进行设置和查看 在一般情况下,
Linux操作系统中线程的独立栈的最大空间默认值为8192KB(即8MB)。这意味着,当一个线程需要申请内存空间时,如果超出了该线程独立栈的最大空间限制,则会发生栈溢出错误。 需要注意的是,线程的独立栈最大空间并不代表线程可以使用的最大内存空间。线程可以通过操作系统提供的内存管理机制向进程申请更多的内存空间,但是这些内存空间通常是动态分配的并不属于线程的独立栈
总之,在
Linux操作系统中,线程的独立栈最大空间默认值为8192KB,但可以通过 ulimit 命令进行修改。
二、获取用户态线程ID
#include <pthread.h>
pthread_t pthread_self();

// 功能:获取当前调用的用户态线程ID
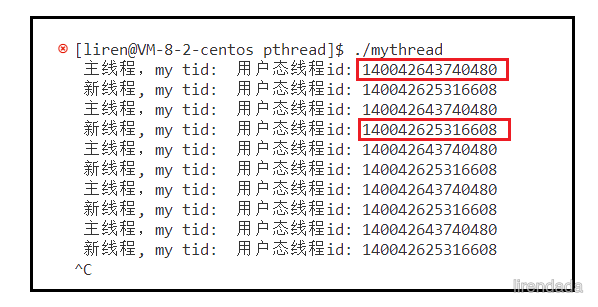
// 返回值:该函数总是调用成功,返回用户态线程ID 注意,要区分开 用户态线程ID 和我们上面所讲的 内核轻量级进程ID,这是两码事,这里的 用户态线程ID 指的是线程库中对应 TCB 的 ID,不要搞混了!
一般如果我们要去获取 内核轻量级进程ID 的话,都是通过 syscall(SYS_gettid) 来实现的,需要引入头文件 <sys/syscall.h>,我们在上面讲过,可以翻阅上面笔记阅读!
下面是 pthread_self() 的测试代码:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cassert>
using namespace std;

// 新线程执行的函数
void* thread_routine(void* arg)
{
    while(true)
    {
        cout << " 新线程, my tid: " << " 用户态线程id: " << pthread_self() << endl;
        sleep(1);
    }
}
int main()
{
    pthread_t tid;
    // 创建新线程
    int n = pthread_create(&tid, nullptr, thread_routine, (void*)"new thread");
    assert(n == 0);
    static_cast<void>(n); // 防止realse下报错,这里使用c++11推荐的类型转换

    // 主线程执行
    while(true)
    {
        cout << " 主线程,my tid: " << " 用户态线程id: " << pthread_self() << endl;
        sleep(1);
    }
    return 0;
}
🎏 创建多个线程的情况
在讲线程等待之前,我们先来写段代码,创建一批线程,进行一些操作,下面我们先来看第一种写法:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <vector>
#include <string>
#include <cstdio>
using namespace std;

// 新线程执行的函数
void* thread_routine(void* arg)
{
    string name = static_cast<char*>(arg); // 将namebuffer解析出来
    while(true)
    {
        cout << "新线程, name: " << name << endl;
        sleep(1);
    }
}
int main()
{
    for(int i = 0; i < 10; ++i) // 创建10个线程
    {
        pthread_t tid; // 局部变量
        char namebuffer[64];
        snprintf(namebuffer, sizeof namebuffer, "%s, %d", "thread", i+1); // 格式化字符串,写到namebuffer中去
        pthread_create(&tid, nullptr, thread_routine, namebuffer); // 创建新线程,将namebuffer传过去
    }

    // 主线程执行
    while(true)
    {
        cout << " 主线程running" << endl;
        sleep(1);
    }
    return 0;
}
结果是不是和我们想的不一样,明明应该是每个线程分别为 1-10 中的其中一个呀,为啥都是 10 呢❓❓❓
其实这就涉及到的不只是多线程的问题,还涉及到了函数栈帧的问题了!
这段代码的问题在于在主线程循环创建新线程时,将字符串指针 namebuffer 传递给了新线程,但在主线程的循环中,namebuffer 的地址会不断变化,而新线程可能在主线程修改 namebuffer 后才开始执行,因此可能会导致新线程输出错误的字符串。
但是又因为堆栈的问题,这个 namebuffer 出了作用域销毁之后,这段栈帧就销毁了,但是下一次 for 循环的时候进来的时候,重新定义一个 namebuffer,此时这个栈帧还是和刚才一样的位置,导致我们的 i 此时修改的时候,刚才这个栈帧的该位置处的 i 也被修改了,最后 name 打印出来的数据就不是原来的 i,而是被修改之后的!
解决方法是为每个新线程创建独立的字符串空间,即堆空间,并将字符串拷贝到该空间中,保证新线程中使用的字符串不会被其他线程修改。可以通过 new 来创建一个堆对象,这样子的话出了作用域也不会自动销毁,而是需要我们手动释放才会销毁,这样子就不会出现这种问题!
或者我们可以让主线程在创建完新线程之后 sleep 一会,都是可以的,但是一般不这么做!
下面采用第一种方法来解决:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cstdio>
using namespace std;

struct ThreadData
{
    pthread_t _tid;
    char _namebuffer[64];
};

// 新线程执行的函数
void* thread_routine(void* arg)
{
    ThreadData* td = static_cast<ThreadData*>(arg); // 将arg转化为ThreadData*
    int cnt = 10; // 局部变量,每个线程独立占有
    while(cnt)
    {
        // 顺便将cnt打印出来
        cout << "新线程, name: " << td->_namebuffer << " cnt: " << cnt-- << " &cnt:" << &cnt << endl;
        sleep(1);
    }
    delete td;
    return nullptr;
}

int main()
{
    for(int i = 0; i < 10; ++i) // 创建10个线程
    {
        ThreadData* td = new ThreadData(); // 定义的是堆对象
        snprintf(td->_namebuffer, sizeof td->_namebuffer, "%s, %d", "thread", i+1); // 格式化字符串
        pthread_create(&td->_tid, nullptr, thread_routine, td->_namebuffer); // 创建新线程,将存放字符串的数组传过去
    }

    // 主线程执行
    while(true)
    {
        cout << " 主线程running" << endl;
        sleep(1);
    }
    return 0;
}
从上面的程序我们还顺便打印了 cnt,可以看到每个线程中的 cnt 都是独立的,它们的地址都是不同的,很显然不是同一个 cnt,说明了线程存在独立栈结构,验证了我们上面所提及的线程库中为每个线程分配的栈空间!
三、线程终止
线程的终止通常有以下几种方法:
- 正常/提前结束:线程运行到代码结束或者从主线程中被显式地结束,即通过调用 pthread_exit() 函数或者 return 语句来结束线程。
- 异常结束:一个线程在运行过程中发生异常或者错误,导致整个进程的非正常结束。如调用
exit()、除零错误等等。 - 被其他线程取消:线程被另一个线程通过 pthread_cancel() 函数取消。
- 进程终止:如果主线程终止,那么整个进程都会被强制终止。
需要注意的是,在一个线程被终止后,它占用的资源可能需要被释放,比如申请的内存空间、打开的文件等,否则可能会造成资源泄露。因此在线程终止的时候需要及时清理资源。
这里我们着重讲 pthread_exit() 与 pthread_cancel() 两个函数,但是在讲之前,我们先来看看一段代码:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <string>
#include <cstdio>
using namespace std;

struct ThreadData
{
    pthread_t _tid;
    char _namebuffer[64];
};

void* thread_routine(void* arg)
{
    ThreadData* td = static_cast<ThreadData*>(arg);
    int cnt = 10;
    while(cnt)
    {
        cout << "新线程, name: " << td->_namebuffer << " cnt: " << cnt-- << " &cnt:" << &cnt << endl;
        sleep(1);
        exit(0); // 使用exit提前退出
    }
}
int main()
{
    for(int i = 0; i < 10; ++i)
    {
        ThreadData* td = new ThreadData();
        snprintf(td->_namebuffer, sizeof td->_namebuffer, "%s, %d", "thread", i+1);
        pthread_create(&td->_tid, nullptr, thread_routine, td->_namebuffer);
    }

    while(true)
    {
        cout << " 主线程running" << endl;
        sleep(1);
    }
    return 0;
}
这段代码我们在上面写过,唯一不同的是,这里使用的是 exit() 函数来直接退出程序,可以看到一般我们都是不能用 exit() 来终止线程,因为 exit() 发出的信号是给整个进程的,而不是当个线程,进程收到信号之后,通过对应的退出码直接杀掉整个进程,这和我们想终止其中某个线程的理念是不符的,所以我们是不能用 exit() 来终止线程!
① pthread_exit() 函数
#include <pthread.h>
void pthread_exit(void *retval);

// 功能:终止当前调用该函数的线程
// 参数:retval是一个类似退出码,这里我们默认设成nullptr即可,要注意retval不能指向一个局部变量 其实 pthread_exit() 和 return 的作用是几乎一样的,都能达到退出当前线程的作用!但是一般来说,为了统一接口,我们使用的都是 pthread_exit()!
除此之外,这里的返回值很奇怪哦,retval 其实是一个类似我们以前 return 的时候设置的一个退出码,这个和我们要讲的线程等待有一定的关系,所以我们放到下面的线程等待去讲,这里默认设置为 nullptr 即可!
💥💥需要注意,pthread_exit() 或者 return 返回的指针所指向的内存单元必须是 全局 的或者是用 malloc 分配的,不能在线程函数的栈上分配,因为当其它线程得到这个返回指针时线程函数已经退出了。
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <string>
#include <cstdio>
using namespace std;

struct ThreadData
{
    pthread_t _tid;
    char _namebuffer[64];
};
void* thread_routine(void* arg)
{
    ThreadData* td = static_cast<ThreadData*>(arg);
    int cnt = 5;
    while(cnt)
    {
        cout << "新线程, name: " << td->_namebuffer << " cnt: " << cnt-- << " &cnt:" << &cnt << endl;
        sleep(1);
        pthread_exit(nullptr); // 终止线程
        // return nullptr; // 也可以return,是等价的
    }
    // 一般我们都是在最后才终止线程的,上面直接终止是为了演示一下线程退出是否影响整个进程
    // pthread_exit(nullptr);
}
int main()
{
    for(int i = 0; i < 10; ++i)
    {
        ThreadData* td = new ThreadData();
        snprintf(td->_namebuffer, sizeof td->_namebuffer, "%s, %d", "thread", i+1);
        pthread_create(&td->_tid, nullptr, thread_routine, td->_namebuffer);
    }

    while(true)
    {
        cout << " 主线程running" << endl;
        sleep(1);
    }
    return 0;
}
② pthread_cancel() 函数
#include <pthread.h>
int pthread_cancel(pthread_t thread);

// 功能:向指定线程发送终止请求
// 返回值:成功的话返回0,失败的话返回非0的错误数字
// 参数:thread为要被终止的线程ID 如果我们想让线程终止自身的话,可以搭配 pthread_self() 函数,获取当前线程的 ID,然后通过 pthread_cancel(pthread_exit()) 进行终止请求。但是一般我们都不这么干,因为我们可以直接用 pthread_exit() 呀,不用这么麻烦!
另外,如果我们让主线程 pthread_cancel(pthread_self()) 的话,那么结果和在主线程中直接调用 pthread_exit() 的结果是一样的,就是终止了整个进程,所以此时其它执行流也会被一块终止!
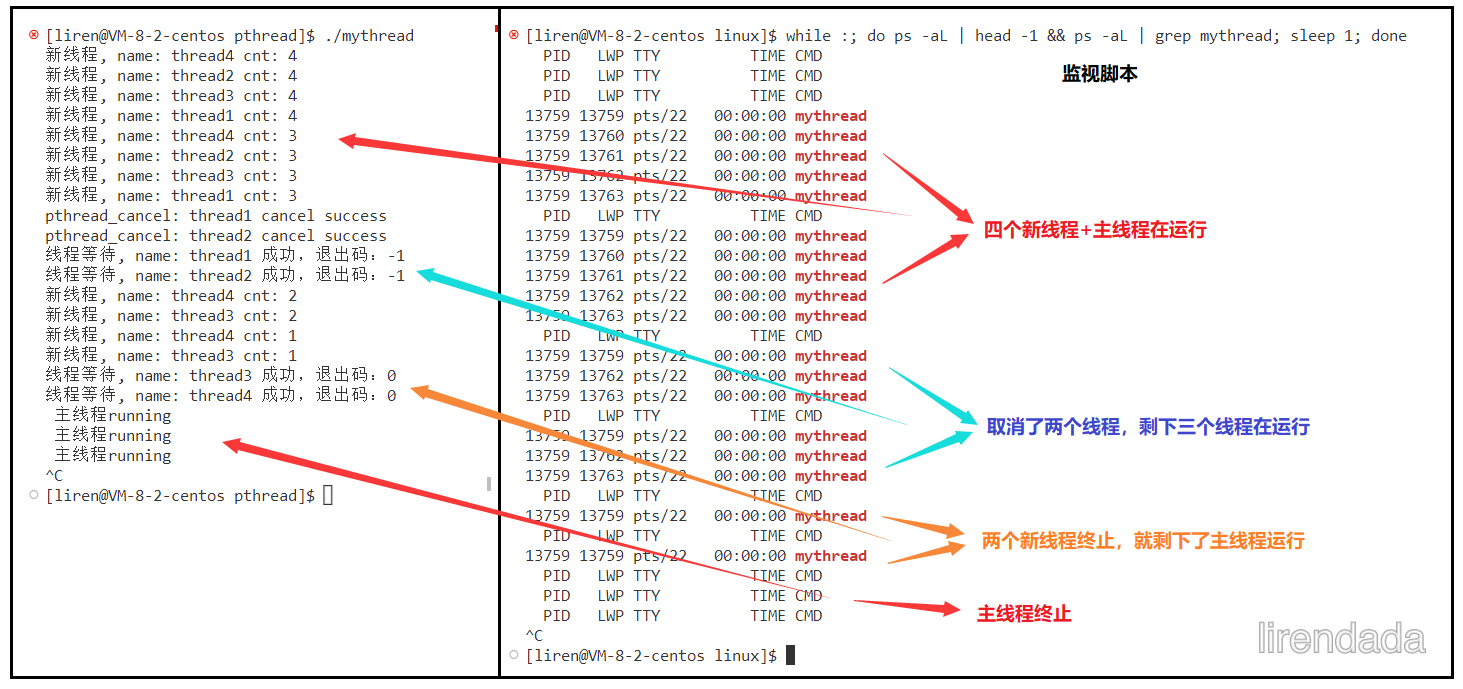
一般来说,这个函数都是被主线程利用起来,去取消一些不需要的线程的!并且通过调用 pthread_cancel() 取消线程之后,线程返回的退出码是 -1,对应的宏是 PTHREAD_CANCELED。
💥注意:线程要被取消,前提是这个线程已经跑起来了!
下面写一段代码,通过主线程来取消新线程,看看结果怎么样。下面的代码还是基于上面那些代码的框架改的,大体不变,主要看注释部分!
另外,下面还引入了线程等待的代码,所以可以先翻阅下面的线程等待的知识点阅读之后再来看该代码也行,也可以不理它,现在认为它是打印退出码的即可!
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <vector>
#include <string>
#include <cassert>
#include <cstdio>
using namespace std;

struct ThreadData
{
    pthread_t _tid;
    char _namebuffer[64];
};

void* thread_routine(void* arg)
{
    ThreadData* td = static_cast<ThreadData*>(arg);
    int cnt = 4;
    while(cnt)
    {
        cout << "新线程, name: " << td->_namebuffer << " cnt: " << cnt-- << endl;
        sleep(1);
    }
    pthread_exit(nullptr);
}
int main()
{
    vector<ThreadData*> threads;
    for(int i = 0; i < 4; ++i) // 创建4个线程
    {
        ThreadData* td = new ThreadData();
        snprintf(td->_namebuffer, sizeof(td->_namebuffer), "%s%d", "thread", i+1);
        pthread_create(&td->_tid, nullptr, thread_routine, td);
        threads.push_back(td); // 记得尾插
    }

    sleep(2); // 先休眠5秒再取消线程

    for(int i = 0; i < 2; ++i) // 取消一半的线程
    {
        pthread_cancel(threads[i]->_tid);
        cout << "pthread_cancel: " << threads[i]->_namebuffer << " cancel success" << endl;
    }

    // 这里涉及到线程等待的知识,可以先翻阅下面的笔记阅读,再回来看该段代码
    // 或者可以不看这段代码,它的主要作用就是释放空间和打印退出码,方便我们观察!
    for(auto& e : threads)
    {
        void* ret = nullptr;
        int n = pthread_join(e->_tid, &ret);
        assert(n == 0);
        cout << "线程等待, name: " << e->_namebuffer << " 成功,退出码:" << (long long)ret << endl;
        delete e;
    }

    while(true)
    {
        cout << " 主线程running" << endl;
        sleep(1);
    }
    return 0;
}
四、线程等待pthread_join()
和进程一样,我们需要考虑线程的等待问题,那为什么线程需要等待呢,原因有以下几点:
- 如果我们想获取新线程的退出信息,则需要进行线程等待拿到这个信息。
- 已经退出的线程,其空间没有被释放,仍然在进程的地址空间内,这样子会导致一些资源泄漏,这些资源泄漏可能会导致系统内存不足,进而影响系统的稳定性和性能。
 #include <pthread.h>
int pthread_join(pthread_t thread, void **retval);

// 功能:等待回收一个终止线程
// 返回值:成功返回0,失败返回一个错误的数字
其中参数:
thread:我们要进行等待的用户态线程ID。retval:这是一个二级指针,它指向一个指针,后者指向线程函数的返回值,一般就是我们需要获取的退出信息。
这个参数 retval 居然是一个二级指针,和我们上面所学的 pthread_exit() 的返回值 void* 到底有什么关系呢,下面我们来解释一下。
在解释之前,我们先用 pthread_join() 来实现线程等待,并且获取新线程的退出信息,然后通过代码的结果来解释两者的关系!
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <vector>
#include <string>
#include <cassert>
#include <cstdio>
using namespace std;

struct ThreadData
{
    long long _i;
    pthread_t _tid;
    char _namebuffer[64];
};

void* thread_routine(void* arg)
{
    ThreadData* td = static_cast<ThreadData*>(arg);
    int cnt = 4;
    while(cnt)
    {
        cout << "新线程, name: " << td->_namebuffer << " cnt: " << cnt-- << endl;
        sleep(1);
    }

    pthread_exit((void*)td->_i); // 返回的退出信息设为td->_i,并且转为void*
    // return (void*)td->_i; // 两种用法等价
}
int main()
{
    vector<ThreadData*> threads;
    for(int i = 0; i < 4; ++i)
    {
        ThreadData* td = new ThreadData();
        td->_i = i+1;
        snprintf(td->_namebuffer, sizeof(td->_namebuffer), "%s%d", "thread", i+1);
        pthread_create(&td->_tid, nullptr, thread_routine, td);
        threads.push_back(td); // 记得尾插
    }

    // 线程等待
    for(auto& e : threads)
    {
        void* ret = nullptr; // ret是个指针,用于下面函数传参,作为输出型参数
        int n = pthread_join(e->_tid, &ret);
        assert(n == 0);

        // ret强转为long long,因为这里使用的是64位机器,指针为8字节,不能转为int类型
        cout << "线程等待, name: " << e->_namebuffer << " 成功,退出码:" << (long long)ret << endl;

        // 释放线程空间
        delete e;
    }

    while(true)
    {
        cout << " 主线程running" << endl;
        sleep(1);
    }
    return 0;
}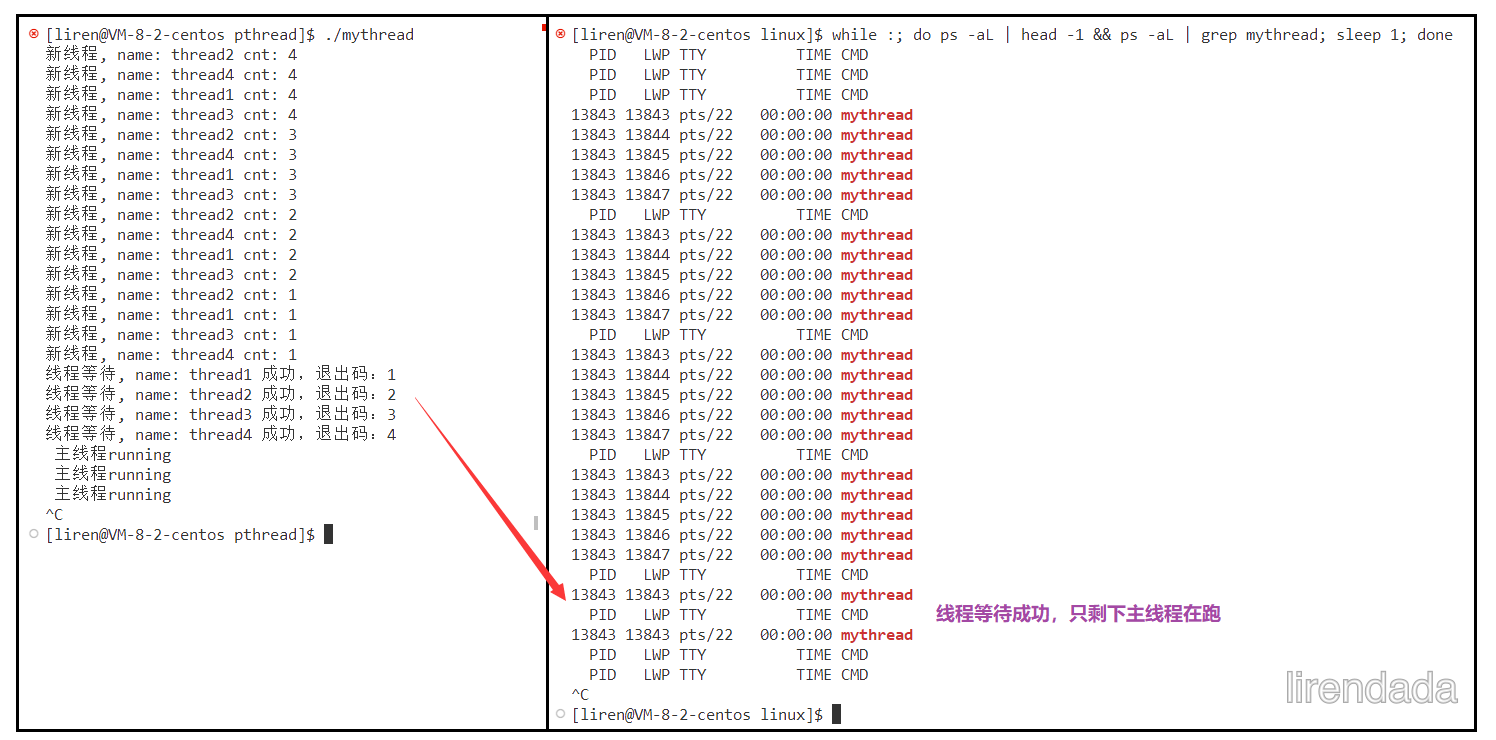
上述代码中,在 ThreadData 结构体中添加了一个 long long 类型的 _i 变量,用于作为每个线程的退出码信息返回。接着在 thread_routine() 函数结束的时候,我们就讲 _i 返回,可以使用 pthread_exit() 也可以使用 return 都行,两者用法是一样的!
接着在主线程中通过定义一个 void* 的变量 ret,通过 pthread_join() 传递 ret,注意此时要对 ret 取地址,因为 pthread_join() 需要的是一个二级指针,也就是说 ret 是一个输出型参数(我们以前传一个变量过去作为输出型参数,也要对其取地址传参,而函数实参为一级指针,这才能达到在函数内部修改该参数值的目的,二级指针也是同理,是为了修改一级指针的值!)。
最后 ret 就拿到了这个退出码,通过将其转化为 long long 类型,可以取出它的退出码信息!(我们使用的是 64 位机器,指针为 8 个字节,所以不能转化为 int,会报错)
如果我们将上述 thread_routine() 函数中返回值改一下:
return (void*)1314520; 我们来看看结果(只截取了退出码部分结果):
线程等待, name: thread1 成功,退出码:1314520
线程等待, name: thread2 成功,退出码:1314520
线程等待, name: thread3 成功,退出码:1314520
线程等待, name: thread4 成功,退出码:1314520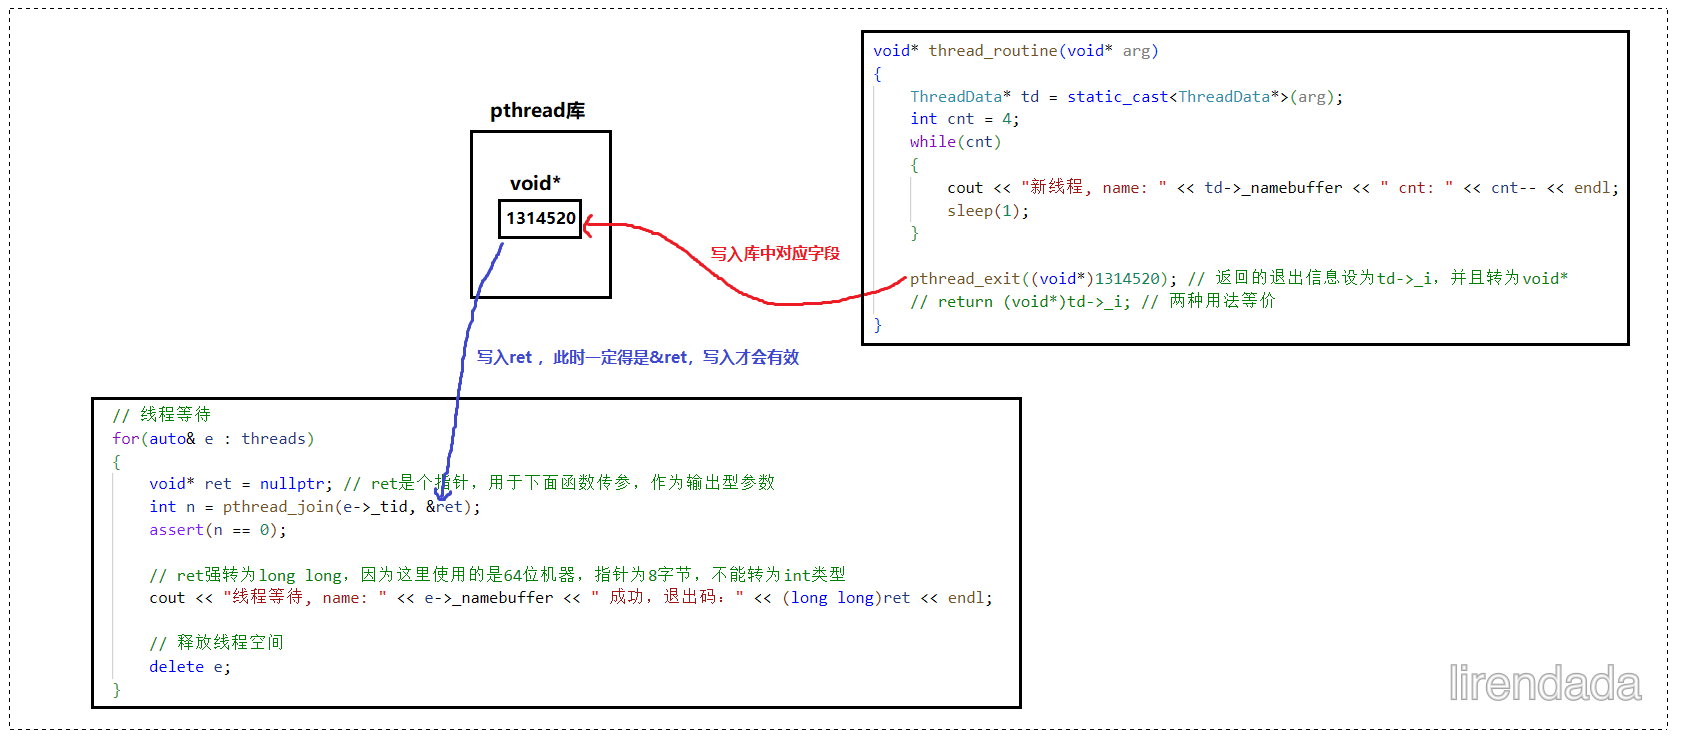
如上图所示,其实 pthread_join() 的参数和 thread_routine() 的返回值其实都是与 pthread 库中某个字段相关的,这个字段是一个 void* 类型,所以我们通过 thread_routine() 函数填入到库中这个字段,只要是 void* 即可,而当我们 ret 是个输出型参数,要去取这个字段的值,则需要加一个指针,就变成了二级指针了,就是这样子的,比较绕,考验指针的功底!😊
💥调用该函数的线程将挂起等待,直到 id 为 thread 的线程终止。thread 线程以不同的方法终止,通过 pthread_join 得到的终止状态是不同的,总结如下:
- 如果
thread线程通过return返回,retval所指向的单元里存放的是thread线程函数的返回值。 - 如果
thread线程被别的线程调用pthread_cancel异常终掉,retval所指向的单元里存放的是常数PTHREAD_CANCELED(-1)。 - 如果
thread线程是自己调用pthread_exit终止的,retval所指向的单元存放的是传给pthread_exit的参数。 - 如果对
thread线程的终止状态不感兴趣,可以传空指针给retval参数。
Ⅲ. 线程分离detach()
#include <pthread.h>
int pthread_detach(pthread_t thread);

// 功能:分离一个线程
// 返回值:成功返回0,失败返回一个错误数字
// 参数:要分离的用户态线程ID,可以是本身,通过pthread_self()获取当前线程ID 默认情况下,新创建的线程是 joinable 的,线程退出后,需要对其进行 pthread_join 操作,否则无法释放资源,从而造成系统泄漏。
而当我们不关心线程的返回值的话,join 则变成了一种负担,因为主线程只能阻塞不能干其它事情。这个时候,我们可以告诉系统,当线程退出时,自动释放线程资源。也就相当于将这个线程交给系统自动管理,这个过程我们叫做线程分离!
下面我们来写段代码测试一下:
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cassert>
#include <cstring>
using namespace std;

void* thread_routine(void* arg)
{
    pthread_detach(pthread_self()); // 将当前线程从主线程中分离
    string name = static_cast<const char*>(arg);
    int cnt = 4;
    while(cnt)
    {
        cout << "新线程, name: " << name << " cnt: " << cnt-- << endl;
        sleep(1);
    }
    return nullptr;
}

int main()
{
    pthread_t td;
    pthread_create(&td, nullptr, thread_routine, (void*)"new thread");

    // 通过打印看看新线程是否被join了,是的话n是为0的
    int n = pthread_join(td, nullptr);
    cout << "result: " << n << " : " << strerror(n) << endl;

    while(true)
    {
        cout << "主线程running" << endl;
        sleep(1);
    }
    return 0;
}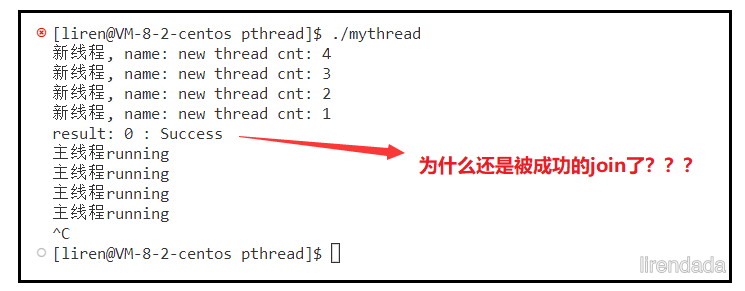
上述代码其实是存在 bug 的,因为我们知道,CPU 调度哪个线程在跑,我们是不能确定的,两个线程的速度快慢我们也无法确定,那么就造成了可能主线程先执行了 pthread_join() 函数之后,新线程才执行 pthread_detach() 进行分离,这就做了无用功啦,主线程还是一直阻塞着知道新线程终止。
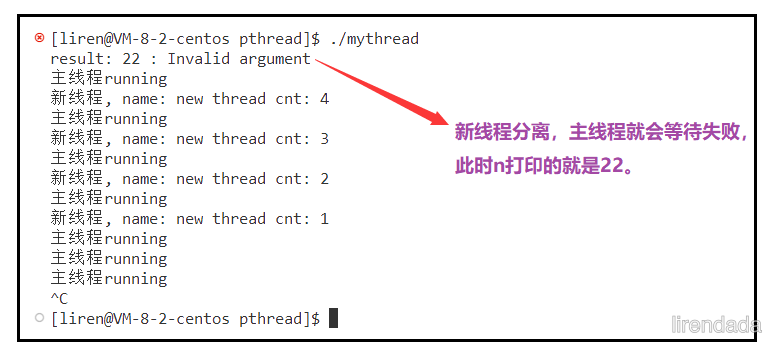
所以分离线程,一般建议都是在主线程产生新线程之后,直接进行分离,而不是等到新线程在其执行函数中去分离。虽然我们也可以通过 sleep() 函数让主线程休眠一会,让新线程保证分离完,但是一般我们不会这么做的,因为 sleep() 的时间其实就是浪费了主线程可执行的时间了!
下面给出正确写法(其实就是将分离线程操作让主线程来执行):
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cassert>
#include <cstring>
using namespace std;

void* thread_routine(void* arg)
{
    string name = static_cast<const char*>(arg);
    int cnt = 4;
    while(cnt)
    {
        cout << "新线程, name: " << name << " cnt: " << cnt-- << endl;
        sleep(1);
    }

    return nullptr;
}

int main()
{
    pthread_t td;
    pthread_create(&td, nullptr, thread_routine, (void*)"new thread");
    pthread_detach(td); // 将当前线程从主线程中分离

    // 通过打印看看新线程是否被join了,是的话n是为0的
    int n = pthread_join(td, nullptr);
    cout << "result: " << n << " : " << strerror(n) << endl;

    while(true)
    {
        cout << "主线程running" << endl;
        sleep(1);
    }
    return 0;
}
Ⅳ. 拓展:__thread关键字
__thread是一个C语言关键字,用于指定一个变量为线程本地存储(Thread-Local Storage, TLS)。__thread 变量的值在每个线程中都是独立的,每个线程可以自由地访问和修改它的 __thread 变量,而不会影响其他线程的变量值。
__thread 变量在多线程编程中非常有用,因为它可以解决共享变量的并发访问问题。通过将变量指定为 __thread 变量,每个线程都会有自己独立的变量副本,从而避免了多个线程同时访问同一个变量的竞争条件问题。
需要注意的是,__thread 变量只能用于静态或全局变量,不能用于自动变量或动态分配的内存。另外,不同的编译器可能会对 __thread 关键字有不同的实现方式和语法要求。
#include <iostream>
#include <unistd.h>
#include <pthread.h>
#include <cassert>
#include <cstring>
using namespace std;

int glo_val = 250; // 定义一个全局变量

void* thread_routine(void* arg)
{
    int cnt = 4;
    while(cnt)
    {
        cout << "新线程running, the glo_val: " << glo_val << " &glo_val: " << &glo_val << endl;
        glo_val++; // 对全局变量进行修改
        sleep(1);
    }
    return nullptr;
}

int main()
{
    pthread_t td;
    pthread_create(&td, nullptr, thread_routine, (void*)"new thread");
    while(true)
    {
        cout << "主线程running, the glo_val: " << glo_val << " &glo_val: " << &glo_val << endl;
        sleep(1);
    }
    return 0;
}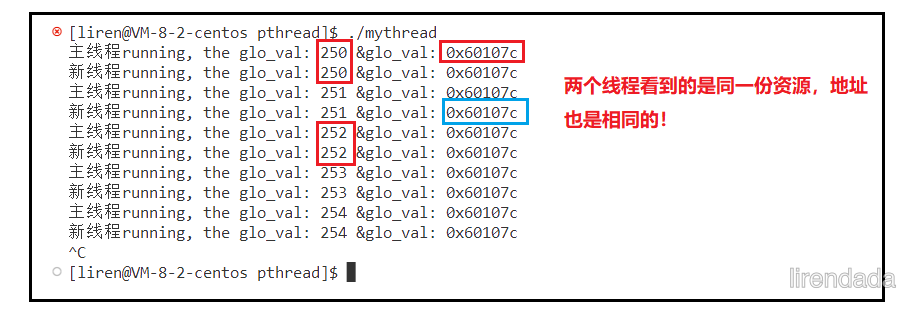
那么我们此时将这个 glo_val 用 __thread 来修饰会发生什么呢,我们来试试看:
__thread int glo_val = 250;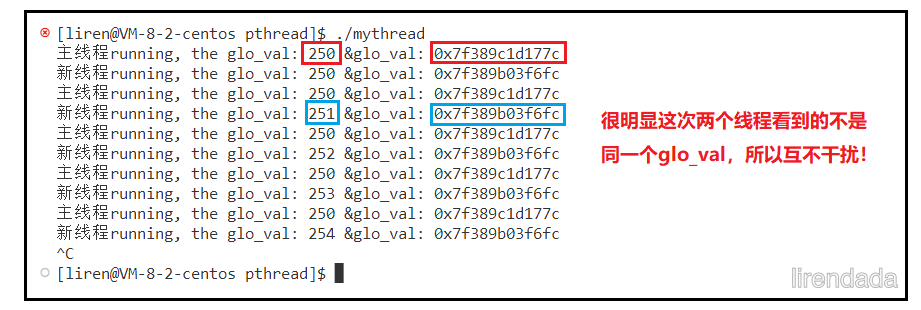
符合预期!
但是可能会有人问了,为什么这两次的 glo_val 的地址差别这么大❓❓❓
其实是因为一开始如果我们没设置 __thread 的话,那么 glo_val 是放在虚拟地址空间中的全局初始化数据段(global initialized data segment),那么地址相对来说是比较低的。
而当我们将其设置为 __thread 的话,那么这个 glo_val 其实是被各自线程库中的线程栈所私有的,也就是我们上面所学过的线程库在地址空间中的发布的那个位于栈区与堆区中间的那块,那块位置相对于全局初始化数据段来说是要高的多的,加上我们是 64 位主机,这个虚拟地址空间其实是给更大的,所以两次地址差别就比较大了,主要原因就是存储位置变了!
Ⅴ. 基于线程操作封装一个线程库
为什么要封装一个线程库呢,因为其实我们上述所说的操作还是比较复杂的,我们要封装起来,便于使用,并且后面我们学网络编程的时候,这个线程库就当作一个小组件来使用!
thread.hpp 如下所示:
// thread.hpp
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <pthread.h>
#include <assert.h>
using namespace std;

class Thread;

// 上下文类,主要是为了解决线程执行函数无法访问Thread类成员变量和方法的问题而设计的。
class Context
{
public:
    Context(Thread* td, void* args)
        :_td(td), _args(args)
    {}
    ~Context()
    {}
public:
    Thread* _td;
    void* _args;
};

class Thread
{
    using func_t = function<void*(void*)>; // c++11包装器,包装线程执行的函数,并重命名为func_t
    const int NUM = 1024;
public:
    Thread(func_t func, void* args = nullptr, int number = 0)
        :_func(func), _args(args)
    {
        // 为_name格式化
        char namebuffer[NUM];
        snprintf(namebuffer, sizeof(namebuffer), "thread-%d", number);
        _name = namebuffer;

        // 意料之外用异常/if,意料之中用assert
        Context* ct = new Context(this, _args);
        int n = pthread_create(&_tid, nullptr, start_routine, ct);
        assert(n == 0);
        (void)n;
    }

    // 因为start_routine是系统接口,不能有this指针,所以必须得是static
    static void* start_routine(void* args)
    {
        // 问题是静态方法无法访问到类内成员变量和方法
        // 所以这里采用创建一个Context类,让Context对象来访问接口的方法
        // 此时args就是Context类的对象
        Context* ct = static_cast<Context*>(args);
        void* ret = ct->_td->run(ct->_args); // 让ct来访问run,此时就不会有因为系统调用不认识this指针的情况!

        delete ct;
        return ret;
    }

    void* run(void* args)
    {
        return _func(args);
    }

    void join()
    {
        int n = pthread_join(_tid, nullptr);
        assert(n == 0);
        (void)n;
    }

    ~Thread()
    {}
private:
    string _name; // 线程名称
    func_t _func; // 线程执行的函数
    void* _args; // 传给线程执行函数的参数
    pthread_t _tid; // 用户态线程ID
}; 测试代码 test.cc 如下所示:
// test.cc
#include "thread.hpp"
#include <memory>
#include <unistd.h>

void* thread_routine(void* args)
{
    string name = static_cast<const char*>(args);
    while(true)
    {
        cout << "i am new thread, name: " << name << endl;
        sleep(1);
    }
}

int main()
{
    unique_ptr<Thread> t1(new Thread(thread_routine, (void*)"hello linux", 1));
    unique_ptr<Thread> t2(new Thread(thread_routine, (void*)"hello c++", 2));
    unique_ptr<Thread> t3(new Thread(thread_routine, (void*)"hello java", 3));

    t1->join();
    t2->join();
    t3->join();
    return 0;
} makefile 文件如下所示:
mythread : test.cc
	g++ -o $@ $^ -std=c++11 -lpthread

.PHONY : clean
clean:
	rm -f mythread