给你一个整数数组 nums ,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。
子数组 是数组中的一个连续部分。
示例 1:
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]
输出:6
解释:连续子数组 [4,-1,2,1] 的和最大,为 6 。
示例 2:
输入:nums = [1]
输出:1
示例 3:
输入:nums = [5,4,-1,7,8]
输出:23
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104
解题思路
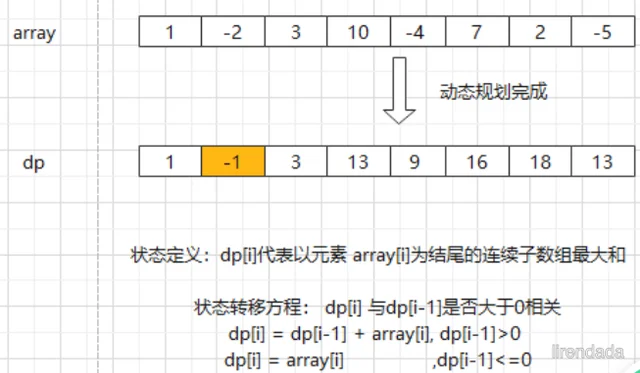
状态表示和状态转移方程解析如下:
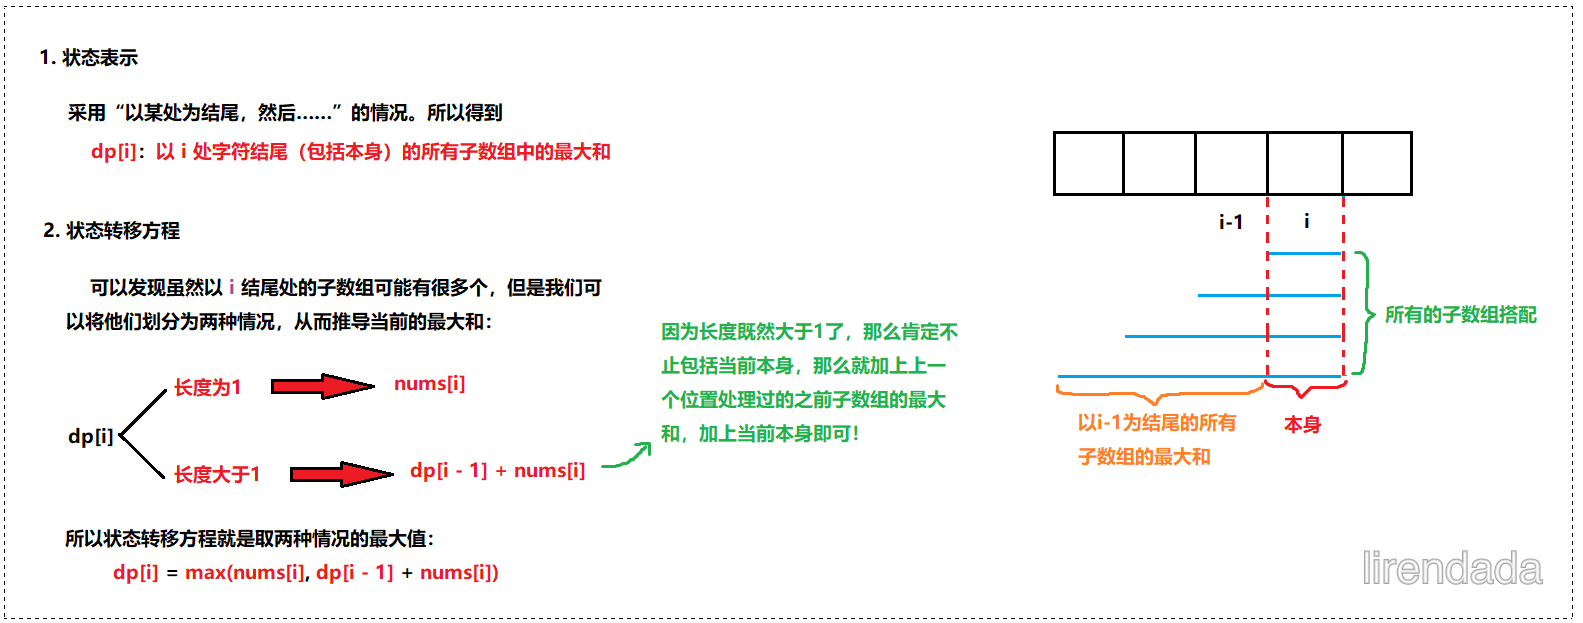
初始化的话,因为状态转移方程涉及到 i-1 位置,所以我们对下标为 0 处的元素初始化,这里就不设置虚拟位置了,都是一样的!
因为 dp[0] 也表明了它只有一个本身的子数组,所以大小就是它本身,也就是 dp[0] = nums[0];
填表顺序的话,从左往右填,这个比较明显。
返回值的话,其实不是 dp[n - 1],因为子数组最大和不一定就是以最后一个元素结尾的子数组,所以在遍历过程中要用一个变量 ret 来记录一下这个最大值,最后返回 ret 即可!
当然,ret 初始化的时候初始化为 nums[0] 比较稳妥,因为如果初始化为 INT_MIN 的话,虽说逻辑上是正确的,但是如果数组只有一个元素,那么最后返回的是 INT_MIN,那就错了!
代码如下:(第二种写法比较省空间,但是要理解!)
// 第一种写法
class Solution {
public:
    int maxSubArray(vector<int>& nums) {
        // 创建dp表
        int n = nums.size();
        vector<int> dp(n);

        // 初始化
        dp[0] = nums[0];
        int ret = dp[0]; // 用于记录遍历过程中的最大值

        // 填表
        for(int i = 1; i < n; ++i)
        {
            dp[i] = max(dp[i - 1] + nums[i], nums[i]);
            ret = max(ret, dp[i]);
        }

        // 返回
        return ret;
    }
};

// 第二种写法:省空间 /////////////////////////////////////////////////////////////////////////
class Solution {
public:
    int maxSubArray(vector<int>& nums) {
        // 用dp变量来表示之前的dp[i-1]
        int dp = nums[0];
        int ret = nums[0];
        for(int i = 1; i < nums.size(); ++i)
        {
            dp = max(dp + nums[i], nums[i]); // 右边的dp还是dp[i-1]的情况,赋值之后就变成了dp[i]的情况
            ret = max(ret, dp);
        }
        return ret;
    }
};
2、环形子数组的最大和(medium)
给定一个长度为 n 的环形整数数组 nums ,返回 nums 的非空 子数组 的最大可能和 。
环形数组 意味着数组的末端将会与开头相连呈环状。形式上, nums[i] 的下一个元素是 nums[(i + 1) % n] , nums[i] 的前一个元素是 nums[(i - 1 + n) % n] 。
子数组 最多只能包含固定缓冲区 nums 中的每个元素一次。形式上,对于子数组 nums[i], nums[i + 1], ..., nums[j] ,不存在 i <= k1, k2 <= j 其中 k1 % n == k2 % n 。
示例 1:
输入:nums = [1,-2,3,-2]
输出:3
解释:从子数组 [3] 得到最大和 3
示例 2:
输入:nums = [5,-3,5]
输出:10
解释:从子数组 [5,5] 得到最大和 5 + 5 = 10
示例 3:
输入:nums = [3,-2,2,-3]
输出:3
解释:从子数组 [3] 和 [3,-2,2] 都可以得到最大和 3
提示:
n == nums.length1 <= n <= 3 * 104-3 * 104 <= nums[i] <= 3 * 104
解题思路 -- 正难则反
状态表示和状态转移方程的解析如下:
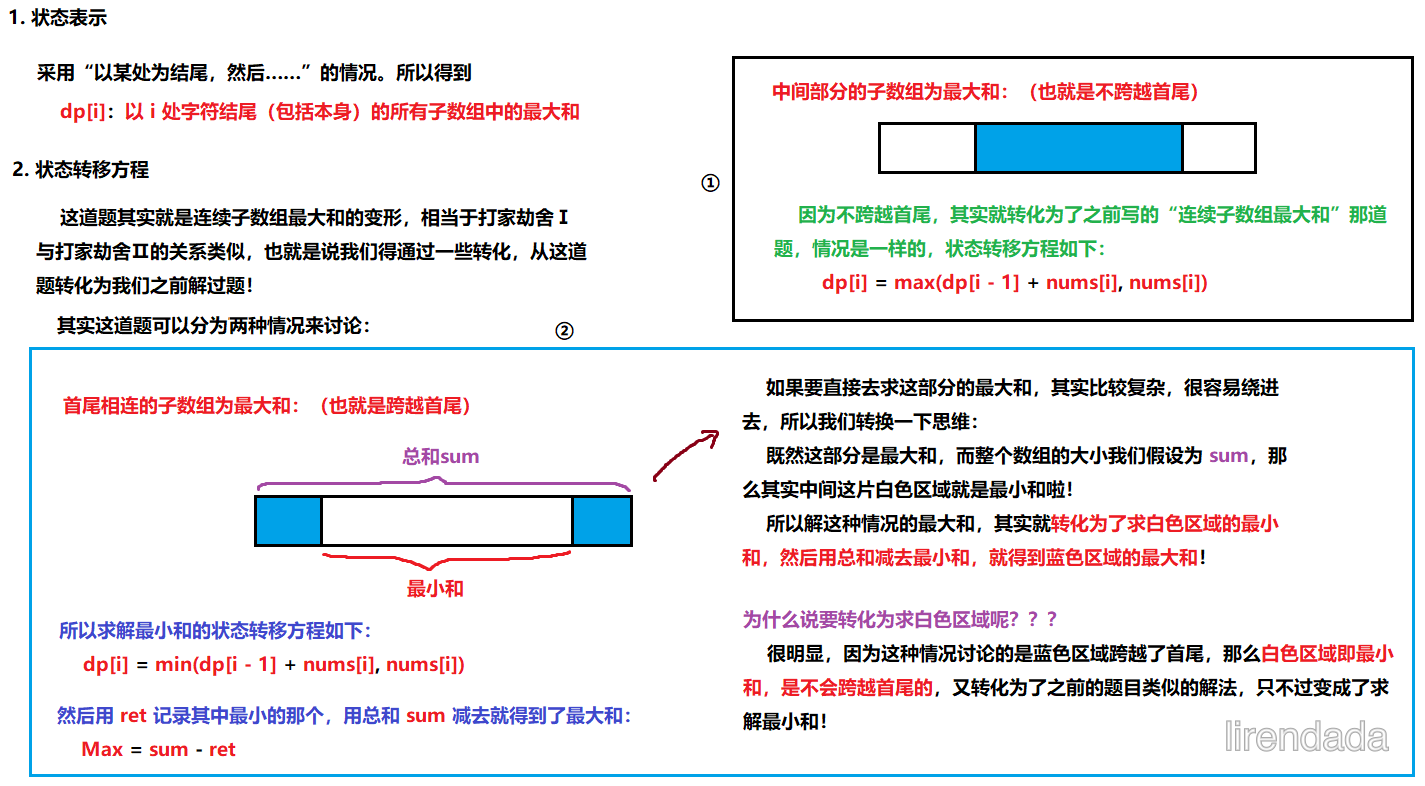
这里对于状态转移方程的推导,其实是和上一道题一模一样的,这里就不再赘述了!
而实际在编程的时候,为了方便,我们用两个数组来代表这两种不同的情况,第一种情况用 maxdp 数组表示,第二种情况用 mindp 数组,表示我们找的是中间的子数组最小和!
在初始化的时候,它们俩都是一样,将下标为 0 处初始化为 nums[0] 即可!
填表顺序就是从左往右,一次填两个表!
返回值则返回它们俩个的最大值,因为两种情况在不同情况都会有不同的可能,具体的参考代码:
class Solution {
public:
    int maxSubarraySumCircular(vector<int>& nums) {
        // 创建两个dp表
        int n = nums.size();
        vector<int> maxdp(n); // 第一种情况,表示子数组的最大和
        vector<int> mindp(n); // 第二种情况,表示子数组的最小和

        // 初始化
        maxdp[0] = mindp[0] = nums[0];
        int maxret = nums[0]; // 存放当前maxdp中的最大和
        int minret = nums[0]; // 存放当前mindp中的最小和
        int sum = nums[0];    // nums数组的总大小

        // 填表
        for(int i = 1; i < n; ++i)
        {
            // 中间部分为最大和的情况
            maxdp[i] = max(maxdp[i - 1] + nums[i], nums[i]);
            maxret = max(maxret, maxdp[i]);

            // 首尾部分相连为最大和的情况
            mindp[i] = min(mindp[i - 1] + nums[i], nums[i]);
            minret = min(minret, mindp[i]);

            // 算出数组总和
            sum += nums[i];
        }

        // 如果最小和minret与sum是相等的,说明最大和是数组中的那个最大数字,记录在maxret中,返回即可
        // 若不相等,说明两种情况都有可能有最大和,返回其中最大的那个即可
        return sum == minret ? maxret : max(maxret, sum - minret);
    }
};


// 第二种写法:省空间,用变量来表示dp当前的状态 /////////////////////////////////////////////////////////////////////
class Solution {
public:
    int maxSubarraySumCircular(vector<int>& nums) {
        // 创建两个dp变量而不是dp表
        int n = nums.size();
        int maxdp = nums[0];
        int mindp = nums[0];

        // 初始化
        int maxret = nums[0];
        int minret = nums[0];
        int sum = nums[0];

        // 填表
        for(int i = 1; i < n; ++i)
        {
            // 用dp变量来表示之前的dp[i-1]
            maxdp = max(maxdp + nums[i], nums[i]); // 右边的dp还是dp[i-1]的情况,赋值之后就变成了dp[i]的情况
            maxret = max(maxret, maxdp);

            mindp = min(mindp + nums[i], nums[i]);
            minret = min(minret, mindp);

            sum += nums[i];
        }

        // 返回
        return sum == minret ? maxret : max(maxret, sum - minret);
    }
};
3、乘积最大子数组(medium)
给你一个整数数组 nums ,请你找出数组中乘积最大的非空连续子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
测试用例的答案是一个 32-位 整数。子数组 是数组的连续子序列。
示例 1:
输入: nums = [2,3,-2,4]
输出: 6
解释: 子数组 [2,3] 有最大乘积 6。
示例 2:
输入: nums = [-2,0,-1]
输出: 0
解释: 结果不能为 2, 因为 [-2,-1] 不是子数组。
提示:
1 <= nums.length <= 2 * 104-10 <= nums[i] <= 10nums的任何前缀或后缀的乘积都 保证 是一个 32-位 整数
解题思路
这道题其实也不简单,因为涉及到乘法运算中,会有不同的情况,比如负负得正啊什么的,很容易想得复杂绕进去!
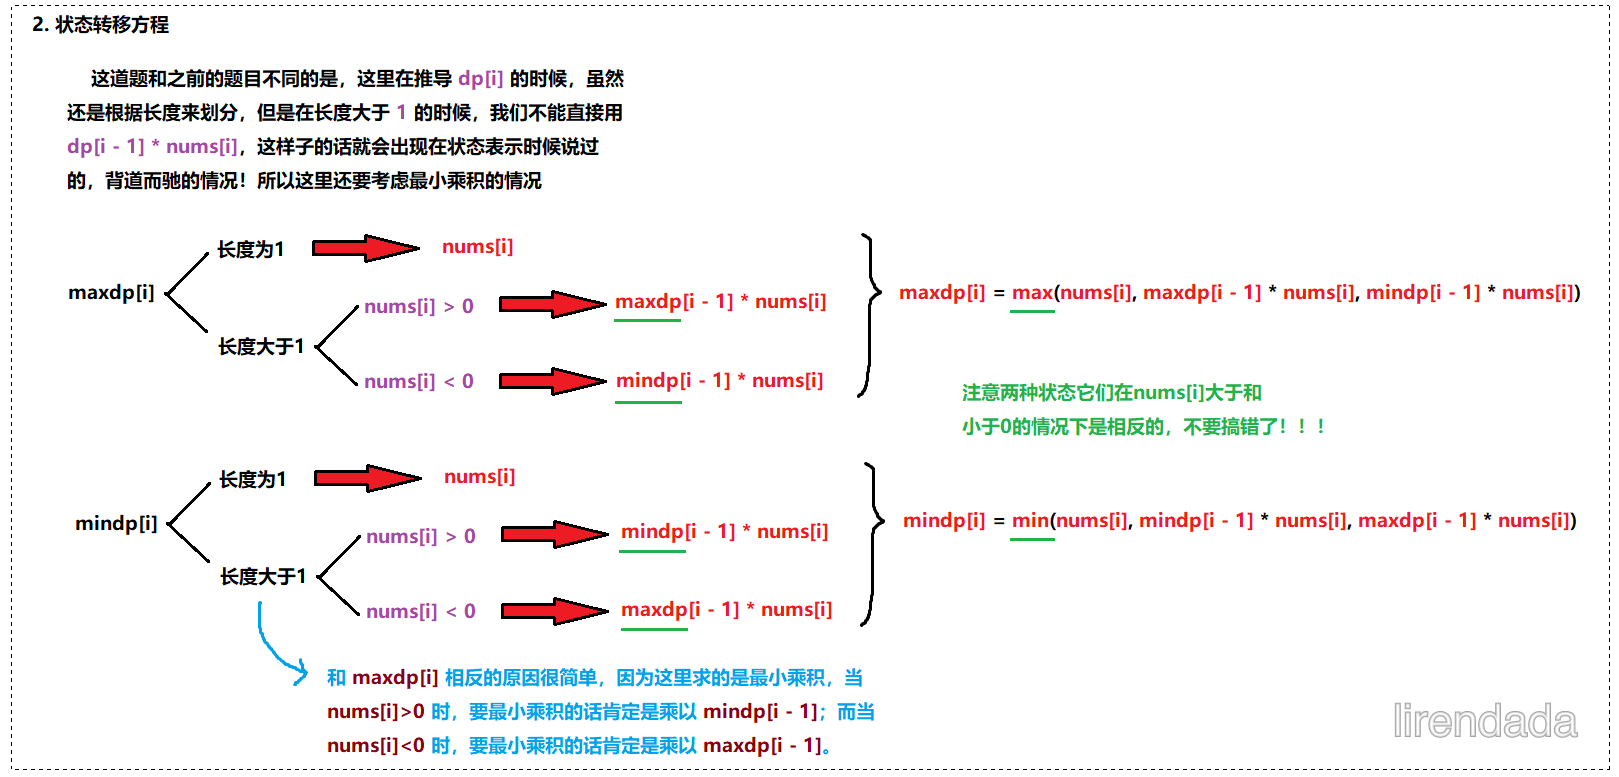
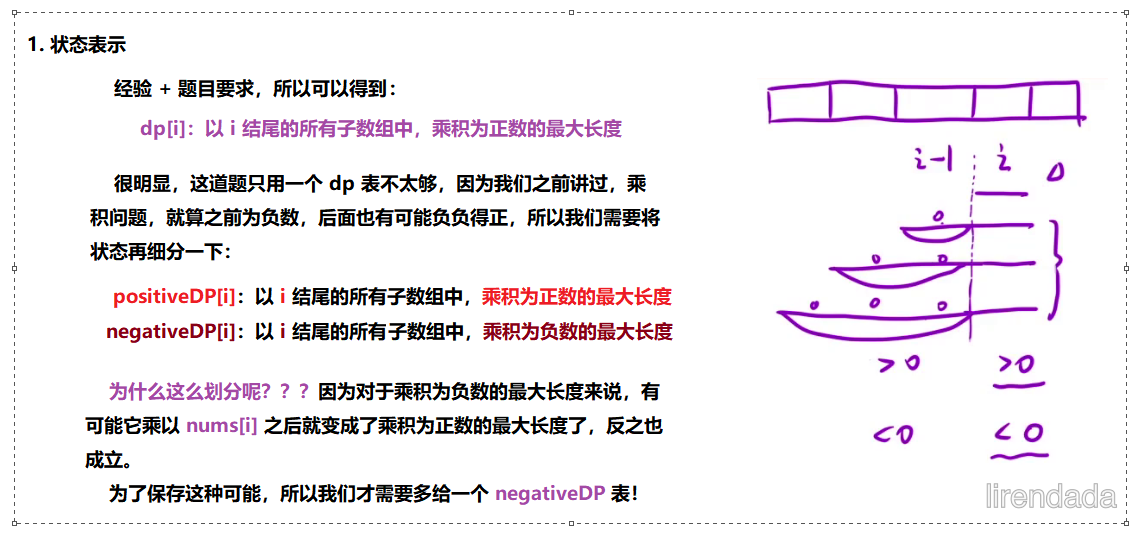
但其实大部分动态规划题在状态表示的时候,如果发现一个 dp 表不够来表示完整的可能状态,那么就需要多个 dp 表来一起表示,比如这道题如果不用两个 dp 表的话,那么解题会变得更复杂一些!
具体的状态表示解析如下图所示:
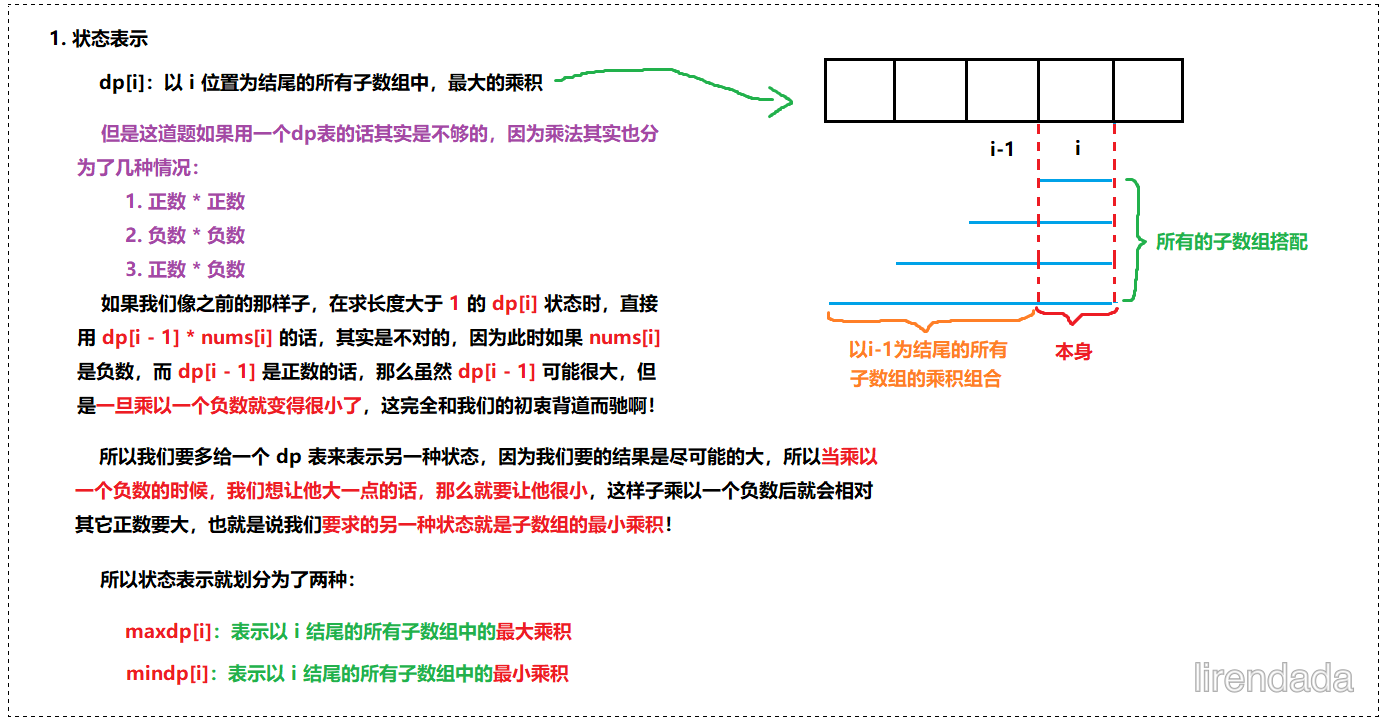
对于状态转移方程的解析如下图所示:
初始化的话,涉及到 i-1 位置处,所以我们要初始化下标为 0 位置处,但是其实这道题使用虚拟位置来初始化的话,会更加容易!和之前一样,虚拟位置放在最开始,也就是 dp[0],现在要考虑的就是两个问题:
- 虚拟位置的初始化必须保证后面填表的正确
- 假设 maxdp[1] 在推导的时候,需要用到 maxdp[0],那么其实 maxdp[1] 也是不开虚拟位置前的第一个位置,表示只有当前数值本身,那么就是它本身,但是状态转移方程中又涉及到乘法,为了正确性,我们让虚拟位置初始化为 1,这样子 nums[1] 去乘以 1 的时候,还是得到 nums[1],也就是得到它本身,所以 maxdp[0] = mindp[0] = 1。
- 下标映射关系
- 主要注意一下题目给出的 nums 数组,因为我们的 maxdp 和 mindp 都往后移动了一位,所以遍历 nums 的时候,需要给它的下标都减一。
对于填表顺序很明显就是从左往右,一次填两个表。
返回值的话,就是返回两个表中的最大值,注意不一定是最后一个元素是最大值,所以我们要用变量记录下途中遇到的最大值!
有人可能会问,那要是 nums[i] == 0 这种情况怎么办,是不是没考虑到❓❓❓
其实对这道题来说,nums[i] 等于 0 的话,并不影响,影响这道题的关键在于乘以负数之后可能数值变小了,而如果是 0 的话,也是可以直接和其它数值取最大值比较的,并不影响!
class Solution {
public:
    int getMax(int a, int b, int c)
    {
        a = max(a, b);
        return max(a, c);
    }
    int getMin(int a, int b, int c)
    {
        a = min(a, b);
        return min(a, c);
    }
    int maxProduct(vector<int>& nums) {
        // 创建两个dp表,第一个位置作为虚拟位置,所以多开一个空间
        int n = nums.size();
        vector<int> maxdp(n + 1); // 表示以i结尾处的所有子数组的最大乘积
        vector<int> mindp(n + 1); // 表示以i结尾处的所有子数组的最小乘积

        // 初始化虚拟位置
        maxdp[0] = mindp[0] = 1;

        // 填表,从左往右,一次填两个表
        int maxret = INT_MIN;
        int minret = INT_MAX;
        for(int i = 1; i < n+1; ++i)
        {
            maxdp[i] = getMax(nums[i - 1], maxdp[i - 1] * nums[i - 1], mindp[i - 1] * nums[i - 1]);
            maxret = max(maxdp[i], maxret);

            mindp[i] = getMin(nums[i - 1], mindp[i - 1] * nums[i - 1], maxdp[i - 1] * nums[i - 1]);
            minret = min(mindp[i], minret);
        }

        // 返回
        return max(maxret, minret);
    }
};
4、乘积为正数的最长子数组(medium)
给你一个整数数组 nums ,请你求出乘积为正数的最长子数组的长度。一个数组的子数组是由原数组中零个或者更多个连续数字组成的数组。
请你返回乘积为正数的最长子数组长度。
示例 1:
输入:nums = [1,-2,-3,4]
输出:4
解释:数组本身乘积就是正数,值为 24 。
示例 2:
输入:nums = [0,1,-2,-3,-4]
输出:3
解释:最长乘积为正数的子数组为 [1,-2,-3] ,乘积为 6 。
注意,我们不能把 0 也包括到子数组中,因为这样乘积为 0 ,不是正数。
示例 3:
输入:nums = [-1,-2,-3,0,1]
输出:2
解释:乘积为正数的最长子数组是 [-1,-2] 或者 [-2,-3] 。
提示:
1 <= nums.length <= 10^5-10^9 <= nums[i] <= 10^9
解题思路
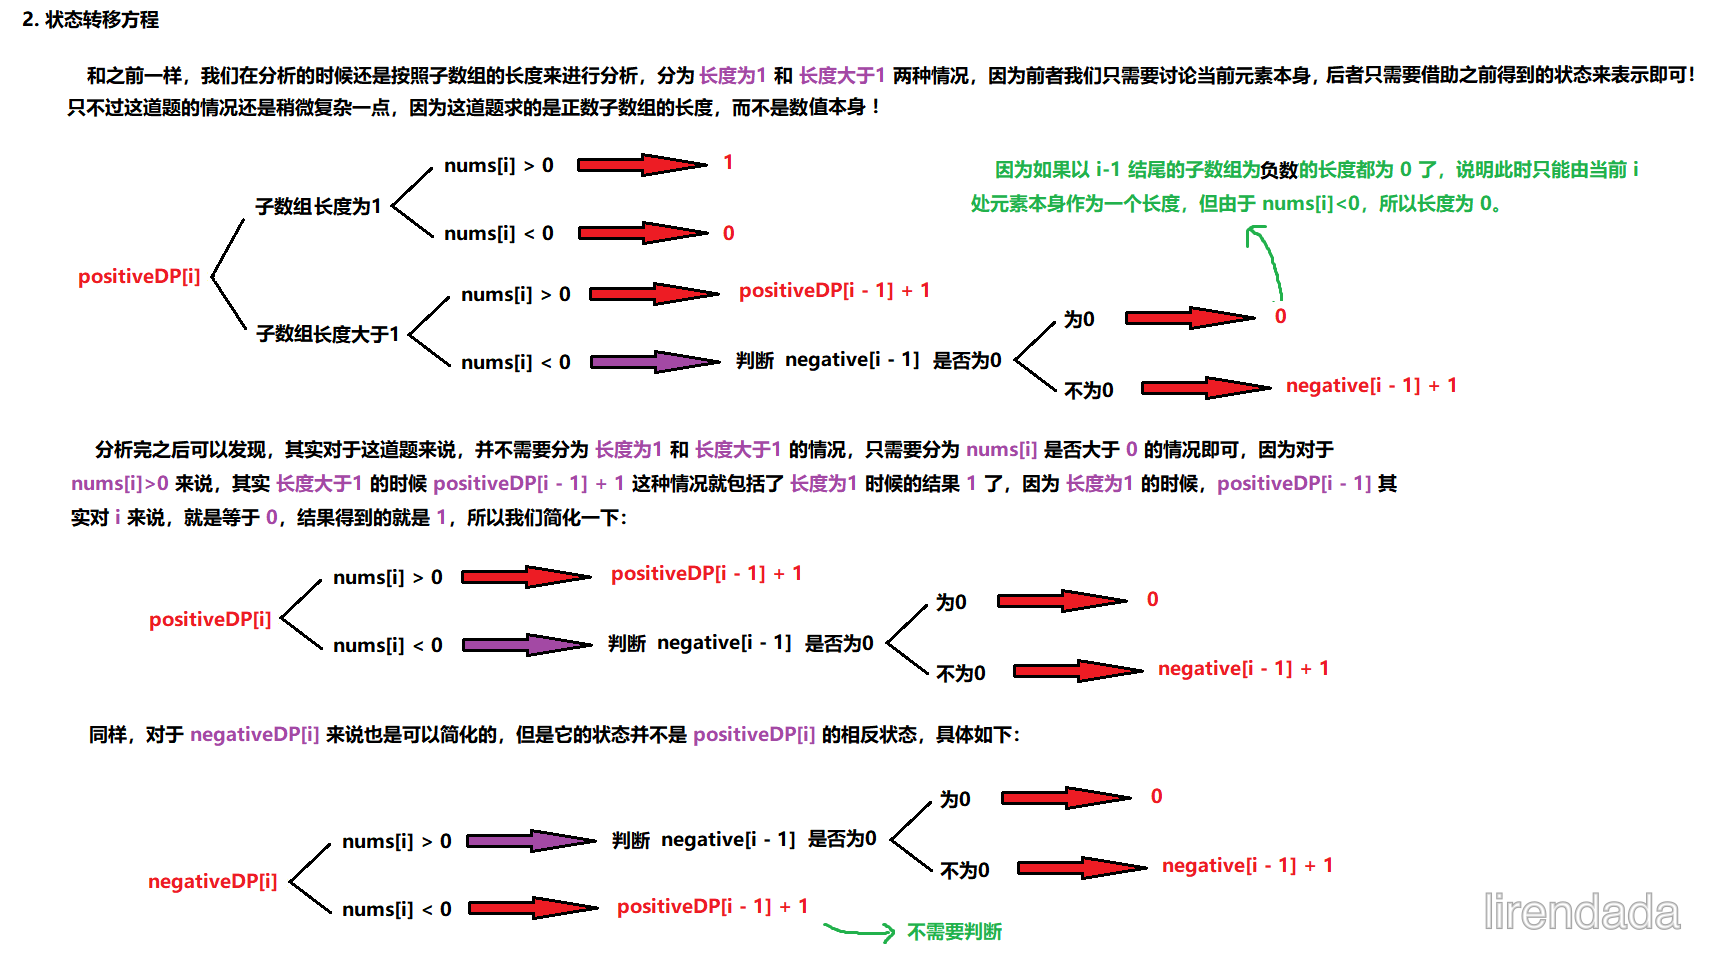
这道题和上一道题一样,一个 dp 表来表示状态不太够,并且这道题要求的是最长的子数组长度而不是乘积本身,具体的状态表示和状态转移方程如下所示:
对于初始化,我们这里对俩个表都开辟虚拟位置,就要注意两个问题:
- 下标的映射关系
- 只需要在访问原数组也就是 nums 的时候将下标减一即可。
- 虚拟位置的初始化要保证后面填表的正确
- 在本题中,让 f[0] = g[0] = 0 即可,因为这道题要求的是步数,其中 f[1] 推导的时候,如果 f[0] 和 g[0] 是 0 的话,那么就能加一后得到 1,也就是本身那一步,就是正确的!
返回值的话,这道题和之前不太一样的是,这道题我们划分为了 nums[i] 大于或者小于 0 的情况,而我们只需要判断每次取到的 positiveDP[i] 是否为最大值,记录它的途中最大值最后返回即可,至于 negativeDP[i] 只是为了保存那些可能负负得正的子数组的情况,如果变成正数且变大了,最后都会算入到正数的!
class Solution {
public:
    int getMaxLen(vector<int>& nums) {
        int n = nums.size();
        vector<int> positiveDP(n + 1);
        vector<int> negativeDP(n + 1);

        int ret = INT_MIN;
        for(int i = 1; i < n+1; ++i)
        {
            if(nums[i - 1] > 0)
            {
                positiveDP[i] = positiveDP[i - 1] + 1;
                negativeDP[i] = (negativeDP[i - 1] == 0 ? 0 : negativeDP[i - 1] + 1);
            }
            else if(nums[i - 1] < 0)
            {
                positiveDP[i] = (negativeDP[i - 1] == 0 ? 0 : negativeDP[i - 1] + 1);
                negativeDP[i] = positiveDP[i - 1] + 1;
            }
            ret = max(ret, positiveDP[i]);
        }
        return ret;
    }
};
5、 等差数列划分(medium)
如果一个数列 至少有三个元素 ,并且任意两个相邻元素之差相同,则称该数列为等差数列。
- 例如,
[1,3,5,7,9]、[7,7,7,7]和[3,-1,-5,-9]都是等差数列。
给你一个整数数组 nums ,返回数组 nums 中所有为等差数组的 子数组 个数。
子数组 是数组中的一个连续序列。
示例 1:
输入:nums = [1,2,3,4]
输出:3
解释:nums 中有三个子等差数组:[1, 2, 3]、[2, 3, 4] 和 [1,2,3,4] 自身。
示例 2:
输入:nums = [1]
输出:0
提示:
1 <= nums.length <= 5000-1000 <= nums[i] <= 1000
解题思路
- 状态表示
- 由于我们的研究对象是「⼀段连续的区间」,如果我们状态表示定义成 [0, i] 区间内⼀共有多少等差数列,那么我们在分析 dp[i] 的状态转移时,会无从下手,因为我们不清楚前面那么多的「等差数列都在什么位置」。所以说,我们定义的状态表⽰必须让等差数列「有迹可循」,让状态转移的时候能找到「大部队」。因此,我们可以「固定死等差数列的结尾」,定义下面的状态表示:
dp[i]表示必须「以i位置的元素为结尾」的等差数列有多少种。
- 状态转移方程
- 我们需要了解⼀下等差数列的性质:如果
a b c三个数成等差数列,这时候来了⼀个d,其中b c d也能构成⼀个等差数列,那么a b c d四个数能够成等差序列吗?答案是:显然的。因为他们之间相邻两个元素之间的差值都是⼀样的。有了这个理解,我们就可以转而分析我们的状态转移方程了。 - 对于 dp[i] 位置的元素 nums[i] ,会与前⾯的两个元素有下面两种情况:
nums[i - 2]、nums[i - 1]、nums[i]三个元素不能构成等差数列:那么以nums[i]为结尾的等差数列就不存在,此时dp[i] = 0。nums[i - 2]、nums[i - 1]、nums[i]三个元素可以构成等差数列:那么以nums[i - 1]为结尾的所有等差数列后⾯填上⼀个nums[i]也是⼀个等差数列,此时dp[i] = dp[i - 1]。但是,因为nums[i - 2]、nums[i - 1]、nums[i]三者⼜能构成⼀个新的等差数列,因此要在之前的基础上再添上⼀个等差数列,于是dp[i] = dp[i - 1] + 1。
- 综上所述:状态转移方程为:
- 如果
nums[i - 2] + nums[i] != 2 * nums[i - 1],则dp[i] = 0 - 如果
nums[i - 2] + nums[i] == 2 * nums[i - 1]时,则dp[i] = 1 + dp[i - 1]
- 如果
- 我们需要了解⼀下等差数列的性质:如果
- 初始化
- 由于需要⽤到前两个位置的元素,但是前两个位置的元素⼜⽆法构成等差数列,因此
dp[0] = dp[1] = 0。
- 由于需要⽤到前两个位置的元素,但是前两个位置的元素⼜⽆法构成等差数列,因此
- 填表顺序
- 毫⽆疑问是「从左往右」
- 返回值
- 因为我们要的是所有的等差数列的个数,因此需要返回整个 dp 表⾥⾯的元素之和。
class Solution {
public:
    int numberOfArithmeticSlices(vector<int>& nums) {
        // 创建dp表,dp[i]表示以i结尾的所有等差数组的个数
        int n = nums.size();
        vector<int> dp(n);

        // 填表
        int sum = 0;
        for(int i = 2; i < n; ++i)
        {
            dp[i] = (nums[i] - nums[i-1]) == (nums[i-1] - nums[i-2]) ? dp[i-1] + 1 : 0;
            sum += dp[i];
        }

        // 返回值
        return sum;
    }
};
6、最长湍流子数组(medium)
给定一个整数数组 arr ,返回 arr 的 最大湍流子数组的长度 。
如果比较符号在子数组中的每个相邻元素对之间翻转,则该子数组是 湍流子数组 。
更正式地来说,当 arr 的子数组 A[i], A[i+1], ..., A[j] 满足仅满足下列条件时,我们称其为湍流子数组:
- 若
i <= k < j:- 当
k为奇数时,A[k] > A[k+1],且 - 当
k为偶数时,A[k] < A[k+1];
- 当
- 或若
i <= k < j:- 当
k为偶数时,A[k] > A[k+1],且 - 当
k为奇数时,A[k] < A[k+1]。
- 当
示例 1:
输入:arr = [9,4,2,10,7,8,8,1,9]
输出:5
解释:arr[1] > arr[2] < arr[3] > arr[4] < arr[5]
示例 2:
输入:arr = [4,8,12,16]
输出:2
示例 3:
输入:arr = [100]
输出:1
提示:
1 <= arr.length <= 4 * 1040 <= arr[i] <= 109
解题思路
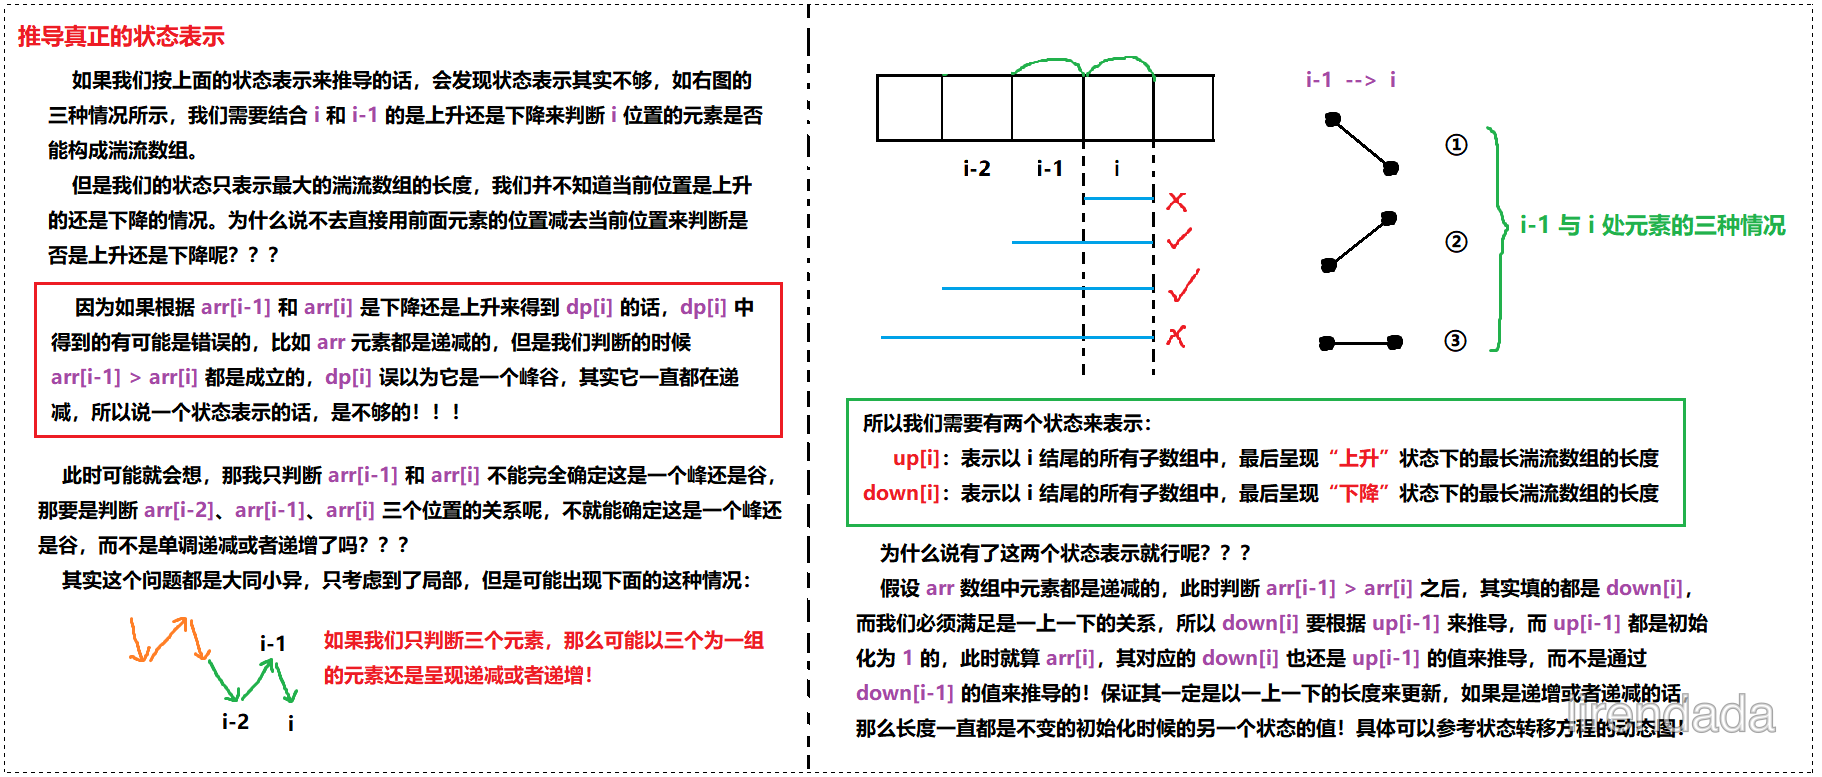
这道题其实难在状态的表示,因为比较难想到需要使用两个状态来表示,但是我们可以通过这道题总结的经验还是那句话:当一个状态表示的时候条件不允许或者推导不成功,那么此时有必要引入另一个状态来分担状态表示!
根据 ”经验+题目要求“,我们一般都会将状态表示为以某处结尾然后……的情况,比如这道题,我们可以将状态表示为:以 i 结尾的所有子数组中,最大的湍流数组的长度。
虽然看似这个状态表示没问题,但是其实单独用它来解决这道题,远远不够!
下面图片中给出了具体的解析:
有了状态表示,状态转移方程就好弄了!对于 i 位置的元素,其实我们只需要判断两种情况,也就是大于和小于的情况,对于等于的情况,我们是不做任何的处理的,因为题目要求的!
- 如果
arr[i - 1] > arr[i]- 说明此时是 ”下降“ 趋势,所以我们要更新一下
down[i],可以明显看出,我们要的是波动的模型,所以要从up数组来更新down数组,因为这一次是下降,那么要求上一次是上升,所以要借助up[i-1],并且因为长度多了当前的位置,所以要加一。 - 所以状态转移方程:
down[i] = up[i - 1] + 1
- 说明此时是 ”下降“ 趋势,所以我们要更新一下
- 如果
arr[i - 1] < arr[i]- 说明此时是 ”上升“ 趋势,和上面一样,只不过是反过来,这次要借助
down[i - 1],并且长度加一。 - 所以状态转移方程:
up[i] = down[i - 1] + 1
- 说明此时是 ”上升“ 趋势,和上面一样,只不过是反过来,这次要借助
对于初始化问题,因为状态转移方程涉及到 i-1,那么我们势必要将 up[0] 和 down[0] 进行初始化,这道题我们就不开虚拟位置了,其实开的话也是可以的,只不过咱们这里就不开了!
因为这道题要求当只有一个元素的时候返回的最长湍流数组长度也是 1,而当元素只有两个时候,只要它们不是相等的,那么返回的就是 2,所以说我们的 up[0] 和 down[0] 都要初始化为 1。
下面的动态图是从题解中摘取的,过程解释的非常形象具体!

最后就是返回值问题,因为不一定是两个数组中的最后一个元素为最大值,有可能是在数组的中间出现最大值,所以在遍历它们的同时用一个变量 ret 记录它们之间的最大值并且判断着去更新这个最大值,最后返回 ret 即可!
class Solution {
public:
    int maxTurbulenceSize(vector<int>& arr) {
        // 创建dp表
        int n = arr.size();
        vector<int> up(n, 1);
        vector<int> down(n, 1);

        // 填表,ret要初始化为1,因为如果是一个元素的话,要求返回的长度是1
        int ret = 1;
        for(int i = 1; i < n; ++i)
        {
            if(arr[i - 1] > arr[i])
            {
                down[i] = up[i - 1] + 1;
            }
            else if(arr[i - 1] < arr[i])
            {
                up[i] = down[i - 1] + 1;
            }
            ret = max(ret, max(up[i], down[i]));
        }
        return ret;
    }
};
7、单词拆分(medium)
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。请你判断是否可以利用字典中出现的单词拼接出 s 。
注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
示例 1:
输入: s = "leetcode", wordDict = ["leet", "code"]
输出: true
解释: 返回 true 因为 "leetcode" 可以由 "leet" 和 "code" 拼接成。
示例 2:
输入: s = "applepenapple", wordDict = ["apple", "pen"]
输出: true
解释: 返回 true 因为 "applepenapple" 可以由 "apple" "pen" "apple" 拼接成。
     注意,你可以重复使用字典中的单词。
示例 3:
输入: s = "catsandog", wordDict = ["cats", "dog", "sand", "and", "cat"]
输出: false
提示:
1 <= s.length <= 3001 <= wordDict.length <= 10001 <= wordDict[i].length <= 20s和wordDict[i]仅有小写英文字母组成wordDict中的所有字符串 互不相同
解题思路
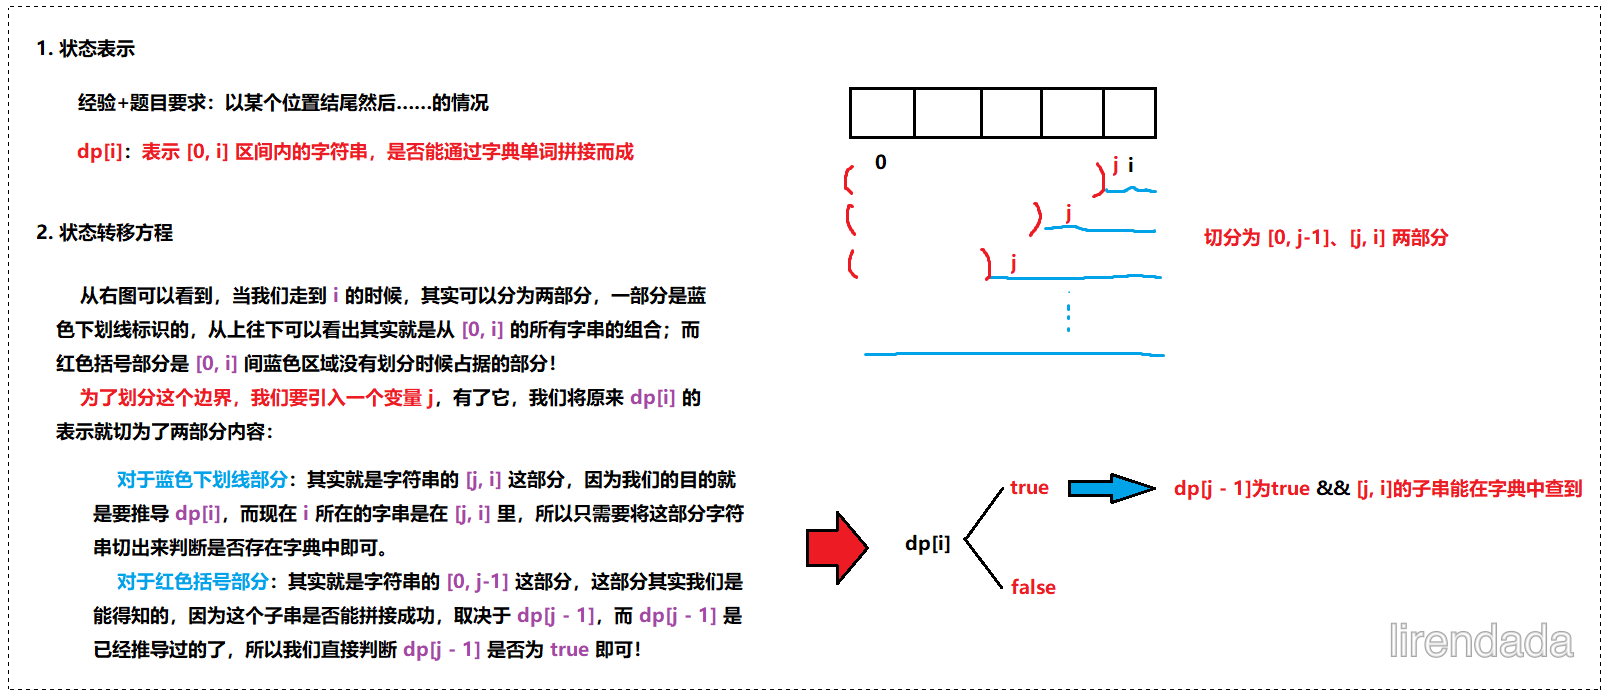
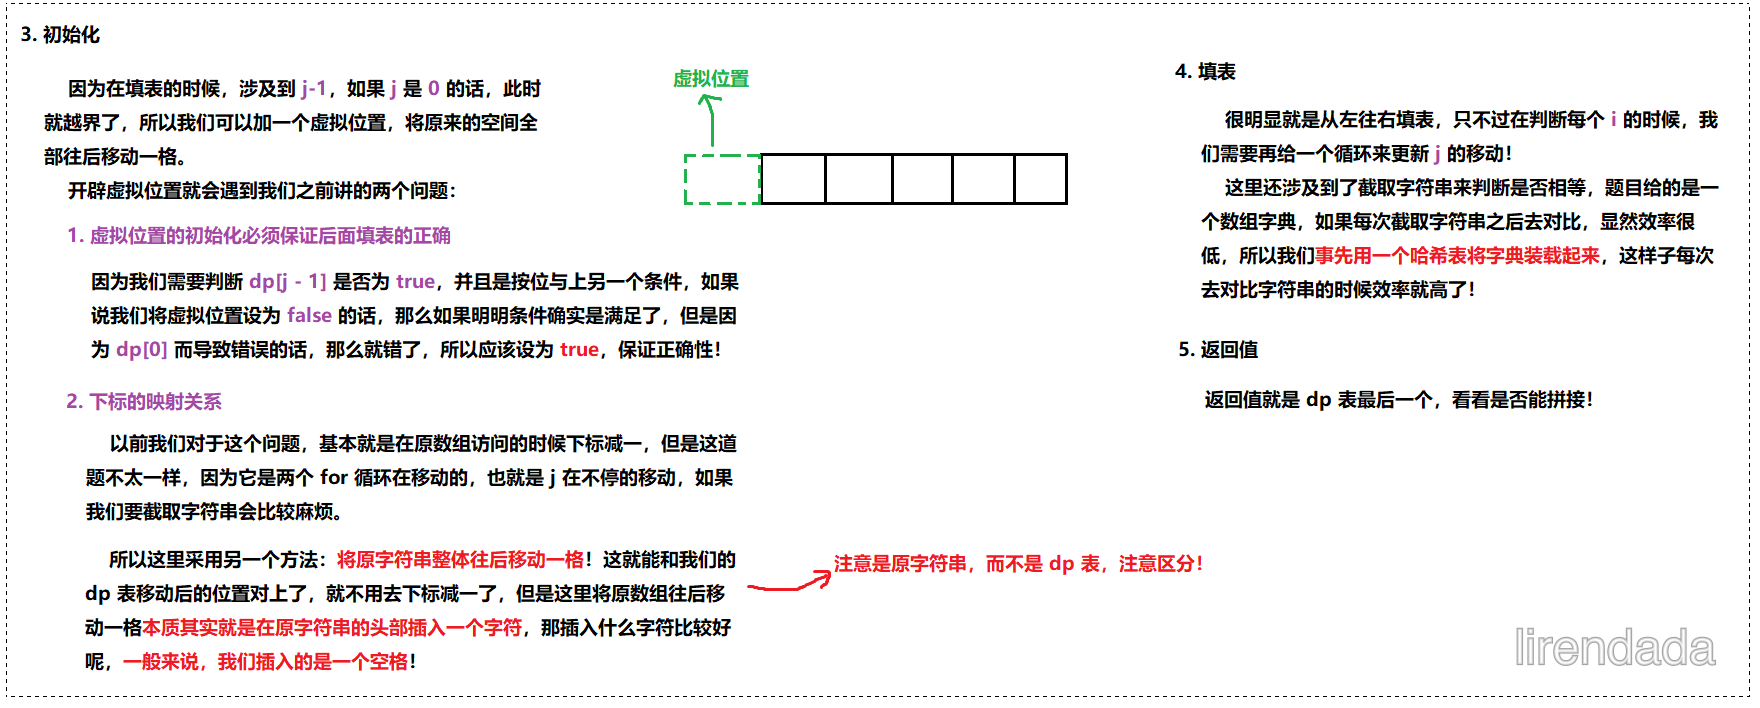
状态表示和状态转移方程的解析如下图所示:
class Solution {
public:
    bool wordBreak(string s, vector<string>& wordDict) {
        // 优化:把字典放到hash中
        unordered_set<string> hash;
        for(const auto &e : wordDict)
            hash.insert(e);

        // 创建dp表,dp[i]表示从[0,i]区间内是否可以拼成一个字符串
        int n = s.size();
        vector<bool> dp(n + 1); // 多开一个虚拟位置,防止越界

        dp[0] = true; // 给虚拟位置初始化,保证后面填表正确
        s = ' ' + s;  // 使原始字符串的下标统⼀+1,让我们无需在后面访问s的时候去控制下标

        // 填表
        for(int i = 1; i <= n; ++i)
        {
            for(int j = i; j >= 1; --j)
            {
                if(dp[j - 1] == true && hash.count(s.substr(j, i - j + 1)))
                {
                    dp[i] = true;
                    break; // 只要找到了就break
                }
            }
        }
        return dp[n];
    }
};
8、环绕字符串中唯⼀的子字符串(medium)
定义字符串 base 为一个 "abcdefghijklmnopqrstuvwxyz" 无限环绕的字符串,所以 base 看起来是这样的:
"...zabcdefghijklmnopqrstuvwxyzabcdefghijklmnopqrstuvwxyzabcd....".
给你一个字符串 s ,请你统计并返回 s 中有多少 不同非空子串 也在 base 中出现。
示例 1:
输入:s = "a"
输出:1
解释:字符串 s 的子字符串 "a" 在 base 中出现。
示例 2:
输入:s = "cac"
输出:2
解释:字符串 s 有两个子字符串 ("a", "c") 在 base 中出现。
示例 3:
输入:s = "zab"
输出:6
解释:字符串 s 有六个子字符串 ("z", "a", "b", "za", "ab", and "zab") 在 base 中出现。
提示:
1 <= s.length <= 105- s 由小写英文字母组成
解题思路
这道题首先要先看懂题,其实就是要求这个字符串 base 的数量,而 base 其实就是 acbd…… 连续的子串,不能是 acd 这种只能是连续的 abcd,一定要先弄懂题目要求,弄懂了才能做!依旧是按照我们分析的几步来:
- 状态表示
- 还是一样,动态规划这类题还是按照 “经验+题目要求”,比如 以某处为结尾然后……的情况,这道题也是如此。
- 所以我们可以设定 dp[i] 表示以 i 结尾的所有子串中,是 base 子串的数量
- 状态转移方程
- 既然是要求以 i 结尾的所有子串的可能,那么我们按长度来解析:
- 子串长度为1:也就是当前字符本身,那么肯定是算一种 base 字符串的,所以此时 dp 值为 1
- 子串长度大于1:这个时候就要根据之前的状态来得到当前的状态了!
- 因为此时子串长度大于 1,那么肯定会有 i-1 位置字符的参与,那么其实就转化为了 dp[i - 1] 的值了,因为它表示以 i-1 字符结尾的所有字符串中 base 字符串的出现次数。
- 如果此时当前字符能和以 i-1 结尾的所有 base 字符串拼接起来,那么得到的出现此时就是 dp[i - 1],那么如何才能将 i 处字符和之前的字符串符合拼接起来呢❓❓❓
- 其实就是题目要求,要连续的 abcd…… 这种形式,所以我们只需要判断是否
s[i] - 1 == s[i - 1]即可,但是要注意的是有可能 s[i] 是 ‘a’,题目说到这是一个环绕 base 字符串,也就是说首尾相连,那么要让它们拼接起来,还得满足s[i] == ‘a’ && s[i - 1] == ‘z’,把这种情况考虑到了才是完整的情况!
- 其实就是题目要求,要连续的 abcd…… 这种形式,所以我们只需要判断是否
- 也就是说,当
s[i] - 1 == s[i - 1]或者s[i] == ‘a’ && s[i - 1] == ‘z’有一个满足的时候,d[i] 才等于 dp[i - 1]
- 所以状态转移方程:dp[i] = 1 + dp[i - 1],其中 dp[i - 1] 是需要满足条件才能加上的,而 1 是必加项。
- 既然是要求以 i 结尾的所有子串的可能,那么我们按长度来解析:
- 初始化
- 因为状态转移方程涉及到 i-1,所以我们要对 dp[0] 进行初始化,如果只有两个字符,比如 “ab”,此时 dp[i - 1] 是成立的,需要加上,那么 dp[i] = 1 + dp[i - 1] 就得等于 2 才对,所以 dp[0] 初始化为 1。
- 但其实还有更妙的做法,因为我们上面不是得到了 dp[i] 的推导中,肯定要加上一吗,那么我们只要将整个 dp 数组初始化为 1,往后在求 dp[i] 的时候我们直接使用 +=,比如 dp[i] += dp[i - 1] 的时候,其中 dp[i] 本身已经初始化为了 1,就不用再去加上 1 了,当然不这么做也是可以的!
- 填表顺序
- 显而易见,填表顺序「从左往右」
- 返回值
- 返回值并不是简单的累加上 dp 表的所有值,因为有可能字符串 s 中有重复的字符!
- 比如说【abczab】此时对于第一个字符 ‘b’ 来说,它有出现过子串 ‘b’、“ab”,所以 dp 值为 2;而对于第二个字符 ‘b’ 来说,它出现过 ‘b’、“ab” 和 “zab”,dp 值就为 3,它其中就包括了第一个字符 ‘b’ 所出现的子串,那么就重复了,此时要是我们去累加整个 dp 表的值,那么就多加了 2,那就错了!
- 可以发现,我们只需要取出现相同字符中,dp 值大的那个,它出现的子串肯定也包括了其它相同字符出现的子串!所以我们去重的方法就是取这些相同字符中 dp 值大的那个!
- 所以我们可以使用哈希表,对于此题直接使用一个 26 空间大小的数组即可,因为只出现小写字母!然后将每个字符映射到对应的位置上去,并且 hash[i] 更新的是这个相同字符的最大 dp 值!
- 最后我们再去这个哈希表中累加出现的这些最大 dp 值,返回最终累加结果即可!
- 返回值并不是简单的累加上 dp 表的所有值,因为有可能字符串 s 中有重复的字符!
class Solution {
public:
    int findSubstringInWraproundString(string s) {
        // 创建dp表,dp[i]表示以i结尾的所有子串中的base的数量
        int n = s.size();
        vector<int> dp(n, 1); // 都初始化为1

        // 填表
        for(int i = 1; i < n; ++i)
        {
            // 注意判断这里是s[i]-1而不是s[i]+1,不要搞错了!
            if((s[i] - 1 == s[i - 1]) || (s[i - 1] == 'z' && s[i] == 'a'))
                dp[i] += dp[i - 1];
        }

        // 返回base出现的总和之前的处理:
        // 注意在字符串s中可能有重复的字符,这样子的话两个相同字符的dp值可能是不一样的
        // 我们只取大的那个,因为dp值大的那个包含了dp值小的那个
        // 所以我们要做映射,将出现的字符的最大dp值映射到hash数组中
        int hash[26] = {0};
        for(int i = 0; i < n; ++i)
            hash[s[i] - 'a'] = max(hash[s[i] - 'a'], dp[i]);

        // 累加结果并且返回
        int ret = 0;
        for(int i = 0; i < 26; ++i)
            ret += hash[i];
        return ret;
    }
};