给你一个二叉树的根节点 root ,判断其是否是一个有效的二叉搜索树。
有效 二叉搜索树定义如下:
- 节点的左子树只包含 小于 当前节点的数。
- 节点的右子树只包含 大于 当前节点的数。
- 所有左子树和右子树自身必须也是二叉搜索树。
示例 1:
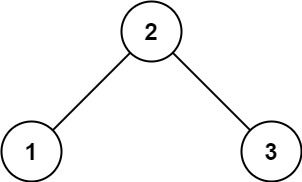
输入:root = [2,1,3]
输出:true
示例 2:
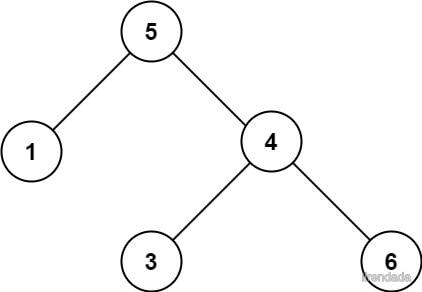
输入:root = [5,1,4,null,null,3,6]
输出:false
解释:根节点的值是 5 ,但是右子节点的值是 4 。
提示:
- 树中节点数目范围在
[1, 104]内 -231 <= Node.val <= 231 - 1
解题思路:深度优先遍历 + 中序遍历 + 剪枝
看到二叉搜索树,就想到一个特性,二叉搜索树的中序遍历是一个有序序列!所以我们可以立马想到用一个数组来存放中序遍历的结果,然后判断一下序列是否有序即可,这样子做的时间复杂度为 O(n)。
其实我们没必要用一个数组去记录所有的结果,我们只需要用一个全局变量 prev 来记录当前节点的前驱节点,然后判断一下当前节点的值和前驱节点值的大小关系即可!(用全局变量的好处就是我们的函数头可以更简洁一些!)
可能会有人问,为什么不直接使用前序遍历遍历当前节点的时候判断一下左右孩子与当前孩子的值的大小关系就好呢❓❓❓
其实这种想法忽略了一个细节,就是下图所示的情况,根节点
20的右子树中,存在一个值为19的节点,但是如果是前序遍历去只比较左右孩子节点值的大小情况的话,就会忽略了左右子树中的其它更深的节点,此时虽然左右子树都是满足二叉搜索树的,但是对于根节点来说是不满足的,所以不能直接使用前序遍历来让当前节点与左右孩子节点进行比较的方式!
然后在中序遍历的时候,当当前节点处理完之后,我们只需要让 prev 赋值为当前节点的值,接着返回到上一层也就是中序遍历的下一个节点的时候,此时 prev 就是上一层的节点值了!
我们只要一一对比每个节点与 prev 前序节点的大小,如果 prev 比当前节点的值要大或者等于的话,直接返回 false 即可,这就相当于一个剪枝操作了,也就是我们就不需要再比对后面的节点了,因为是无意义的!如下图所示:
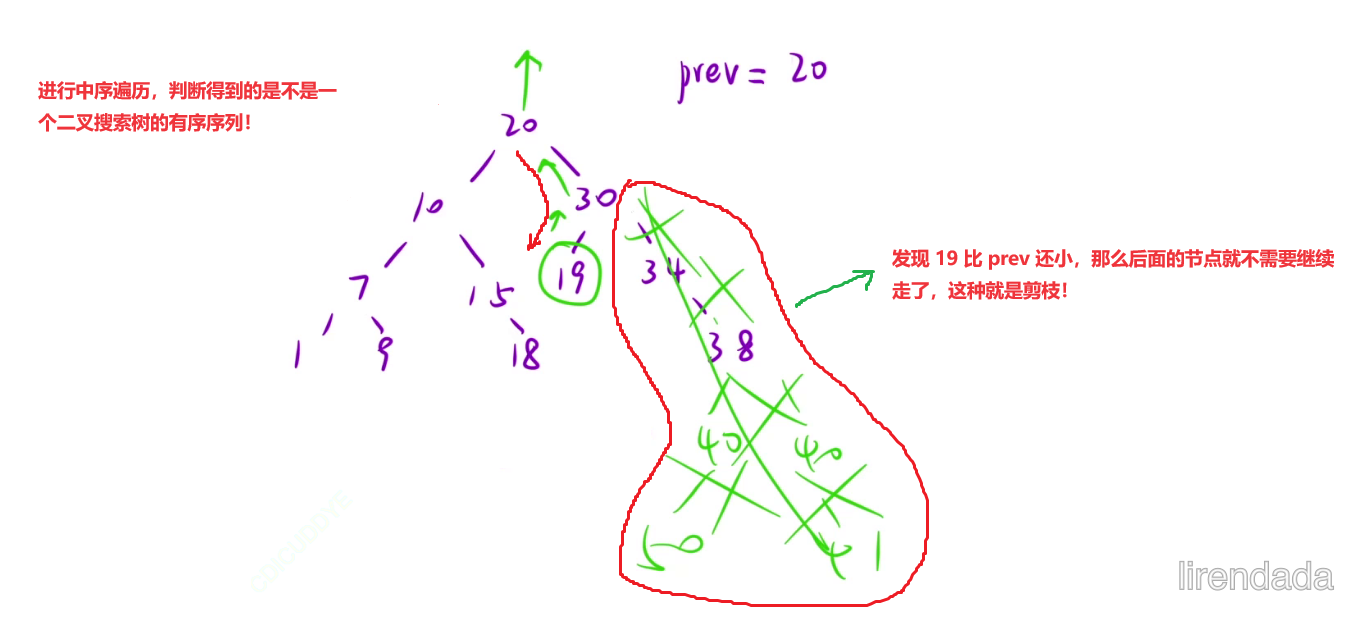
并且在递归处理左右子树的时候,也是可以直接判断一下左右子树返回的时候是否为 true,如果为 false 的话说明左右子树已经出现不匹配的情况了,则没必要继续往后走了,直接 return false,就又是剪枝操作,其实很简单的!
还有一个细节,就是 prev 变量需要范围大于 int 类型,因为这道题的节点数值范围是 INT_MIN ~ INT_MAX,如果我们用 INT_MIN 赋值给 prev 的话,此时如果二叉树中有多个 INT_MIN 的话,就会造成下面代码的逻辑错误,所以下面代码中将 prev 变量声明为 long 类型!
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
private:
    long prev = LONG_MIN; // 表示前驱节点的节点值,这里要用long类型,防止INT_MIN与题干中出现的INT_MIN比较而导致的逻辑错误
public:
    bool isValidBST(TreeNode* root) {
        // 递归函数出口
        if(root == nullptr)
            return true;

        // 先递归处理左子树
        if(isValidBST(root->left) == false)
            return false; // 剪枝

        // 再处理当前节点
        if(prev >= root->val)
            return false; // 剪枝
        prev = root->val;

        // 最后处理右子树
        if(isValidBST(root->right) == false)
            return false; // 剪枝

        return true;
    }
};